Python与Pandas解决文件读写中文乱码的方法
本文介绍Python及Pandas在处理文件读写时遇到的编码问题。通过记事本另存为UTF-8,或在Pandas中指定encoding参数(如gb2312),可有效解决Excel打开或写入时的中文乱码现象。
2026-10-13
6

本文介绍Python及Pandas在处理文件读写时遇到的编码问题。通过记事本另存为UTF-8,或在Pandas中指定encoding参数(如gb2312),可有效解决Excel打开或写入时的中文乱码现象。
本文详细介绍Python中CSV文件与List列表相互转换的实现方法。通过示例代码展示如何读取CSV文件内容并分割为二维列表,以及如何将列表数据按指定格式写入CSV文件。代码包含异常处理与文件关闭机制,适用于基础数据处理场景。
本文介绍在Python中按行读取文件内容时,如何有效去除每行末尾的换行符\n。通过file.readlines()遍历文件,并利用strip()方法清理空白字符,实现数据的整洁处理。
本文总结Python 2.7环境下处理中文编码的实用技巧。通过设置默认编码、使用unicode函数处理文件路径,以及利用codecs模块写入BOM头,可有效解决文件名及Excel打开时的中文乱码问题。
本文详解Python3中open函数的newline参数在读写文件时的行为差异。读取时,None将统一转为\n,空字符串保留原样;写入时,None自动转换为系统默认换行符,其他值控制具体转换逻辑。结合GBK与UTF-8编码异常处理及Makefile修改案例,提供实用的文件操作方案。
本文详解如何使用Python统计文件中单词出现频率并提取高频词。内容涵盖Python2与3的文件读写兼容、正则表达式提取单词、字典数据结构应用及sorted函数排序技巧。同时对比手动实现与collections.Counter模块,提供完整代码示例与最佳实践建议。
本文介绍如何在Python中使用NumPy高效查找数组的最大值与最小值,包括获取极值位置的方法。同时详细讲解Python文件系统的常用操作,涵盖文件与文件夹的复制、移动、重命名、删除及目录创建等核心功能,提供基于shutil和os模块的实用代码示例。
本文介绍Python中逐行读写TXT文件的方法。通过示例展示如何以不同模式(如w、a、r+等)打开文件,并演示逐行读取与写入的具体代码实现。
本文介绍如何在Python中实现读取Properties配置文件的功能。虽然Python标准库未直接提供该操作,但通过自定义类可轻松实现。文章包含完整代码示例及调用方法,帮助开发者快速掌握相关技巧。
本文介绍了一种在 Python 中删除指定字符的简洁方法。通过遍历文件内容并跳过目标字符,实现高效过滤。示例代码展示了如何去除字符串中的斜杠符号,适用于多种文本处理场景,无需依赖复杂正则表达式。
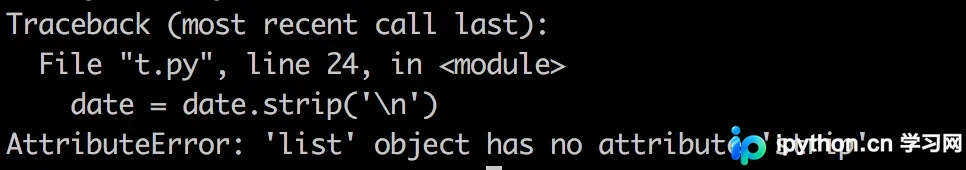
本文介绍在Python中使用readlines读取文件时,如何有效去除每行末尾的换行符\n。通过对比join+strip、splitlines以及逐行strip三种方法,分析其适用场景与注意事项,帮助开发者选择最合适的字符串处理方案。
本文详细介绍Python中readlines()方法的使用。该方法用于读取文件直至结束符EOF,返回包含所有行的列表,便于通过for循环处理。文章提供了Python 2与Python 3环境下的具体代码实例,演示如何打开文件、逐行读取并关闭文件,帮助开发者掌握文件内容的高效读取技巧。