Python Elasticsearch 索引创建与数据写入全流程指南
本文详细介绍如何使用 Python 操作 Elasticsearch,涵盖从初始化客户端、创建带映射的索引、单条与批量数据写入(含自动生成 ID 与指定 ID),到数据的删除、单条查询、全量检索及关键词匹配查找的完整流程。文中特别指出了嵌套对象写入时的常见错误及修正方法,并提供相关代码示例供参考。
2026-10-13
6


本文详细介绍如何使用 Python 操作 Elasticsearch,涵盖从初始化客户端、创建带映射的索引、单条与批量数据写入(含自动生成 ID 与指定 ID),到数据的删除、单条查询、全量检索及关键词匹配查找的完整流程。文中特别指出了嵌套对象写入时的常见错误及修正方法,并提供相关代码示例供参考。
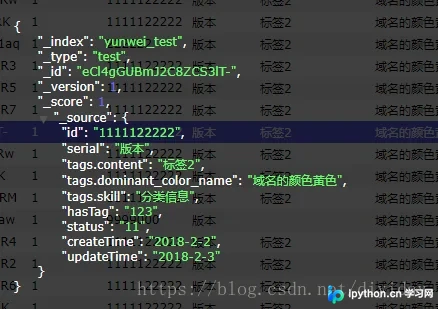
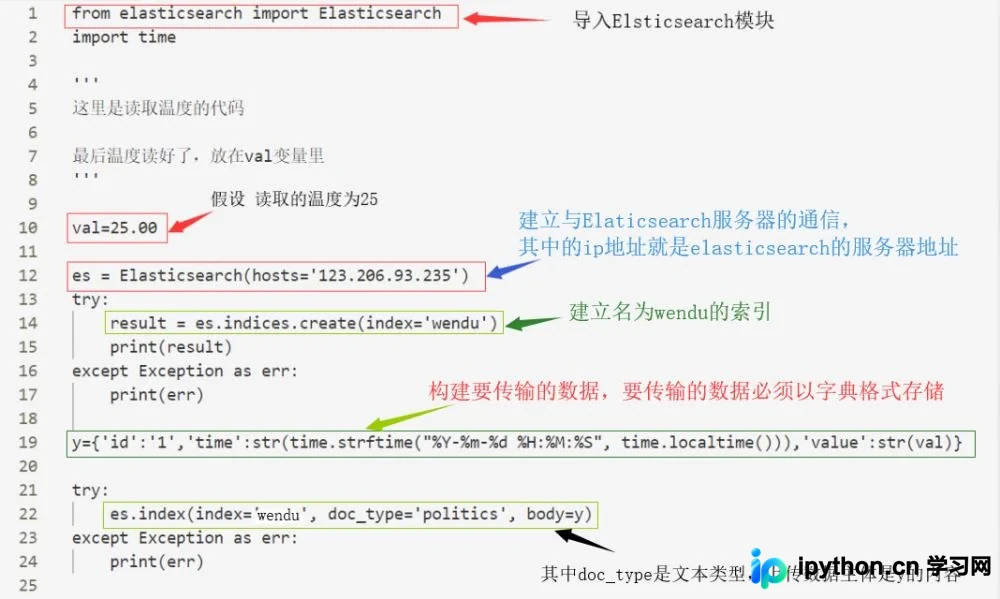
本文介绍如何使用Python脚本连接Elasticsearch,完成索引建立及数据上传。通过具体代码示例,展示利用elasticsearch库进行索引创建、文档写入以及使用match_all和get方法进行数据检索的完整流程,帮助开发者快速掌握ES基础操作。
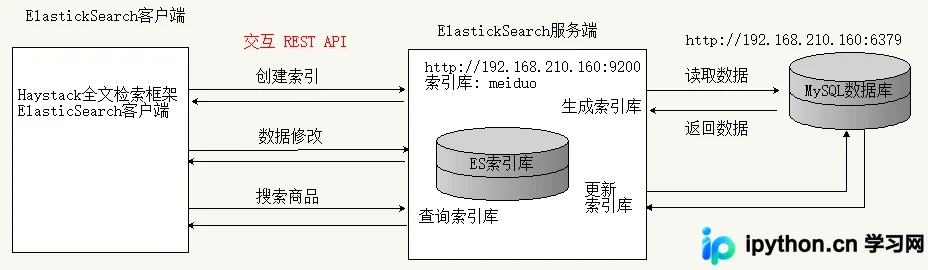
本文详解如何在Django项目中利用Haystack框架对接Elasticsearch,解决海量数据下的商品搜索性能瓶颈。内容涵盖Elasticsearch服务端搭建、IK分词器配置、索引类定义及DRF视图集成,提供从环境部署到API调用的完整实现方案。
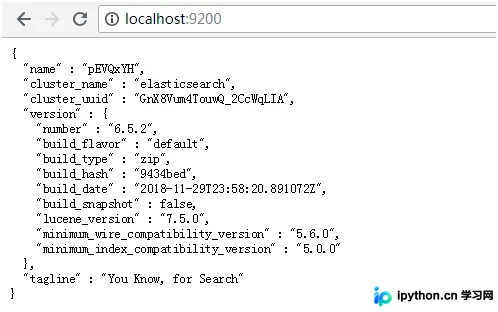
本文详细介绍如何在Python环境中将JSON文件数据写入Elasticsearch数据库。内容涵盖从安装Java环境、部署Elasticsearch 6.5.2版本,到配置Head插件进行可视化管理的全过程。同时提供完整的Python脚本示例,演示如何利用elasticsearch库和helpers.bulk方法高效批量导入数据,适合需要处理大量JSON数据的开发者参考。
本文介绍如何使用 Python 连接 Elasticsearch 并提取指定索引在特定时间段内的数据。通过构建包含时间范围(range)和字段匹配(term)的布尔查询 DSL,可精确筛选数据。示例展示了如何设置起始与结束时间、时区及过滤条件,并执行搜索获取结果。
本文介绍如何使用Python通过elasticsearch库批量获取超过10000条文档数据。核心思路是基于唯一字段升序和时间戳降序,先取前10000条,记录最后时间戳,后续查询利用该时间戳过滤,循环直至无数据返回,实现高效分页。
本文介绍利用Python通过pykafka消费Kafka数据,并批量插入Elasticsearch的方法。针对Kafka 0.8版本,使用get_simple_consumer确保多应用不重消费。通过设置consumer_timeout_ms避免阻塞,并配合死循环持续处理。当数据达到阈值时,利用bulk接口批量写入ES,适用于高并发数据场景。
本文介绍在Python中利用elasticsearch库从Elasticsearch集群获取数据并实现分页显示的具体方法。通过计算总条数确定页数,利用xrange优化循环性能,并设置from和size参数执行搜索。需注意该方法适用于数据总量不超过1万条的场景,超出可能导致错误。
本文介绍一种使用Python将MySQL数据同步至Elasticsearch的轻量级方案。针对Logstash-input-jdbc同步频率低的问题,该方案通过读取MySQL更新字段的时间戳进行增量查询,并设定10秒同步间隔。通过对比上次同步时间与当前时间解决服务器时间差,利用MySQL ID作为ES ID避免重复,确保数据同步的实时性与完整性。
本文介绍使用Python将本地文本数据批量导入Elasticsearch的方法。通过读取UTF-8编码文件,利用elasticsearch.helpers.bulk接口进行批量提交,可有效提升导入速度至每秒2000多条记录。文中提供了完整代码示例及编码处理注意事项,适用于需要高效数据同步的场景。
本文介绍如何使用Go语言和elastic/v7库编写一个Elasticsearch索引清理工具。通过读取配置文件获取ES地址、保留天数及日期格式,程序自动匹配并删除过期的旧索引,支持多集群管理,解决SkyWalking等链路追踪系统带来的存储膨胀问题。
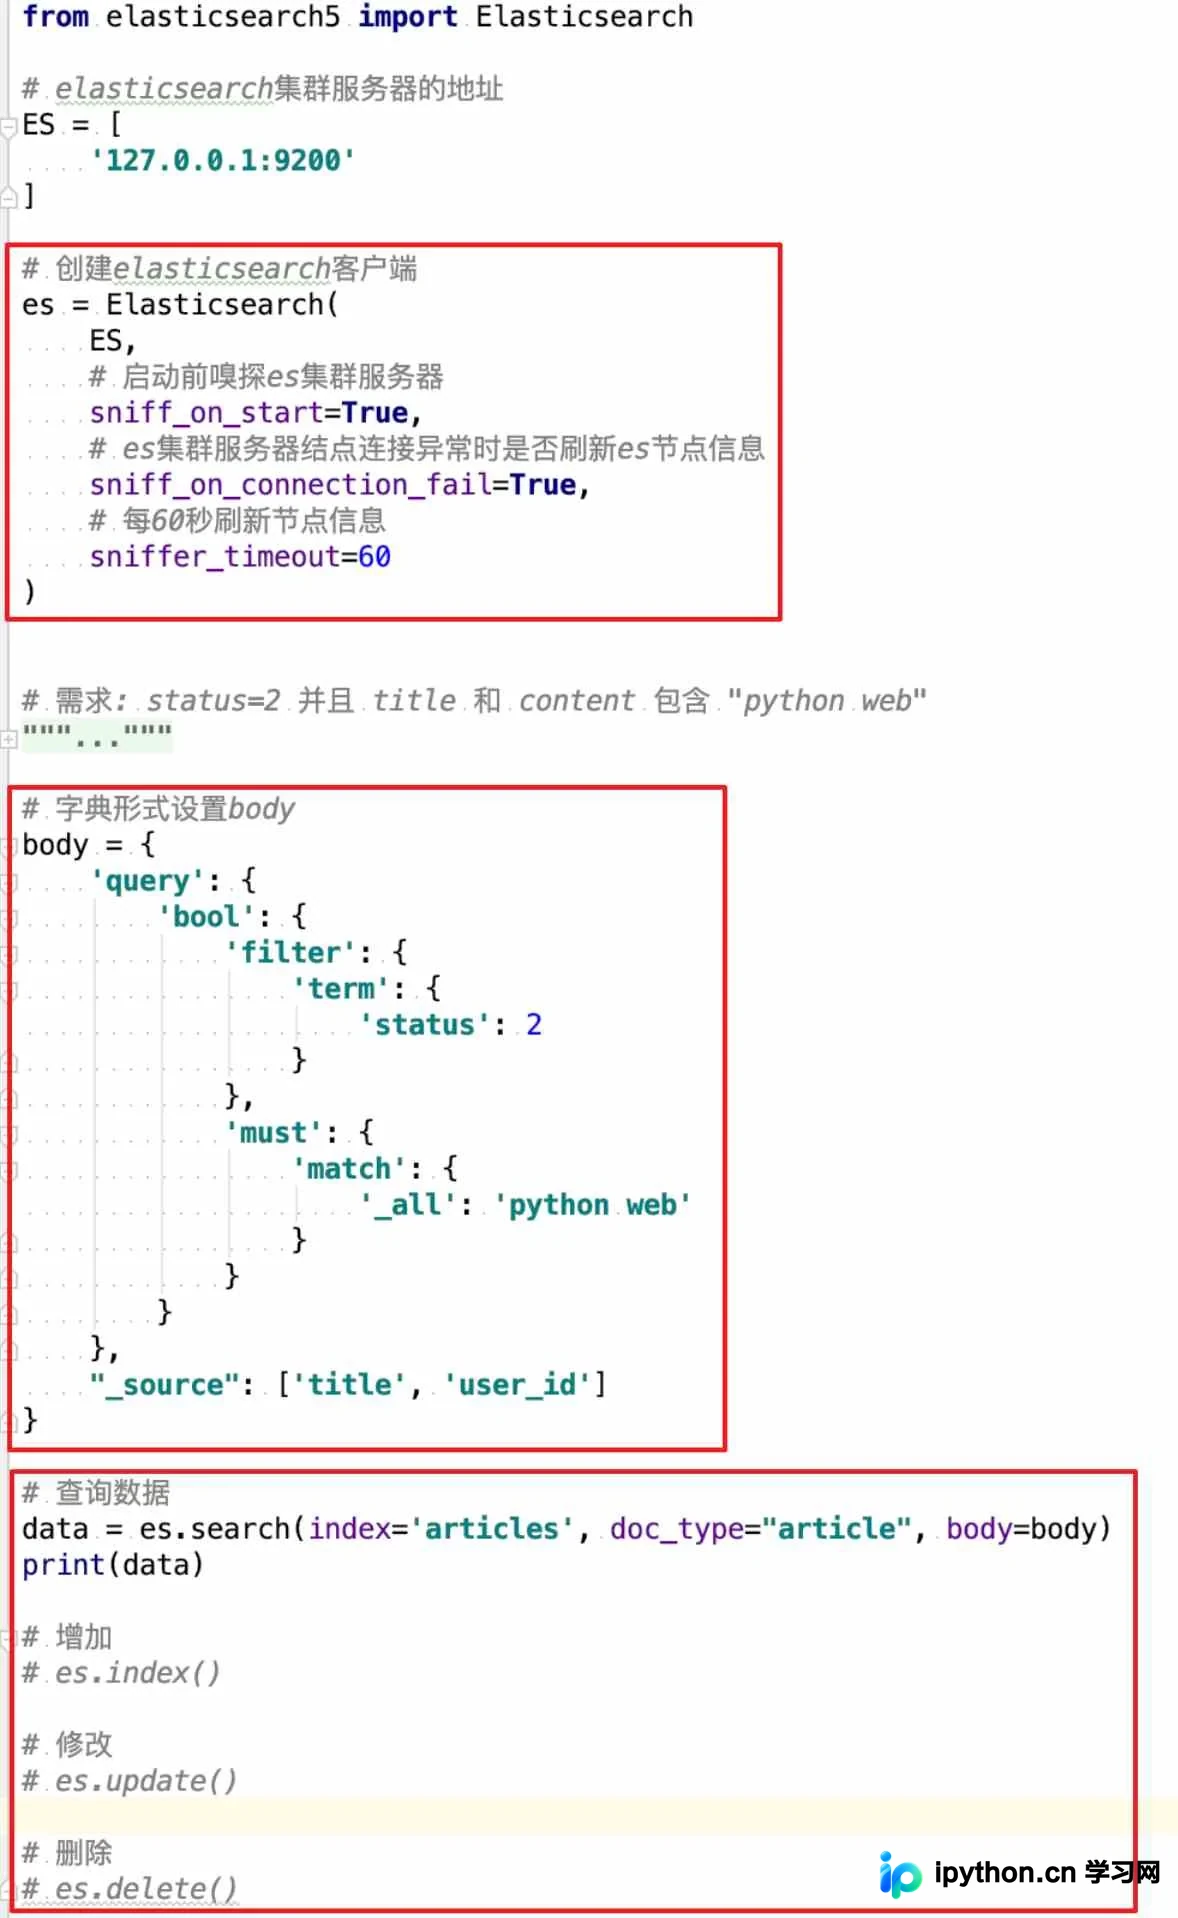
本文详细介绍如何使用Python操作Elasticsearch。内容涵盖模块安装、ES客户端对象的创建配置,以及具体的数据搜索和添加示例。通过代码演示,帮助开发者快速掌握基于Python进行ES交互的核心步骤,适用于需要集成搜索引擎功能的项目场景。