

MySQL海量数据水平切分与分布式访问架构设计

面对日均数十亿PV带来的负载压力,传统单点MySQL难以支撑。文章介绍了一种基于ORM层的分布式数据访问方案,通过水平切分降低单节点I/O限制,结合集群化、读写分离及负载均衡策略,实现低成本下的高并发与高可用存储。
背景与挑战
随着互联网应用的普及,海量数据的存储与访问成为系统设计瓶颈。对于大型应用,单一的MySQL数据库往往难以承受高并发查询与写入的压力,直接威胁系统的稳定性与扩展性。水平切分(Sharding)已成为提升网站性能的首选方式,其核心价值在于:
- 降低负载:将数据分散到多台服务器,避免单点过载。
- 提高可用性:通过集群与负载均衡,减少宕机影响范围,消除单点故障。
- 横向扩展:无需昂贵的高端硬件,利用廉价Server即可线性增长处理能力。
基本原理:数据切分与路由
第1步:理解水平切分概念
目的:突破单节点I/O能力限制。
原理:Sharding不依赖特定数据库软件功能,而是软件层面的抽象处理。通过切分规则,将数据水平分布到不同的DB或Table中,再通过DB路由或
Table路由规则定位具体数据进行Query操作。
第2步:确定切分依据(Sharding Key)
入口:分析业务实体关系。
动作:在表中增加冗余字段作为区分依据。例如在Blog应用中,使用 user_id 作为分库键。
- 切分示例:设定规则,
user_id1~10000的数据存入 DB1,10001~20000存入 DB2,以此类推至 DBn。 - 路由过程:当需要查询
user_id=234的文章时,根据上述规则反向计算,路由定位至 DB1 执行操作。
第3步:选择切分规则
常见三种模式及对比:
- 号段分片:按ID范围分配(如1-1000->DB1)。优点是可部分迁移;缺点是数据分布可能不均。
- Hash取模:对区分字段 Hash后取模(如
user_id % 4)。优点是数据分布均匀;缺点是在扩容时迁移数据复杂,无法按机器性能分摊。 - 配置库映射:建立独立DB保存 ID 到 DB 的映射关系。优点灵活性高;缺点是每次查询多一次IO,性能下降。
架构设计:集群与高可用
第4步:引入集群(Group)概念
目的:解决单节点宕机导致的数据不可用问题,提升容错性。
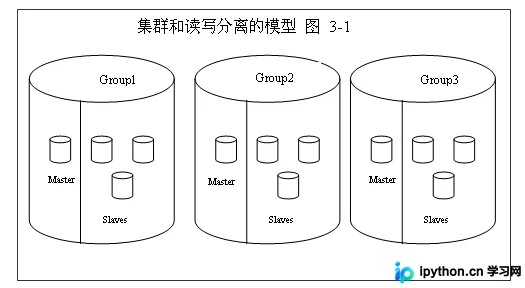
动作:每个逻辑分库节点(Group)内部包含 1个 Master 和 N个 Slave。
- 读写分离:Master负责所有写操作,N个Slave分担读操作。互联网应用中读写比通常约为 10:1,此结构极大提升读取效率。
- 锁机制优化:将写操作集中在Master,避免行锁/表锁对读操作的性能损耗。
第5步:实施负载均衡(LoadBalance)
目的:在Group内智能分发请求至具体物理服务器。
策略:
- 读写分流:写请求强制路由至 Master;读请求由负载均衡器分配至 Slave。
- 分发算法:
- 随机负载均衡:不考虑性能差异,简单随机选取。适用于配置一致的节点。
- 加权负载均衡:为每台DB服务器分配权值,LB根据权重比例分发负载。适用于硬件性能参差的场景,防止弱机宕机,充分利用高性能机器。
第6步:部署节点可用性探测
风险提醒:若LB unaware节点已宕机,仍会分配请求,导致客户端报错。
动作:引入心跳检测或状态推送机制,实时监控集群节点健康度。
- 主动探测:客户端定时尝试连接各数据库端口或JDBC链接,通过异常捕获判断状态。
- 被动推送:DBA发现故障后,通过接口主动通知客户端更新本地节点状态列表,暂停对该节点的分发。
技术选型与设计实现
第7步:ORM层封装实现
目标:在不侵入原有代码的前提下,实现对下层数据库的透明切分。
选型理由:相比JDBC层封装(开发难度极高),本方案基于成熟的轻量级ORM框架(如 iBatis/Spring)。利用配置文件 sql-map.xml 在原生的SQL层面进行映射配置,既保证了优秀DBA对SQL调优的控制力,又降低了集成复杂度。
第8步:系统集成要素
- IoC容器:使用 Spring 管理对象依赖,降低耦合。
- 关键组件:分库规则引擎、路由中心、负载均衡器、心跳检测模块。
总结
MySQL的水平切分与分布式架构并非简单的分表,而是一套包含路由规则、集群管理、负载均衡及高可用监控的综合解决方案。通过合理的 Sharding Key 设计与集群化部署,开发者可以用廉价的PC Server集群达到高端小型机的效果,有效应对海量数据带来的存储与访问挑战。
以上就是MySQL海量数据存储和分布式访问架构设计的详细内容,更多关于MySQL分库分表与实践优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









