Scrapy爬虫生产环境部署完整指南:Scrapyd与ScrapydWeb实战
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
2026-10-15
7


本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
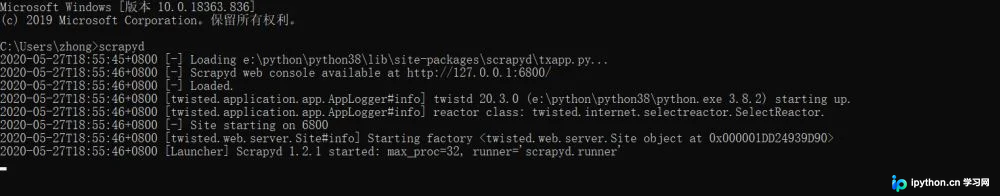
本文详细介绍在 CentOS 系统中如何配置 Python 脚本的自动运行及定时任务。内容涵盖编写日志写入脚本、安装与启动 crond 服务、理解 crontab 命令格式(分、时、日、月、周、命令)、使用 crontab -e 和修改 /etc/crontab 两种添加任务的方式,以及重启服务、查看状态和权限检查等完整操作步骤。
本文详细讲解如何在Linux服务器上使用Anaconda管理Python环境,并通过uWSGI与Nginx完成Django项目的生产环境部署。内容涵盖虚拟环境创建、uWSGI配置文件编写、Nginx反向代理设置以及HTTPS SSL证书的配置步骤,帮助开发者实现高效稳定的Web服务上线。
本文详细介绍如何在PyCharm中配置远程Linux开发环境。通过设置文件传输服务器、建立SSH连接、映射本地与远程路径,以及添加SSH解释器,实现本地编辑与远程执行的无缝对接。
本文详细介绍如何在Python中配置国内pip镜像源,包括清华大学、阿里云和豆瓣等推荐源。内容涵盖Windows和Linux平台下的临时使用命令与永久配置文件设置方法,以及常见报错处理,帮助用户加速包下载。
本文详解 Selenium 在 Python 中的核心组件(WebDriver、IDE、Grid)及工作原理,涵盖从环境准备、pip 安装、镜像源配置到 Chrome 和 Firefox 驱动下载及环境变量配置的完整步骤,并解决虚拟环境及路径配置等常见报错问题。
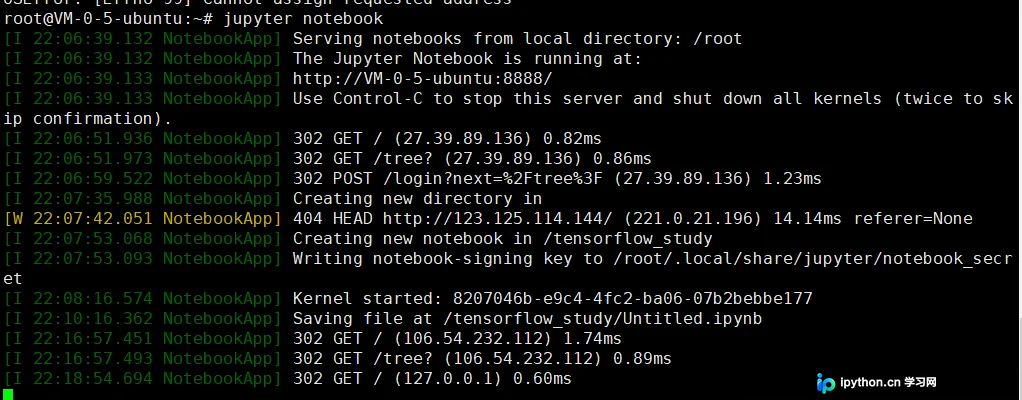
本文详细介绍在Linux服务器上部署Jupyter Notebook的完整流程。涵盖从创建Python虚拟环境、安装TensorFlow与Jupyter依赖,到配置jupyter_notebook_config.py以允许远程访问,以及关闭防火墙确保端口可达的具体操作步骤。此外,还补充了通过本地隧道连接服务器的替代方案,帮助用户实现本地浏览器远程调用服务器算力。
本文介绍在Ubuntu系统中使用Python matplotlib时,如何安装Windows字体以解决字体缺失报错,并通过修改rcParams配置实现中文字体显示。
本文介绍如何利用Python自动化获取Nginx访问日志以判断任务执行状态。通过结合subprocess调用tail命令与多线程机制,实时捕获特定特征内容。文中详细分析了直接grep过滤无法获取日志的原因,并针对proc.communicate超时及timeout参数设置过小导致的二次获取失败问题提供了实践建议,旨在提升运维与测试效率。
本文详细介绍使用Python语言在Linux环境下实现简易群聊室的完整方案。系统基于UDP协议,利用socket模块进行网络通信,并通过多进程(fork)技术分别处理消息发送与接收。核心功能包括用户登录验证、群消息转发、管理员公告广播及用户进出通知。文章提供了服务端与客户端的核心代码逻辑,解析了消息类型(L/C/Q)的处理机制及进程间协作模式,适合Python网络编程初学者参考学习。
本文详细介绍在 Linux/Unix 及 Windows 系统中安装 Python3 解释器的方法,包括设置环境变量、启动交互式编程环境以及创建并执行 Python 脚本文件。内容涵盖路径配置、权限设置及基础命令操作,帮助开发者快速上手 Python3 环境。
本文介绍如何使用Python的crypt模块模拟Linux密码加密机制,通过读取/etc/shadow文件提取盐值和哈希值,结合密码字典进行暴力破解。文章详细解析了SHA-512等哈希算法格式,并提供了完整的Python脚本代码及运行示例,适用于Kali Linux环境下的安全测试。