Scrapy结合scrapy_redis实现分布式爬虫部署详解
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。
2026-10-14
6

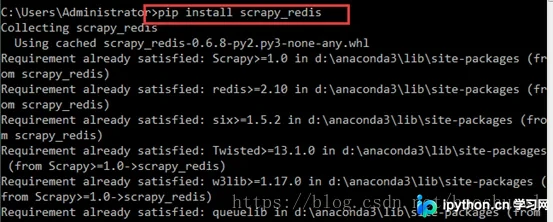
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。
本文详细解析Python在服务器部署时常见的ModuleNotFoundError报错原因,重点介绍利用sys.path.append()和sys.path.insert()动态修改搜索路径的方法。通过具体代码示例,说明如何确保服务器正确识别本地自定义包,解决因路径差异导致的模块导入失败问题。
在Web开发中,准确获取服务器端的运行环境信息对于排查兼容性问题及优化性能至关重要。本文提供一段实用的PHP函数代码,能够自动检测当前操作系统的类型、PHP核心版本、Apache服务版本、Zend引擎版本、GD图像处理库的支持情况,以及内存限制、文件上传大小上限和全局变量注册等关键配置项。开发者可直接将该代码嵌入项目中,快速输出服务器环境的详细清单,确保应用部署前的环境符合预期要求。
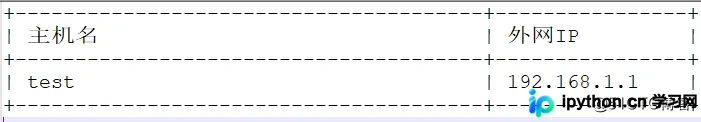
本文介绍如何使用Python3编写脚本,通过调用资产信息接口获取JSON数据,并利用prettytable库将主机名和外网IP等信息格式化为表格打印输出。脚本支持通过命令行参数指定查询名称,适用于服务器运维场景下的资产信息查询。
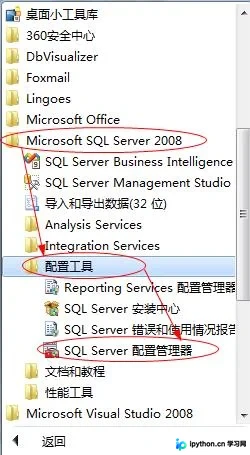
解决 Windows 上打开 SQL Server Management Studio (SSMS) 时出现的“Error 40: 无法打开连接”或 Visual Studio “Error 26: 定位服务器实例出错”。通过 SQL Server Configuration Manager 启动 TCP/IP 协议,设置标准端口 1433,并重启服务即可恢复本地或远程连接。
介绍如何在 PHP 项目中通过封装 sysdebug 和 syserror 函数,实现自动按日期归档、包含调用堆栈信息的轻量级日志记录。sysdebug 支持通过常量开关控制输出,syserror 无条件记录异常,两者均能自动生成文件目录并追加写入,便于快速定位开发与发布阶段的问题。
本文详细讲解在CentOS 7.5环境下,使用Nginx与uWSGI部署Django项目的完整流程。涵盖Python虚拟环境搭建、uWSGI配置、Nginx反向代理设置及静态文件处理。通过具体命令和配置文件示例,帮助开发者解决部署中的常见报错,实现从代码上传到服务启动的全流程自动化部署。
本文介绍如何使用 Go 语言标准库在几分钟内搭建一个简单的 HTTP 文件服务器。通过结合 net/http 包中的 FileServer 和 Dir 函数,只需几行代码即可将指定目录暴露为可访问的静态资源站点,适合用于本地开发调试或临时共享文件。
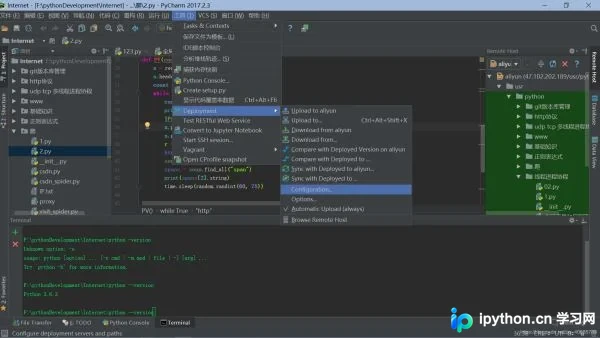
本文详细介绍如何在 PyCharm 中配置远程服务器连接,实现本地代码与远程 Linux 服务器的自动同步。涵盖 SFTP 部署配置、远程解释器添加、路径映射设置以及 Automatic Upload 开启方法,帮助开发者在 Windows 环境下高效进行远程调试与代码更新。
本文详细介绍在Linux服务器环境下搭建Python多版本管理、配置Jupyter Notebook远程访问以及集成PySpark进行Web端Spark开发的完整流程。内容涵盖使用pythonbrew管理Python版本、生成SSL证书与密码以安全远程连接Jupyter,以及配置环境变量启动pyspark-jupyter,助力数据分析师实现高效、优雅的远程编程体验。
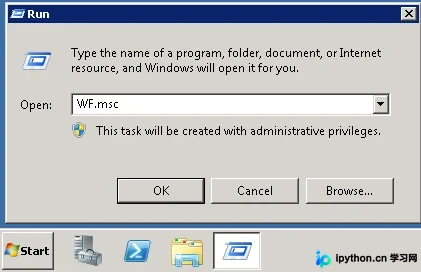
本文详解如何解决在 Azure 虚拟机部署 SQL Server 后无法通过 IP 访问的问题。核心原因是 Windows 防火墙默认拦截外部连接。文章提供了完整的图文操作步骤,指导用户通过 WF.msc 打开“高级安全 Windows 防火墙”,新建“端口”类型的入站规则,允许 TCP 1433 端口连接,从而恢复数据库远程访问能力。
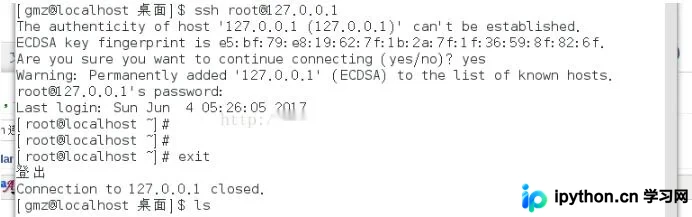
本文详细介绍如何利用Python的pexpect模块实现SSH远程登录服务器。通过对比基础pexpect连接与更简便的pxssh模块,演示了处理首次连接确认、密码输入及命令执行的全过程。此外,文章提供了基于pxssh的批量连接脚本示例,适用于自动化运维场景,帮助开发者高效管理多台服务器。