

SQL Server 2005 中一次性压缩所有数据库日志的存储过程
本文提供适用于 SQL Server 2005 的存储过程,通过游标(Cursor)遍历系统数据库列表,依次将各库恢复模式设为 Simple 并执行 DBCC SHRINKDATABASE,最后恢复为 Full 模式。该方法可一次性批量收缩所有用户数据库的事务日志,解决单库操作效率低的问题。
2026-10-15
7

本文提供适用于 SQL Server 2005 的存储过程,通过游标(Cursor)遍历系统数据库列表,依次将各库恢复模式设为 Simple 并执行 DBCC SHRINKDATABASE,最后恢复为 Full 模式。该方法可一次性批量收缩所有用户数据库的事务日志,解决单库操作效率低的问题。
本文详细介绍 MySQL 慢查询日志的配置方法、核心参数含义及生效机制,涵盖文件与表两种存储方式。同时深入解析 mysqldumpslow 分析工具的常用命令,帮助数据库管理员快速定位性能瓶颈,优化 SQL 执行效率。
本文详细讲解 MySQL binlog 日志的三种清理方式:通过修改配置文件关闭 binlog;设置 expire_logs_days 参数实现自动过期删除;以及使用 PURGE MASTER LOGS 或 RESET MASTER 命令手动删除特定日期前的日志或重置所有日志。重点提示了手动操作对主从复制的影响及备份建议。
本文详解如何通过MySQL自带的慢查询日志功能定位执行缓慢的SQL语句。涵盖启用日志、设置阈值(long_query_time)、查看日志文件及解析关键字段的方法,并补充了pt-query-digest等高效分析工具的使用场景,帮助DBA快速识别并优化数据库性能瓶颈。
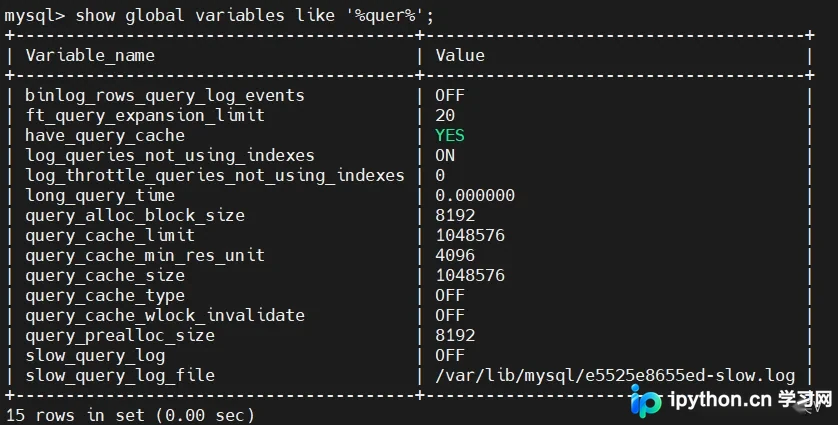
本文介绍SQL Server ErrorLog文件的存储机制与管理方法。默认保留7个日志文件,可通过DBCC ERRORLOG或sp_cycle_errorlog存储过程手动循环日志以释放空间。文章详述了日志轮转原理及操作风险,强调旧数据覆盖前需做好备份,并提供了相关的系统表查询与事务日志压缩的通用处理方法。
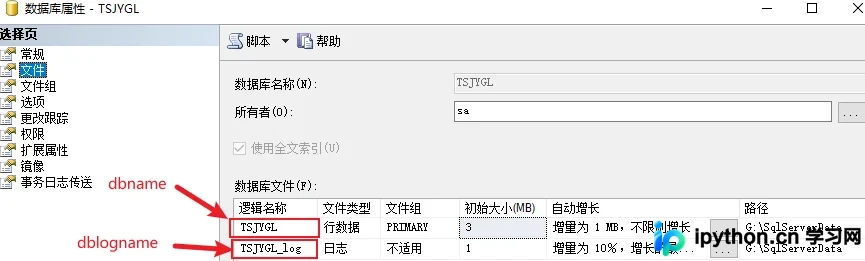
针对 SQL Server 日志文件 (.ldf) 占用过大磁盘空间的问题,本文提供通过修改数据库恢复模式并执行 DBCC SHRINKFILE 命令来释放未使用空间的详细方法。操作需切换至简单模式截断日志,收缩后再恢复完整模式,以兼顾空间回收与数据安全。
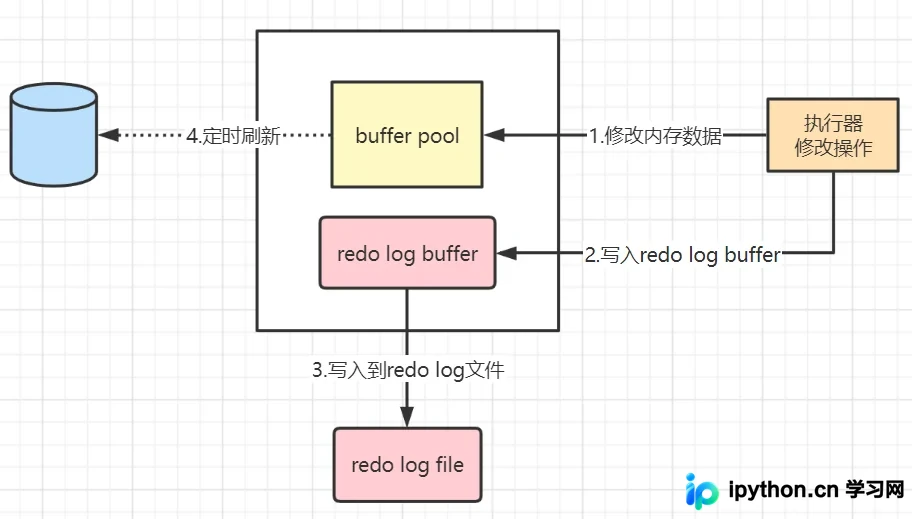
本文深入解析MySQL InnoDB引擎的两大核心日志:Redo Log保障事务持久性,通过WAL技术与刷盘策略平衡性能与安全;Undo Log实现事务原子性与MVCC多版本并发控制。同时详细阐述如何通过两阶段提交(2PC)协调Redo Log与Binlog,确保主从复制数据一致性。掌握这些底层机制是进行数据库调优与故障排查的基础。
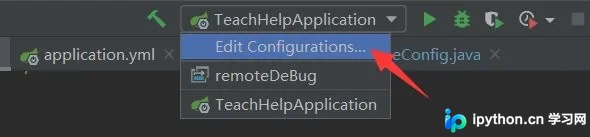
本文详细介绍如何在IDEA中配置远程Debug功能,以调试部署在腾讯云Tomcat服务器上的Spring Boot项目。内容涵盖IDEA Remote配置、服务器catalina.sh参数设置、防火墙端口开放及启动命令,确保本地与服务器代码一致,实现高效断点调试。
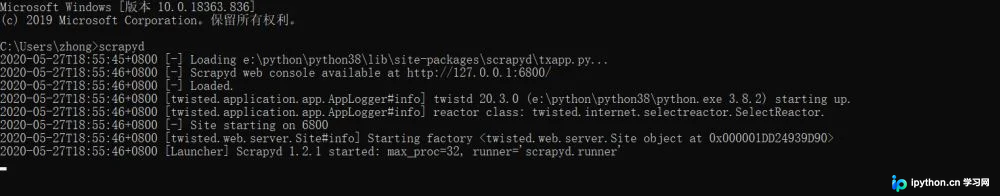
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
本文详细讲解如何在Linux服务器上使用Anaconda管理Python环境,并通过uWSGI与Nginx完成Django项目的生产环境部署。内容涵盖虚拟环境创建、uWSGI配置文件编写、Nginx反向代理设置以及HTTPS SSL证书的配置步骤,帮助开发者实现高效稳定的Web服务上线。
本文介绍如何利用Python自动化获取Nginx访问日志以判断任务执行状态。通过结合subprocess调用tail命令与多线程机制,实时捕获特定特征内容。文中详细分析了直接grep过滤无法获取日志的原因,并针对proc.communicate超时及timeout参数设置过小导致的二次获取失败问题提供了实践建议,旨在提升运维与测试效率。
本文详细介绍 Python3 调用 Kubernetes API 的完整流程。涵盖从安装 kubernetes 客户端库、配置 kubeconfig 认证,到通过 CoreV1Api 和 AppsV1Api 实现命名空间、Pod、Service 及 Deployment 的列出、创建、删除、查看与修改操作。提供基于 YAML 清单和直接代码调用的具体代码示例,帮助开发者快速掌握在 Python 中管理 K8s 集群资源的方法。