

Python 使用 PyMySQL 连接 MySQL 数据库完整指南
本文详细介绍如何在 Python 中通过 PyMySQL 库连接 MySQL 数据库。内容涵盖环境安装、基础连接配置,以及利用 cursor 对象执行 SELECT、INSERT、UPDATE 和 DELETE 等 SQL 语句的具体代码示例,并强调事务提交 commit() 的重要性,帮助开发者快速掌握数据库交互核心流程。
2026-10-15
7

本文详细介绍如何在 Python 中通过 PyMySQL 库连接 MySQL 数据库。内容涵盖环境安装、基础连接配置,以及利用 cursor 对象执行 SELECT、INSERT、UPDATE 和 DELETE 等 SQL 语句的具体代码示例,并强调事务提交 commit() 的重要性,帮助开发者快速掌握数据库交互核心流程。
pydbclib是一个Python通用关系型数据库操作工具包,通过统一接口支持Oracle、MySQL、PostgreSQL等多种数据库。它封装了SQLAlchemy、PyMySQL等驱动,统一使用':[name]'占位符,提供增删改查及表级操作功能,简化多数据库开发流程。
本文详细介绍如何使用 Python 的 Pymongo 库连接 MongoDB 数据库,并演示创建数据库、集合、插入、更新、查询及删除数据的具体代码实现。通过封装连接类与操作示例,帮助开发者快速掌握 Python 对 MongoDB 的基础数据操作。
本文详解如何使用Python的pymysql库更新数据库中的单个字段。通过连接数据库、定义游标及执行UPDATE语句,实现根据ID动态修改指定字段的值。文章包含完整的代码示例,涵盖输入处理、异常捕获及事务提交回滚机制,帮助开发者掌握数据库字段更新的核心操作。
本文详解Django项目中配置多个数据库的方法,包括通过DATABASE_ROUTERS实现App与数据库的绑定,以及使用using()指定读写库。同时涵盖Django 1.6至1.7+版本的数据库同步命令,以及针对多库环境的dumpdata导出与loaddata导入操作,确保数据在不同数据库间准确迁移。
本文详解Django中数据迁移的核心命令dumpdata与loaddata。介绍如何按App导出JSON数据,以及跨数据库迁移时的注意事项。针对大数据量或复杂关系导致的导入失败问题,提供清除迁移记录并重新生成迁移文件的推荐方案,以提升数据导入成功率。
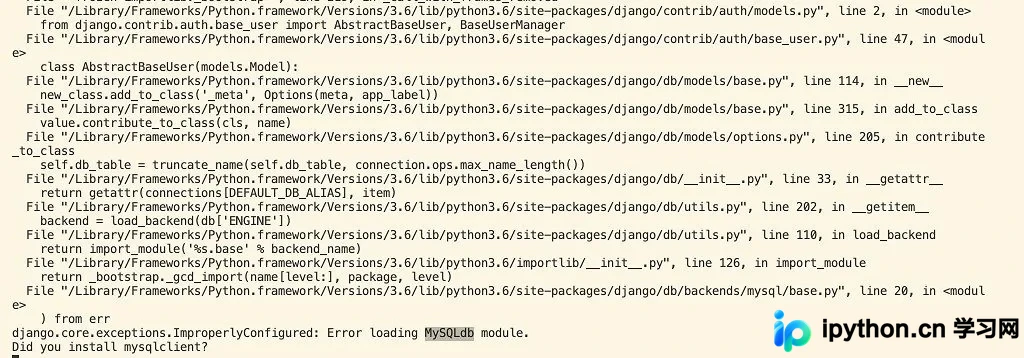
本文解决 Django 2.0 使用 MySQL 数据库时常见的两个启动错误。首先针对找不到 mysqlclient 模块的问题,通过在 __init__.py 中引入 pymysql 并调用 install_as_MySQLdb() 进行兼容处理;其次针对版本检查报错,通过注释 Django 源码中 base.py 文件的版本校验代码来绕过限制,确保项目正常启动。
本文提供基于Python的pymysql库操作MySQL数据库的完整脚本示例。内容涵盖数据库连接配置、数据查询(含fetchmany用法)、数据插入、更新及删除操作的具体代码实现,并展示了如何将查询结果写入Excel文件。适用于需要快速掌握Python与MySQL交互开发的开发者参考。
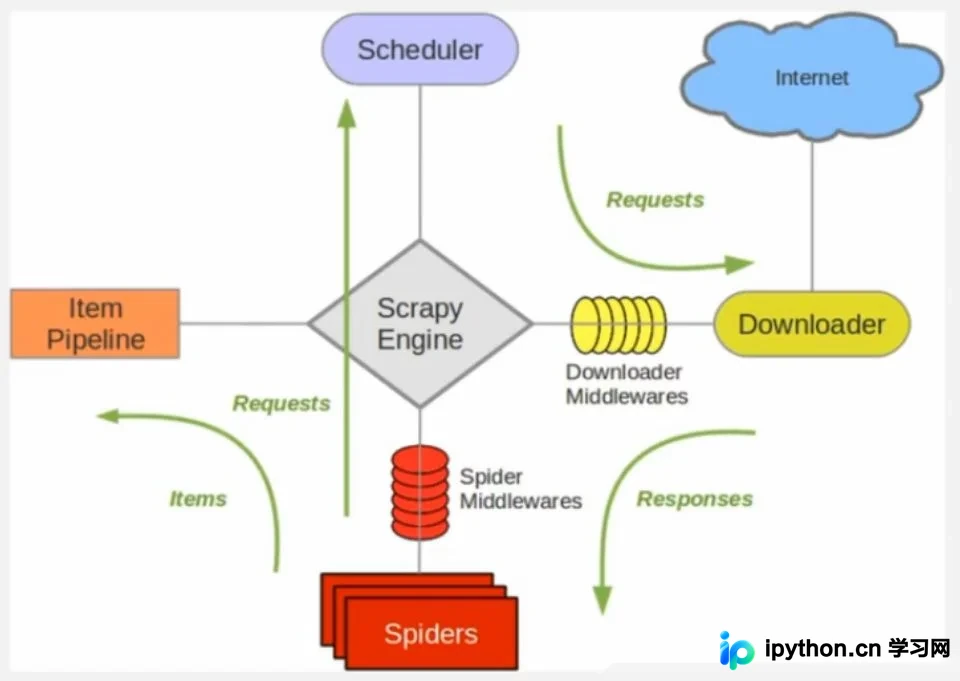
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
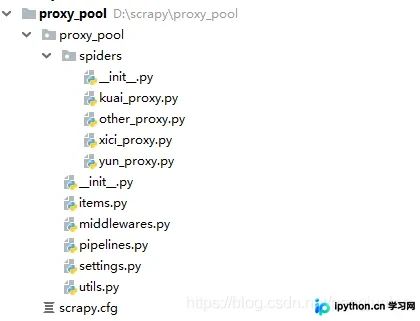
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
本文详细介绍如何使用Python通过pymysql库连接MySQL数据库。内容涵盖环境安装、连接参数配置、利用pandas read_sql及游标cursor两种方式读取数据,以及插入、更新、删除等事务处理与结果获取方法,帮助开发者快速实现数据库交互。