Python实战:2019中国好声音腾讯视频评论爬取与可视化分析
本文解析如何使用Python抓取2019年《中国好声音》第六期在腾讯视频的公开评论数据。通过逆向分析接口参数,实现分页评论、用户昵称及地区信息的自动化采集。随后利用jieba库进行中文分词,结合WordCloud生成主题词云,并通过Matplotlib绘制国内各地区参与用户分布直方图,完整展示从数据抓取到可视化分析的技术流程。
2026-10-13
6

本文解析如何使用Python抓取2019年《中国好声音》第六期在腾讯视频的公开评论数据。通过逆向分析接口参数,实现分页评论、用户昵称及地区信息的自动化采集。随后利用jieba库进行中文分词,结合WordCloud生成主题词云,并通过Matplotlib绘制国内各地区参与用户分布直方图,完整展示从数据抓取到可视化分析的技术流程。
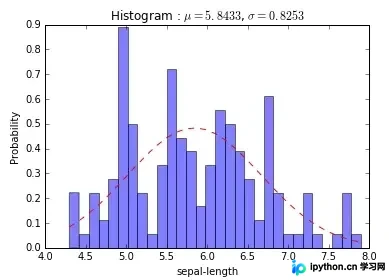
本文介绍在Python中为直方图添加拟合曲线的两种常用方法。首先通过matplotlib的mlab模块结合正态分布函数进行拟合,但需注意其局限性;其次推荐采用seaborn库的distplot函数,通过设置kde参数实现更贴合数据分布的核密度估计曲线,并支持自定义线条与柱状图样式。
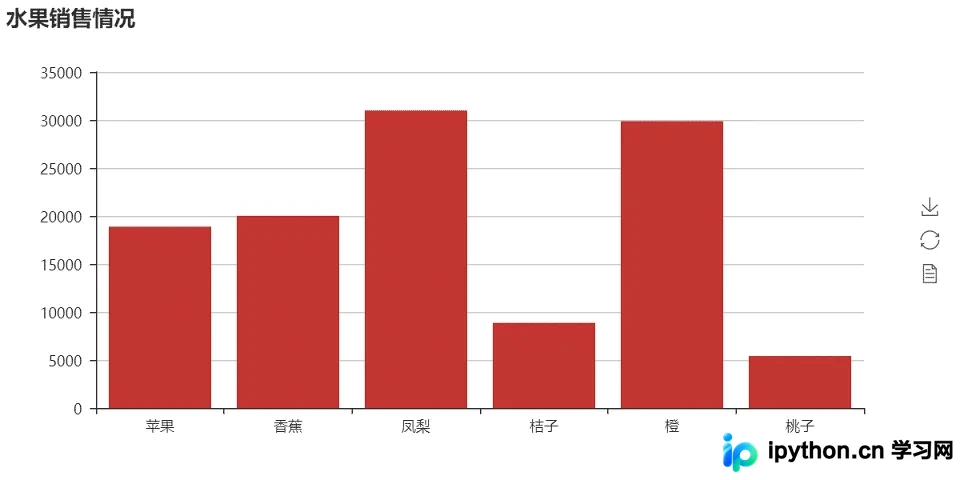
本文详细介绍如何使用Python库pyecharts生成多种统计图表。涵盖柱状图的叠加与横向显示、折线图的平滑与阶梯面积模式、饼图的玫瑰样式以及散点图的动态效果。通过具体代码示例,解析add、Line、Pie等核心类及is_stack、is_smooth等关键参数的用法,帮助开发者快速掌握数据可视化技能。
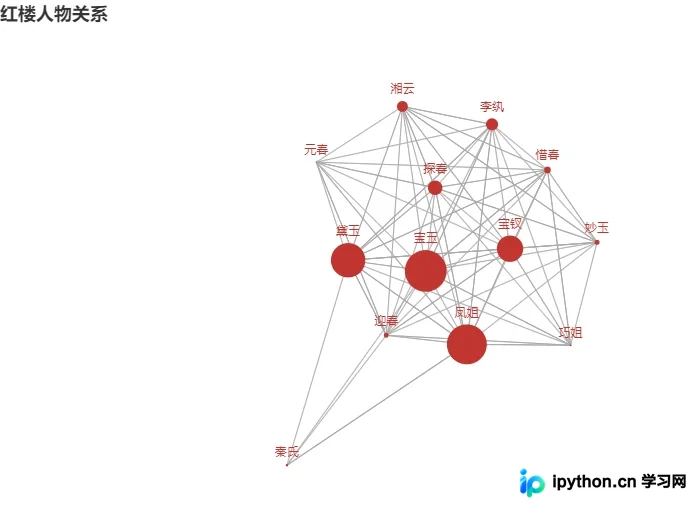
本文介绍如何使用Python对《红楼梦》文本进行数据处理与可视化。通过jieba库进行自定义词典分词,清洗文本并统计人物出场频率;利用共现算法构建人物关系网络,最后借助pyecharts生成直观的人物关系图谱,展示主要角色间的互动强度。
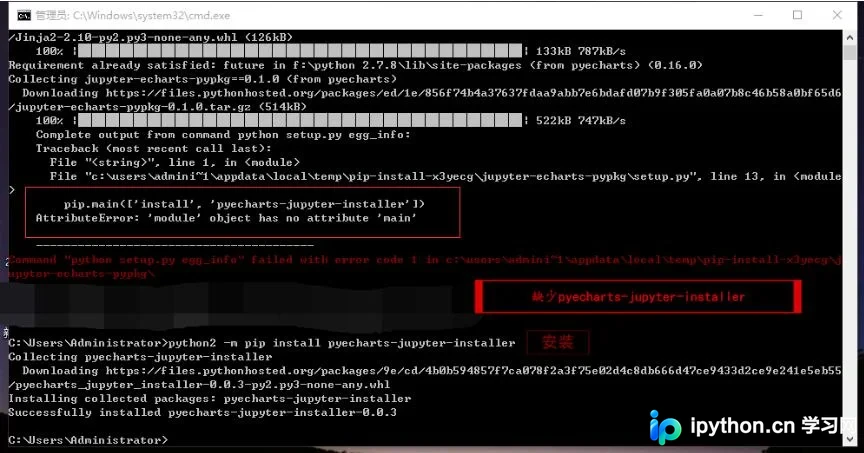
本文记录在Python环境中安装pyecharts时遇到的两个典型问题:一是缺少pyecharts-jupyter-installer依赖,二是安装MarkupSafe时因版本或权限导致的报错。通过单独安装.whl文件等方式解决依赖冲突,并附带Python 2与3共存时的pip命令区分技巧,帮助开发者顺利部署数据可视化组件。
本文介绍如何利用Django后端与ECharts前端库结合,实现从PLC采集数据的实时动态曲线展示。通过Django定时任务获取数据,前端使用AJAX异步请求获取最新数据,并借助setInterval定时刷新ECharts图表,确保页面不重载即可更新显示内容。
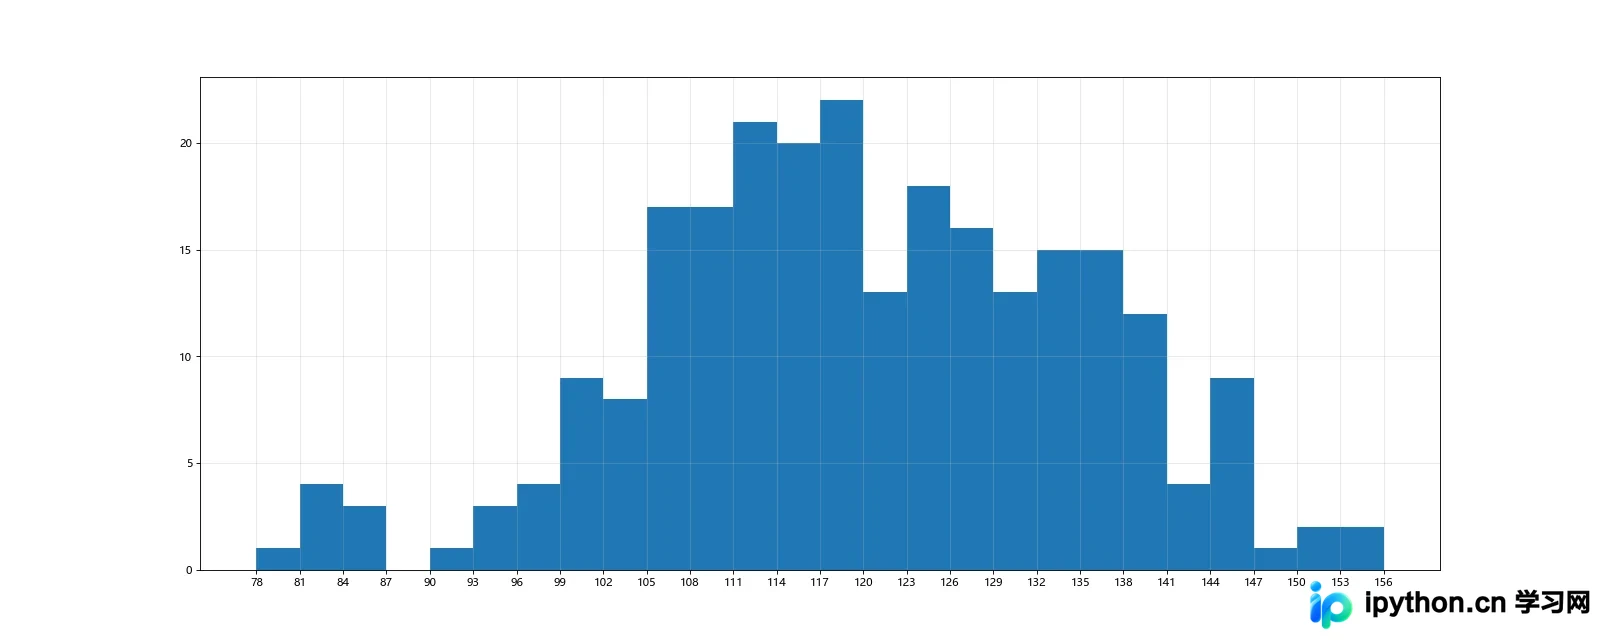
本文通过统计250部电影时长的实例,详解如何使用Python matplotlib库绘制频数分布直方图。重点讲解组距、组数的计算逻辑,以及plt.hist()函数的参数配置,包括如何设置中文显示、调整图片尺寸及网格透明度,帮助读者掌握数据分布可视化的核心技巧。
本文详解如何利用Python的Matplotlib库对时间序列数据进行可视化分析。内容涵盖从Tushare获取指数及股票数据,处理日期索引,绘制单序列折线图并自定义样式与细节。此外,还介绍了移动平均通道线的构建方法,以及通过面积图和子图布局实现多时间序列数据的对比展示,帮助读者掌握金融数据探索的核心可视化技巧。
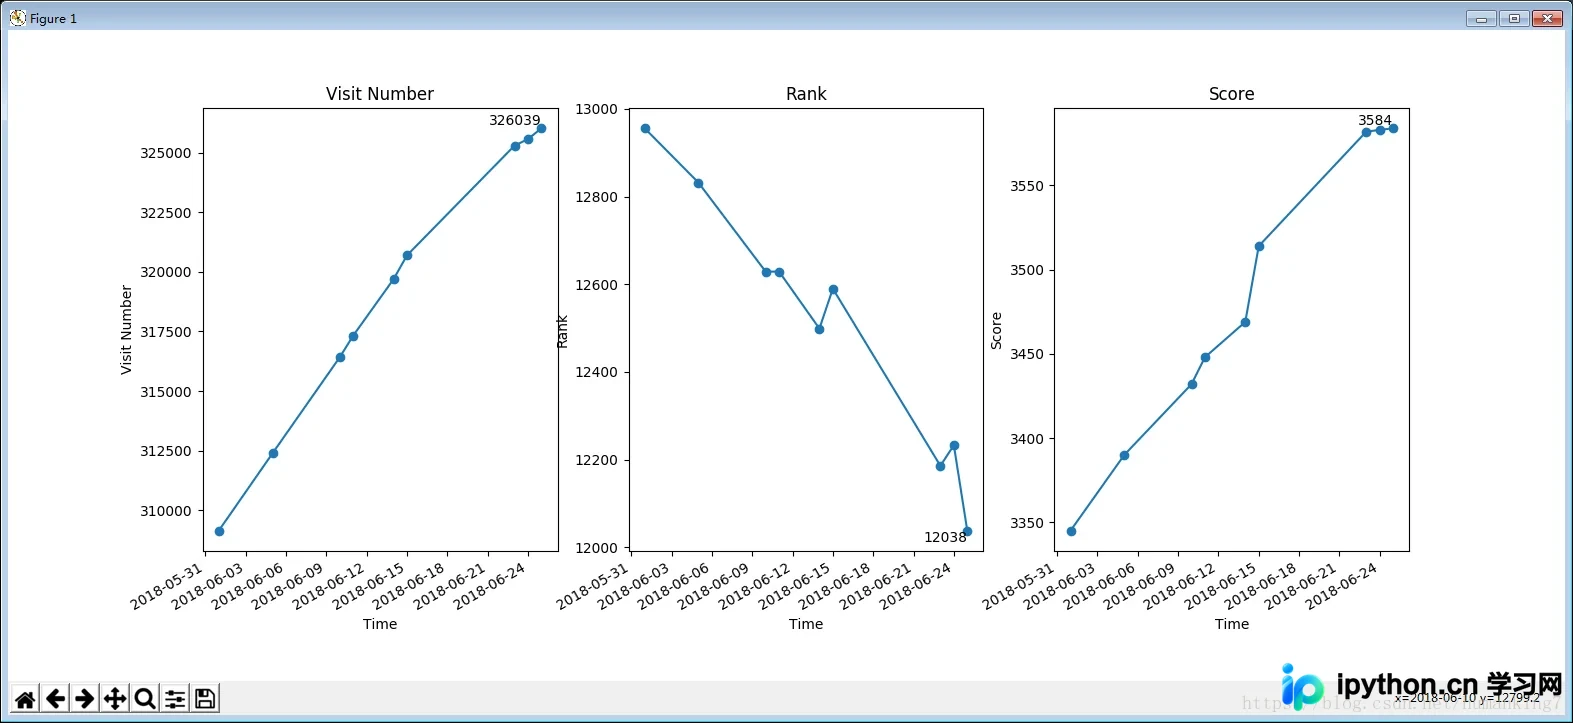
本文介绍如何在Python中使用matplotlib库绘制以时间日期为x轴的图表。通过将[[wp:a1]]类型变量作为x轴数据,利用[[wp:a12]]支持[[wp:a13]]类型的特性,实现日期数据的可视化展示。文中提供了从[[wp:a4]]读取数据、处理制表符分隔格式以及使用[[wp:a6]]进行绘图的完整源码与分析。
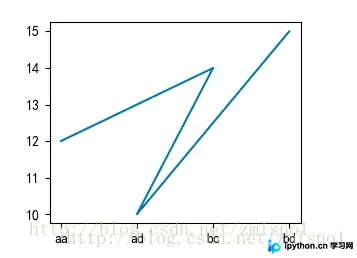
本文针对Python Matplotlib绘制折线图时X轴标签未按自定义数组顺序显示的问题,分析其因自动映射导致的显示错乱现象,并提供通过plt.xticks()函数手动指定刻度标签的解决方案,确保X轴按预期顺序排列。
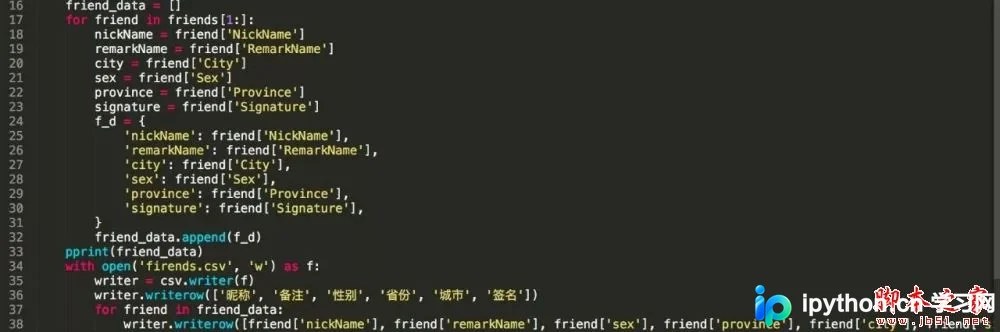
本文介绍如何利用Python的itchat库获取微信好友数据,并通过CSV存储与Echarts图表技术,对好友的性别比例及地理位置分布进行可视化分析。文章详细展示了从数据提取、清洗到图表生成的完整流程,帮助读者掌握基础的数据抓取与可视化技能。
本文介绍如何在Python Matplotlib中实现鼠标滑过显示隐藏内容的功能。通过利用annotate函数创建点与注释对,并注册motion_notify_event事件监听鼠标移动,动态控制注释的可见性。代码示例展示了如何遍历数据点,当鼠标位于点上时显示对应坐标信息,否则隐藏,适用于需要交互式展示详细数据的图表场景。