

Python Pandas DataFrame 行列合并详解:concat 函数用法
本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
2026-10-13
6

本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
本文介绍在pandas中如何对指定列进行数据填充。通过选取特定列并使用ffill()方法,可实现向下填充缺失值。示例展示了仅对X和Y列执行前向填充,而Z列保持不变的操作过程及结果。
本文详解Python pandas中生成指定日期范围的方法,包括使用date_range设定起止时间、周期及频率。重点讲解时间序列的重采样技术,涵盖通过resample进行降采样(高频转低频)与升采样(低频转高频)的具体操作,解析closed、label等关键参数对聚合结果的影响,并提供基于groupby的替代聚合方案及填充策略。
本文介绍如何使用pandas库将包含日期字符串的Series转换为表示星期几的Series。主要步骤包括利用pd.to_datetime将字符串序列转换为datetime格式,随后通过weekday()方法提取每个日期的星期信息,实现从日期字符串到星期几的高效转换。
本文介绍在pandas中将object类型数据转换为datetime时间类型的方法,并通过示例展示如何从转换后的时间对象中提取年份信息。通过pd.to_datetime函数指定格式,结合列表推导式遍历提取年份,适用于数据清洗和时间序列分析场景。
本文介绍Python中利用Pandas库将DataFrame转换为Matrix的方法。通过示例展示如何创建DataFrame,并使用.values和as_matrix(columns=None)属性提取底层矩阵数据,供开发者参考。
针对Pandas处理亿行级大文件时内存溢出的问题,本文介绍了一种通过String中间格式降低内存占用的策略。虽然Pandas官方提供了to_string方法,但未直接提供反向转换。通过利用StringIO将字符串数据封装为文件对象,再配合read_csv函数,即可高效地将String还原为DataFrame,从而规避pickle保存时的额外内存开销。
本文深入解析 pandas 中 DataFrame 的五种核心查询方法:方括号切片、loc、iloc、at 和 iat,并简要提及已弃用的 ix。重点对比各方法在行/列选择、索引与位置定位、单元素访问及赋值安全性的差异,帮助开发者避免 SettingWithCopyWarning 并提升代码执行效率。
本文详解Pandas中map、apply和applymap三个函数的区别。apply用于对Series或DataFrame的行/列应用函数;applymap专门针对DataFrame的每个元素执行操作;map则用于Series元素的逐元素转换。通过具体代码示例,帮助开发者准确选择合适的方法进行数据处理。
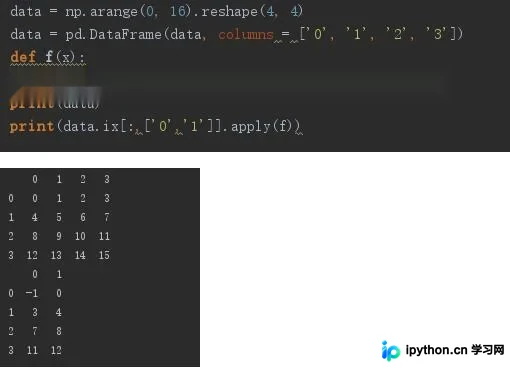
本文详细解析pandas库中apply函数的核心用法。该函数支持对DataFrame对象进行灵活操作,既可按行或按列处理元素,也能针对单个元素执行自定义逻辑。通过具体示例展示列元素、行元素及整体列/行的应用方式,帮助开发者掌握高效的数据处理技巧。
本文介绍在pandas中一次性删除DataFrame多个列的方法。通过对比使用index直接删除的错误尝试,引出利用df.drop结合df.columns索引的正确做法,演示如何指定axis=1并应用inplace=True参数,确保输出结果符合预期,帮助开发者避免常见误区。
本文介绍如何使用pandas库中的set_index方法将DataFrame的指定列转换为行索引,支持单列及多列层次化索引。同时讲解reset_index方法,用于将层次化索引级别还原为普通列,并展示索引与列名的变化细节。