

Python Pandas定位缺失值具体位置与数量的方法
在使用Pandas处理数据时,isnull()生成的布尔矩阵难以直观识别缺失位置。本文介绍通过df.isnull().any()筛选含缺失值的列,并结合df[df.isnull().values==True]直接过滤出包含NaN的行,从而精准定位缺失数据的具体行列位置并辅助统计数量,提升数据清洗效率。
2026-10-13
6

在使用Pandas处理数据时,isnull()生成的布尔矩阵难以直观识别缺失位置。本文介绍通过df.isnull().any()筛选含缺失值的列,并结合df[df.isnull().values==True]直接过滤出包含NaN的行,从而精准定位缺失数据的具体行列位置并辅助统计数量,提升数据清洗效率。
本文深入解析Pandas中DataFrame的行列数据筛选方法。通过对比df[]、df.loc、df.iloc及已弃用的df.ix,详细阐述基于标签与位置的索引逻辑。重点说明列选取时行索引不能为空的操作规范,以及混合索引类型的注意事项,帮助开发者高效处理表格数据。
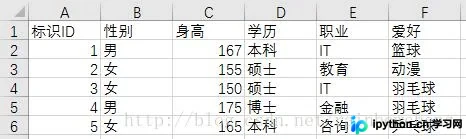
本文介绍在pandas DataFrame中查找特定值所在行列的方法。通过遍历索引和列索引,或使用列表推导式,可以定位目标值的位置。示例展示了如何遍历demo_df数据框,查找值为'fox'的元素,并输出其行索引和列索引。
本文介绍如何利用Python的Pandas库合并两个CSV文件,实现图书数据集成。通过读取ReaderInformation.csv和ReaderRentRecode.csv,使用merge函数进行左连接,最终生成包含读者与借阅详情的data.csv文件,便于整体数据分析。
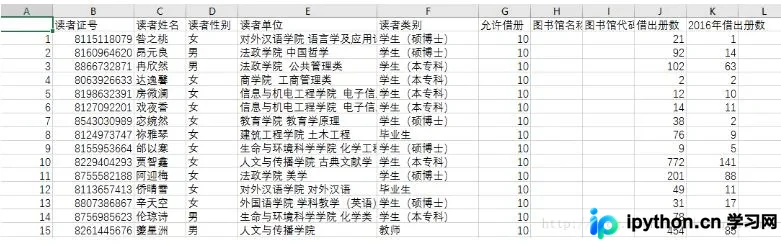
本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
本文详细解析了NumPy和Pandas中数组的合并与拆分技术。在合并方面,介绍了利用concatenate和concat方法通过指定axis参数实现纵轴与横轴拼接,并强调了Pandas中需将DataFrame置于列表中的差异。在拆分与内存布局方面,阐述了C语言(行优先)与Fortran(列优先)顺序的区别,以及如何通过order参数控制reshape和ravel操作,帮助开发者深入理解底层内存布局对数据处理的影响。
本文介绍使用pandas库处理矢量数据时的替换操作。通过Series对象的replace方法,可高效实现单个数值或字典映射的批量替换,避免手动查找数据对象的繁琐步骤。示例展示了整数替换及NaN处理,适用于Python数据分析场景。
本文详解Python pandas中生成指定日期范围的方法,包括使用date_range设定起止时间、周期及频率。重点讲解时间序列的重采样技术,涵盖通过resample进行降采样(高频转低频)与升采样(低频转高频)的具体操作,解析closed、label等关键参数对聚合结果的影响,并提供基于groupby的替代聚合方案及填充策略。
本文介绍利用 pandas 库实现类似 SQL 中 dateadd 和 datesub 功能的日期处理方法。通过 DateOffset 对象,可分别计算当月、当季及当年的第一天与最后一天,并演示如何获取昨日日期、星期几以及生成自定义频率的时间序列。
本文介绍如何使用pandas库将包含日期字符串的Series转换为表示星期几的Series。主要步骤包括利用pd.to_datetime将字符串序列转换为datetime格式,随后通过weekday()方法提取每个日期的星期信息,实现从日期字符串到星期几的高效转换。
本文介绍在pandas中将object类型数据转换为datetime时间类型的方法,并通过示例展示如何从转换后的时间对象中提取年份信息。通过pd.to_datetime函数指定格式,结合列表推导式遍历提取年份,适用于数据清洗和时间序列分析场景。
本文深入解析 pandas 中 DataFrame 的五种核心查询方法:方括号切片、loc、iloc、at 和 iat,并简要提及已弃用的 ix。重点对比各方法在行/列选择、索引与位置定位、单元素访问及赋值安全性的差异,帮助开发者避免 SettingWithCopyWarning 并提升代码执行效率。