Python文件读写实战指南:从基础文本到CSV JSON处理
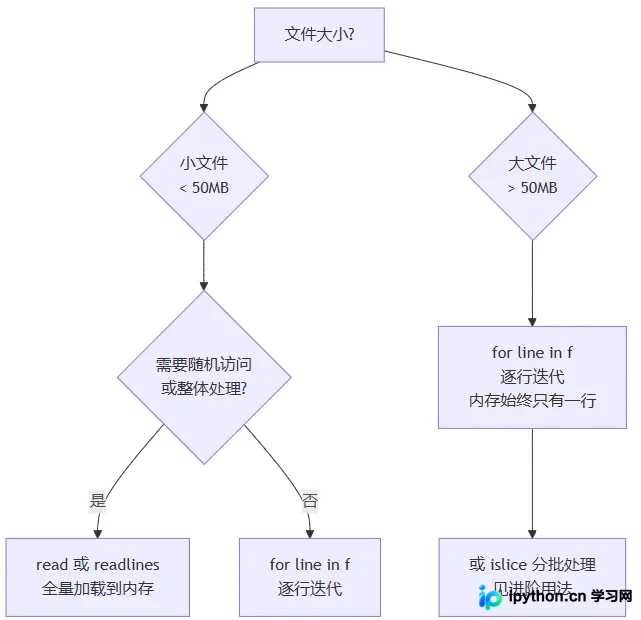
掌握Python文件读写的核心方法,可覆盖纯文本处理到CSV、JSON等结构化数据的日常开发需求。本文梳理了基于open函数的基础读取与写入操作,对比了全量读取与按行遍历的内存差异,并详解csv与json模块的标准用法,帮助开发者快速匹配不同场景的最佳实践。
2026-10-12
6

掌握Python文件读写的核心方法,可覆盖纯文本处理到CSV、JSON等结构化数据的日常开发需求。本文梳理了基于open函数的基础读取与写入操作,对比了全量读取与按行遍历的内存差异,并详解csv与json模块的标准用法,帮助开发者快速匹配不同场景的最佳实践。
本文介绍如何使用Python的pandas库导入CSV文件。涵盖默认导入、指定分隔符(sep)、限制读取行数(nrows)以及处理编码格式(encoding)等关键参数。同时提供解决中文列标题对齐问题的set_option方法,帮助开发者高效处理不同格式的CSV数据。
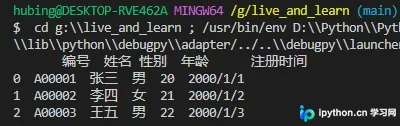
本文详解如何使用 Python 的 csv 模块读取 CSV 格式的电子表格数据。通过 DictReader 将数据行转换为有序字典,实现按字段名访问。同时结合 random 模块的 randrange 函数,演示如何从数据列表中随机抽取记录,适用于抽奖或样本选取场景。
本文介绍如何利用Pandas的skiprows和nrows参数高效读取CSV文件中特定范围的行,避免全量加载导致内存溢出。同时提供根据列值筛选并获取对应索引的方法,适用于大规模数据处理场景。
本文总结 Python 中处理 CSV 文件的核心方法。通过 csv.reader 遍历读取数据,利用 csv.writer 进行列表写入,并掌握 csv.DictWriter 处理字典数据的技巧。重点解析写入时 newline='' 的作用、覆盖与追加模式的区别,以及常见空行问题的解决方案,帮助开发者高效处理结构化数据。
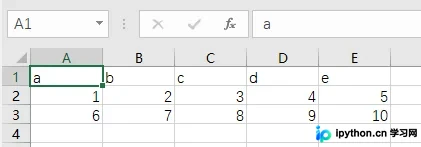
在使用Python将数据写入CSV文件时,常遇到打开文件后出现多余空行的问题。本文详细解析了该现象产生的原因,并重点介绍了Python官方推荐的解决方案:在open函数中设置newline=''参数。同时提供了针对小数据量的手动清理方法,帮助开发者快速解决CSV格式异常问题。
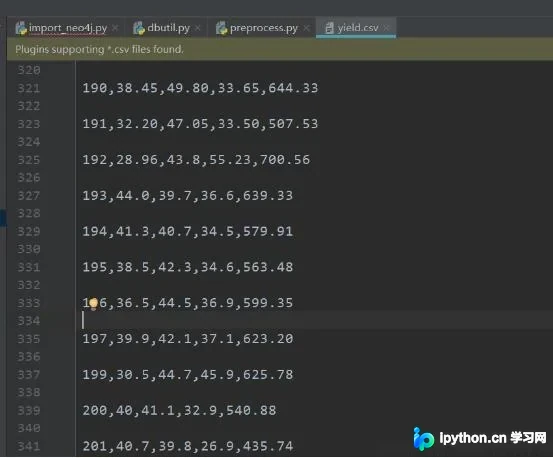
本文介绍如何使用 Python 将数据集按指定比例随机划分为训练集和测试集。通过读取 CSV 文件并跳过表头,利用 random.sample 函数选取测试集数据,剩余部分即为训练集。该方法适用于简单的机器学习数据预处理场景,帮助快速构建模型训练环境。
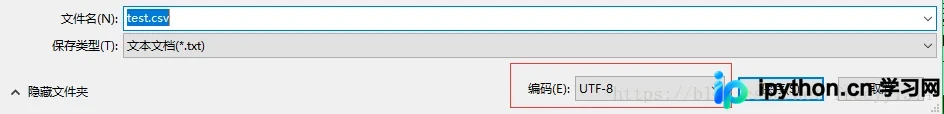
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
本文详细介绍如何利用Python的Pandas库读取本地CSV文件,处理日期格式,并通过两种方法将数据保存至MySQL数据库。文章对比了直接使用MySQLdb库与使用SQLAlchemy结合to_sql方法的优劣,重点讲解了日期格式转换及字段类型匹配问题,帮助开发者高效完成数据入库操作。
本文介绍如何使用pandas库将numpy数组高效保存为CSV文件。通过创建DataFrame对象并调用to_csv方法,可简化数据持久化过程。文章包含完整的代码示例,展示从数组生成到文件保存的具体操作及结果分析。
本文通过一个Nginx日志分析器场景,系统讲解Python文件操作核心技能。涵盖open()函数的三种模式、with语句的安全用法、大文件逐行读取优化,以及CSV的utf-8-sig编码坑和JSON序列化类型转换。结合pathlib现代路径处理,提供从基础读写到实战报告的完整代码示例,帮助开发者避开常见报错,提升数据处理效率。