Python Scrapy实现定时爬虫的几种方法
本文详解在Python中使用Scrapy框架实现定时爬虫的多种方案。通过Timer类、os.system调用及sched模块,可灵活设定抓取周期。文章提供了具体代码示例,涵盖单次执行与周期性任务,帮助开发者根据需求配置定时策略,适用于数据挖掘、监测及自动化测试场景。
2026-10-14
6

本文详解在Python中使用Scrapy框架实现定时爬虫的多种方案。通过Timer类、os.system调用及sched模块,可灵活设定抓取周期。文章提供了具体代码示例,涵盖单次执行与周期性任务,帮助开发者根据需求配置定时策略,适用于数据挖掘、监测及自动化测试场景。
本文介绍如何在PHP中利用sleep函数处理动态生成的延迟时间,解决crontab无法覆盖的非固定间隔执行场景。通过计算目标时间戳与当前时间的差值,结合set_time_limit设置延长超时限制,实现精准的代码延迟执行。
本文详细介绍如何使用Python编写一个自动化脚本,定时从北京工业大学官网抓取新闻数据。通过requests和BS4解析HTML,利用pymysql将数据存入MySQL数据库,并结合smtplib实现邮件自动发送。文章涵盖环境配置、代码逻辑分析及schedule定时器的使用方法,适合初学者参考。
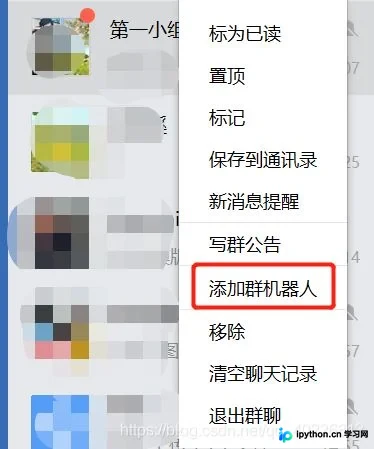
本文介绍如何使用Python脚本结合企业微信群机器人Webhook地址,实现定时发送文本消息的功能。通过编写Python代码调用API,利用PyInstaller打包为exe文件,并借助Windows任务计划程序设置触发器,即可在指定时间自动执行脚本发送消息。该方法适用于Windows环境,需保持电脑开机。
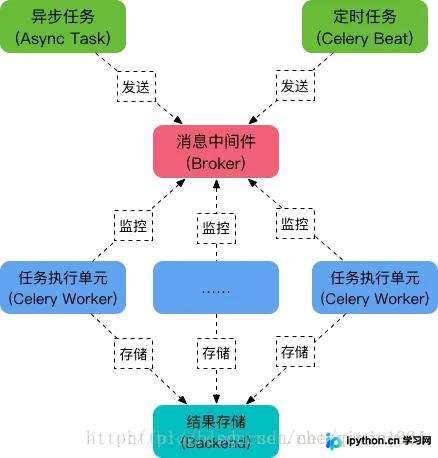
本文详细介绍如何在Django项目中集成Celery以实现异步和定时任务。涵盖Celery架构模块、环境配置(Django、Redis版本建议)、Broker与Worker设置,以及通过django-celery创建和调用异步任务的具体步骤。
本文介绍使用Python实现定时监测网站运行状态的方法。通过requests获取状态码,利用BlockingScheduler设置定时任务,自动检测无效链接并执行下线或二次探测,辅助SEO优化与网站维护。
本文详解了如何在PHP脚本中实现每隔固定时间间隔自动执行特定代码片段。通过配置ignore_user_abort保持连接、set_time_limit解除限制以及sleep函数控制间隔,可构建简单的后台轮询机制。文中提供完整代码示例及关键参数说明。
本文详解在Django项目中集成django-crontab模块的方法。涵盖从pip安装、settings.py配置CRONJOBS,到定义业务函数及绑定执行频率的完整流程。同时提供查看、添加、移除定时任务的命令行操作,以及通过服务器crontab命令验证任务生效的最终步骤,帮助开发者快速实现后台自动化任务。
本文详细介绍如何利用Python构建一个自动化的网站通知监控系统。通过urllib和BeautifulSoup抓取网页内容,结合sqlite3建立本地数据库以存储历史通知。系统模拟SMTP服务器(如QQ邮箱)实现邮件发送功能,并通过Windows任务计划程序设定定时执行脚本,从而实现对目标网站最新通知的实时监测与自动邮件提醒。
本文针对Windows任务计划频繁挂起的问题,探讨Python爬虫定时任务的实现方案。首先分析基于while True死循环的简单实现及其在复杂场景下的局限性,如多任务并发、网络稳定性及异常处理等。文章指出该方法适用于低频单次执行场景,后续将介绍更稳健的定时任务解决方案,帮助开发者优化爬虫调度策略。
本文分析使用Python Selenium结合多线程执行定时任务时,因频繁启动浏览器实例导致CPU占用率飙升至90%以上的问题。通过展示基于threading.Timer的简易定时代码,指出其潜在性能瓶颈,并探讨如何优化资源占用以避免系统卡顿,适用于需要长期运行的自动化爬虫场景。
本文介绍利用Python实现自动打开电脑应用的两种方案:一是通过pyautogui模拟鼠标双击快捷方式坐标,二是通过os库直接调用可执行文件路径。文章详细讲解了环境配置、坐标获取技巧、代码实现及注意事项,并结合time库实现了定时自动启动功能,适用于网课提醒等场景。