

Python多线程创建详解:函数与类两种实现方式及核心API
本文详解Python中创建多线程的两种核心方式:通过函数直接实例化Thread类,以及继承Thread类并覆写run方法。文章深入解析了Thread构造函数的参数用法,并系统梳理了start、join、is_alive、daemon等常用线程控制API,帮助开发者掌握Python并发编程的基础技能。
2026-10-13
6

本文详解Python中创建多线程的两种核心方式:通过函数直接实例化Thread类,以及继承Thread类并覆写run方法。文章深入解析了Thread构造函数的参数用法,并系统梳理了start、join、is_alive、daemon等常用线程控制API,帮助开发者掌握Python并发编程的基础技能。
本文通过Python多进程模拟高并发抢票场景,演示了未加锁时因读写竞争导致的数据错乱问题。随后引入互斥锁(Lock)机制,将并发购票串行化,确保数据一致性。文章对比了基础实现与加锁后的执行结果,并介绍了with语句在锁管理中的简化用法,帮助开发者理解并发安全的重要性。
本文解析Python多进程中互斥锁的工作原理。由于多进程内存隔离但共享文件系统,并发访问同一资源会导致数据错乱。通过引入互斥锁(Lock),将并发操作转化为串行执行,确保数据一致性,虽牺牲部分效率但避免了竞争错误。
本文深入解析Python multiprocessing模块中守护进程的工作机制。主进程结束时守护进程立即终止,且守护进程内部严禁开启子进程,否则抛出AssertionError。文章通过代码示例演示了如何正确设置daemon属性,并解释了其在任务依赖场景下的实际应用价值。
本文深入解析Python multiprocessing模块中Process对象的join方法。通过对比主进程独立运行与依赖子进程结果的两种场景,阐明join用于阻塞主进程直至子进程结束的核心机制。重点澄清常见误区:多次调用join不会导致子进程串行执行,总耗时取决于最长子进程。通过代码示例展示并发与串行调用的时间差异,帮助开发者正确使用join进行资源回收和流程控制。
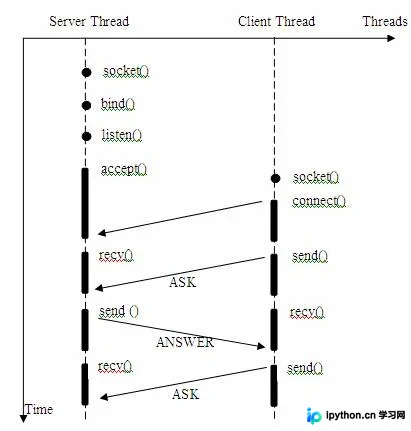
本文详细解析Linux环境下Python阻塞IO模型的工作机制,通过服务端与客户端代码示例说明recv系统调用导致的线程阻塞现象。同时探讨使用多线程解决阻塞问题的方案及其资源开销瓶颈,指出线程池在大规模并发下的局限性,为理解非阻塞IO模型奠定基础。
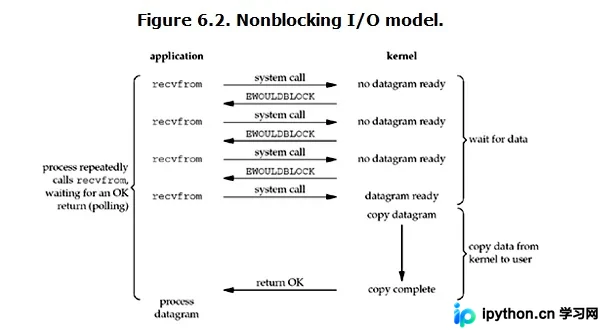
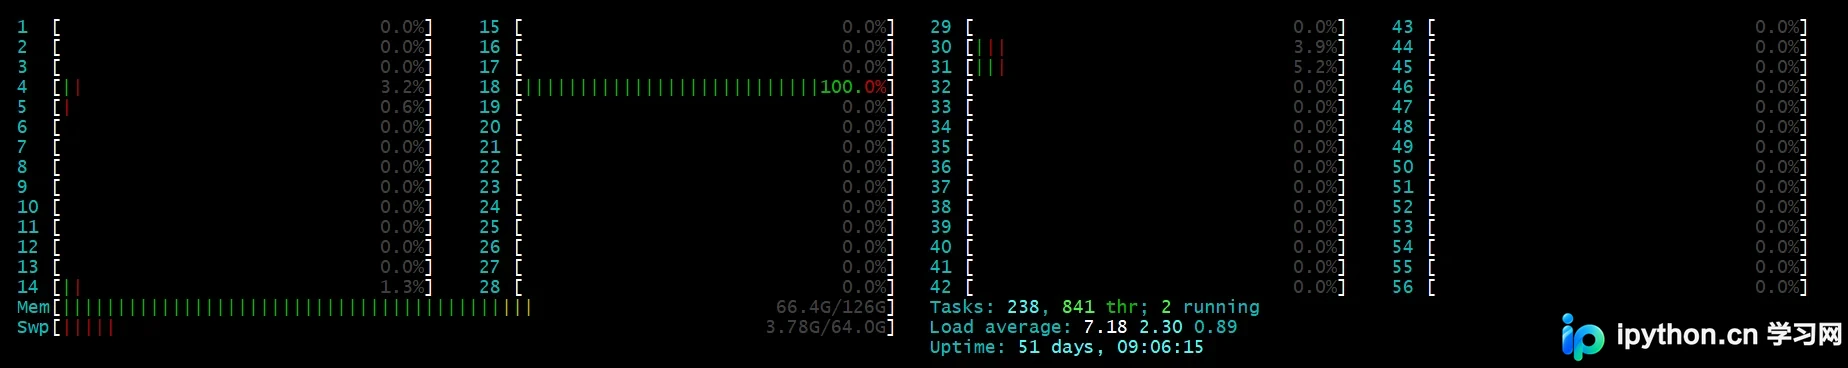
本文深入解析 Python 中非阻塞 IO 模型的工作原理,通过 Linux Socket 示例展示如何设置非阻塞模式及处理 BlockingIOError 异常。文章详细阐述了非阻塞 IO 在单线程并发中的应用,指出了 send 阻塞及 CPU 占用过高等缺陷,并引出 select 多路复用作为更优解决方案。
本文详解Python multiprocessing中Manager支持的类型,重点剖析Manager对list、dict等可变对象修改不同步的陷阱。通过引入中间变量触发__setitem__方法,可确保子进程修改被主进程感知,同时强调对象需满足pickle序列化要求。
本文介绍如何在Python中利用pathos.multiprocessing库结合tqdm实现多进程并行计算及进度条显示。针对标准multiprocessing库仅支持单参数输入的局限,pathos可处理多参数函数。通过示例展示了如何定义迭代函数、配置超参数数组,并监控进程执行进度,有效加速高复杂度计算任务。
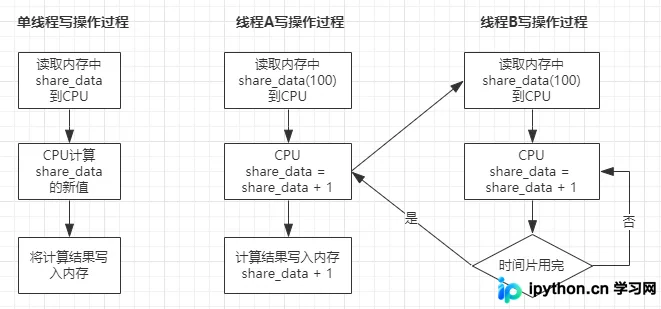
本文深入解析Python多线程同步机制,通过具体代码实例阐明同步与互斥的区别。详细讲解Lock、RLock、Semaphore、Condition及Event五种核心同步工具的原理与用法,结合交替打印、生产者消费者等场景,帮助开发者解决线程安全问题,提升并发编程能力。
本文详解Python中os.fork()与os.getpid()函数的用法。os.fork用于创建子进程,父进程返回子进程PID,子进程返回0;os.getpid获取当前进程ID。两者结合可清晰管理并发进程的执行逻辑与身份标识。
本文详细解析Python中os.fork()函数创建子进程的工作机制。通过两个具体代码示例,展示了父进程与子进程的返回值区别、进程ID获取方法以及基本的进程控制流程。文章涵盖fork()的返回值判断、getpid()与getppid()的使用,适合希望理解Python多进程编程基础的开发者参考。