

Python 线程生命周期详解:从新建到死亡的五个状态
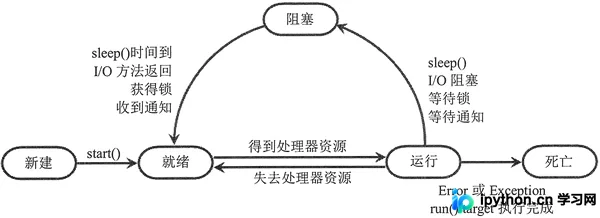
本文详细解析 Python 中线程的五个生命周期状态:新建、就绪、运行、阻塞和死亡。文章阐述了线程通过 start() 方法进入就绪状态,经 CPU 调度进入运行状态,以及在调用 sleep、等待锁或 notify 时进入阻塞状态的机制。同时说明了线程正常结束或发生异常导致的死亡状态,以及主线程与子线程的独立性。
2026-10-14
6

本文详细解析 Python 中线程的五个生命周期状态:新建、就绪、运行、阻塞和死亡。文章阐述了线程通过 start() 方法进入就绪状态,经 CPU 调度进入运行状态,以及在调用 sleep、等待锁或 notify 时进入阻塞状态的机制。同时说明了线程正常结束或发生异常导致的死亡状态,以及主线程与子线程的独立性。
本文介绍基于Python的C/S(客户端/服务器)模式网络通信实现。通过Socket模块创建TCP连接,服务器端监听端口并启用多线程处理多客户端请求,客户端发起连接并交互发送数据。代码展示了完整的握手、消息收发及断开流程,适用于理解基础网络编程概念。
本文详细介绍如何使用Python操作Redis,涵盖基础数据读写、集合与列表操作,并深入解析基于Redis List构建消息队列的完整流程。通过连接池管理、批量命令执行及多进程并发处理示例,展示高并发场景下的任务调度与性能优化方案。
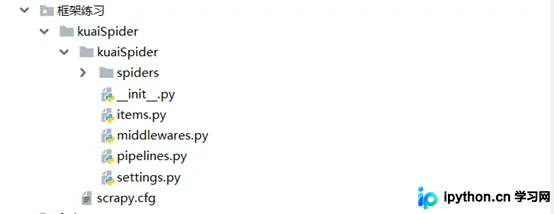
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
本文介绍在Python中利用多线程和数据库连接池优化大量数据查询的方法。通过对比普通循环查询与多线程并发查询的执行结果,展示如何限制最大连接数和线程数,从而减少CPU等待IO的时间,提升程序运行效率。
本文深入解析Python中的线程锁机制,通过库存扣减示例演示Lock与RLock的使用场景。重点探讨并发环境下数据一致性问题,分析普通锁导致的死锁成因,并给出使用可重入锁(RLock)及with语句的最佳实践方案,帮助开发者避免常见的并发陷阱。
本文介绍如何利用Python3多线程技术优化Git项目成员代码统计功能。通过对比老版本串行处理与新版本并发处理,解决外层与内层循环中的耗时操作。引入线程锁机制共享外部资源并避免写冲突,最终实现运行速度提升约58倍,将执行时间从108秒缩短至1.8秒,显著提高了程序运行效率。
本文介绍如何利用Python的Semaphore类控制多线程并发数量,通过示例代码展示如何限制同时执行的线程数,避免资源过度消耗。
本文探讨Python中多线程的退出控制问题。通过设置线程的daemon属性为True,可实现父进程结束时子线程自动终止的效果。文章提供了基于守护线程的完整代码示例,并指出该方法虽能解决抢票爬虫等场景下的线程失控问题,但强制终止可能导致内存未释放、数据丢失或系统中断,建议根据实际需求谨慎使用。
本文介绍如何利用Python的pyinotify库实现目录文件的持续监听。通过定义事件处理类捕获文件修改事件,结合Socket通信将新增内容实时发送至指定服务器。代码示例展示了从文件读取、网络发送到循环监听的完整流程,适用于需要实时响应文件变更的后台常驻任务场景。
本文介绍如何在Python中实现一个常驻进程以接收外部传入的参数。通过构建基于Socket的Server-Client架构,服务端利用多线程处理并发连接,解析客户端发送的数据并执行相应逻辑;客户端支持从命令行直接传入参数或读取文件内容发送请求。该方案实现了持久化运行与动态参数交互的结合,适用于需要持续监听并处理外部指令的场景。
本文通过CentOS 7环境下Python 3.6的实测数据,对比了同步库requests与异步库aiohttp访问百度的耗时。结果显示aiohttp耗时约10.7秒,requests约12.4秒,验证了异步框架的速度提升。文章附带完整测试代码,并特别提示使用requests时避免复用session导致缓存干扰测试结果。