

Python日志模块logging性能测试与多进程处理方案
本文通过实测分析Python标准库logging模块在机械磁盘上的写入性能,发现单进程每秒约写入2800-3000行日志,此时磁盘IO已饱和。针对多进程场景,提出按PID分离日志文件并合并的方案,指出多进程无法突破IO瓶颈,高性能场景需引入缓存或分布式日志系统。
2026-10-13
6

本文通过实测分析Python标准库logging模块在机械磁盘上的写入性能,发现单进程每秒约写入2800-3000行日志,此时磁盘IO已饱和。针对多进程场景,提出按PID分离日志文件并合并的方案,指出多进程无法突破IO瓶颈,高性能场景需引入缓存或分布式日志系统。
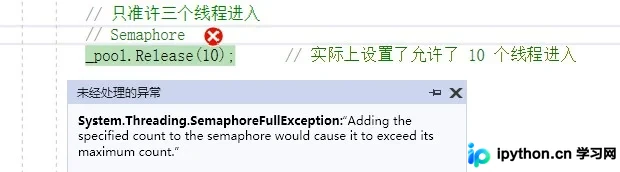
本文详解C#中用于限制并发线程数的Semaphore与SemaphoreSlim类。通过示例代码演示如何利用WaitOne/WaitAsync获取权限,以及Release释放资源,实现最多指定数量的线程同时进入资源池。文章对比两者在进程间同步、性能开销及API差异上的区别,帮助开发者选择合适的并发控制工具。
本文介绍如何利用Python内置的multiprocessing模块中的BaseManager类,快速构建基于生产者-消费者模式的分布式任务系统。通过中央节点协调,无需引入外部队列中间件,即可实现多主机间的高效通信与任务分发。
本文详细介绍Python标准库中sched模块的使用方法。sched模块提供通用的事件调度接口,通过enter和enterabs方法添加事件,并由run方法执行。文章指出在多线程环境下run()会阻塞主线程且存在线程安全问题,官方建议使用threading.Timer类作为替代方案。
本文通过具体代码示例,详细解析Python中守护线程(Daemon Thread)的用法。重点说明如何通过thread.setDaemon(True)或False控制子线程行为,对比非守护线程等待子线程结束与守护线程随主线程退出两种场景,帮助开发者理解线程生命周期及进程终止机制。
本文通过Python示例展示如何使用threading模块实现多并发访问网站的功能。代码包含对每次请求开始与结束时间的记录,计算单次耗时、总耗时、最大及最小响应时间,并统计超过1秒的请求次数。通过多线程并行执行,可评估网站在高并发场景下的性能表现及稳定性。
本文总结Python中线程与协程的基础用法。介绍利用threading库创建和管理线程,通过is_alive判断状态并调用_stop防止阻塞;探讨使用ThreadPool简化线程池操作。针对线程间通信,推荐使用Queue实现安全数据交换,并警告避免使用非put/get方法。此外,解析基于yield的单线程协程机制,通过TaskScheduler结合deque实现简单的任务调度,旨在提升程序性能与结构优化。
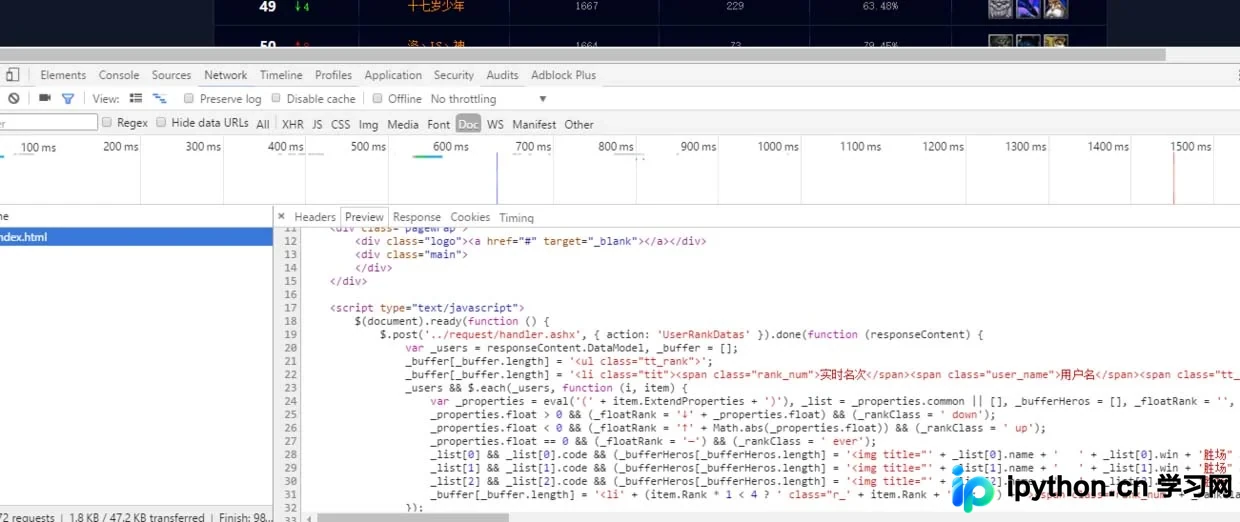
本文详细介绍如何利用Python抓取DOTA2游戏排行榜数据。通过浏览器开发者工具分析网络请求,定位异步POST接口及JSON数据结构,编写脚本模拟浏览器行为获取数据,并最终将结果保存至Excel文件中。适合希望学习网络爬虫基础及数据处理流程的开发者参考。
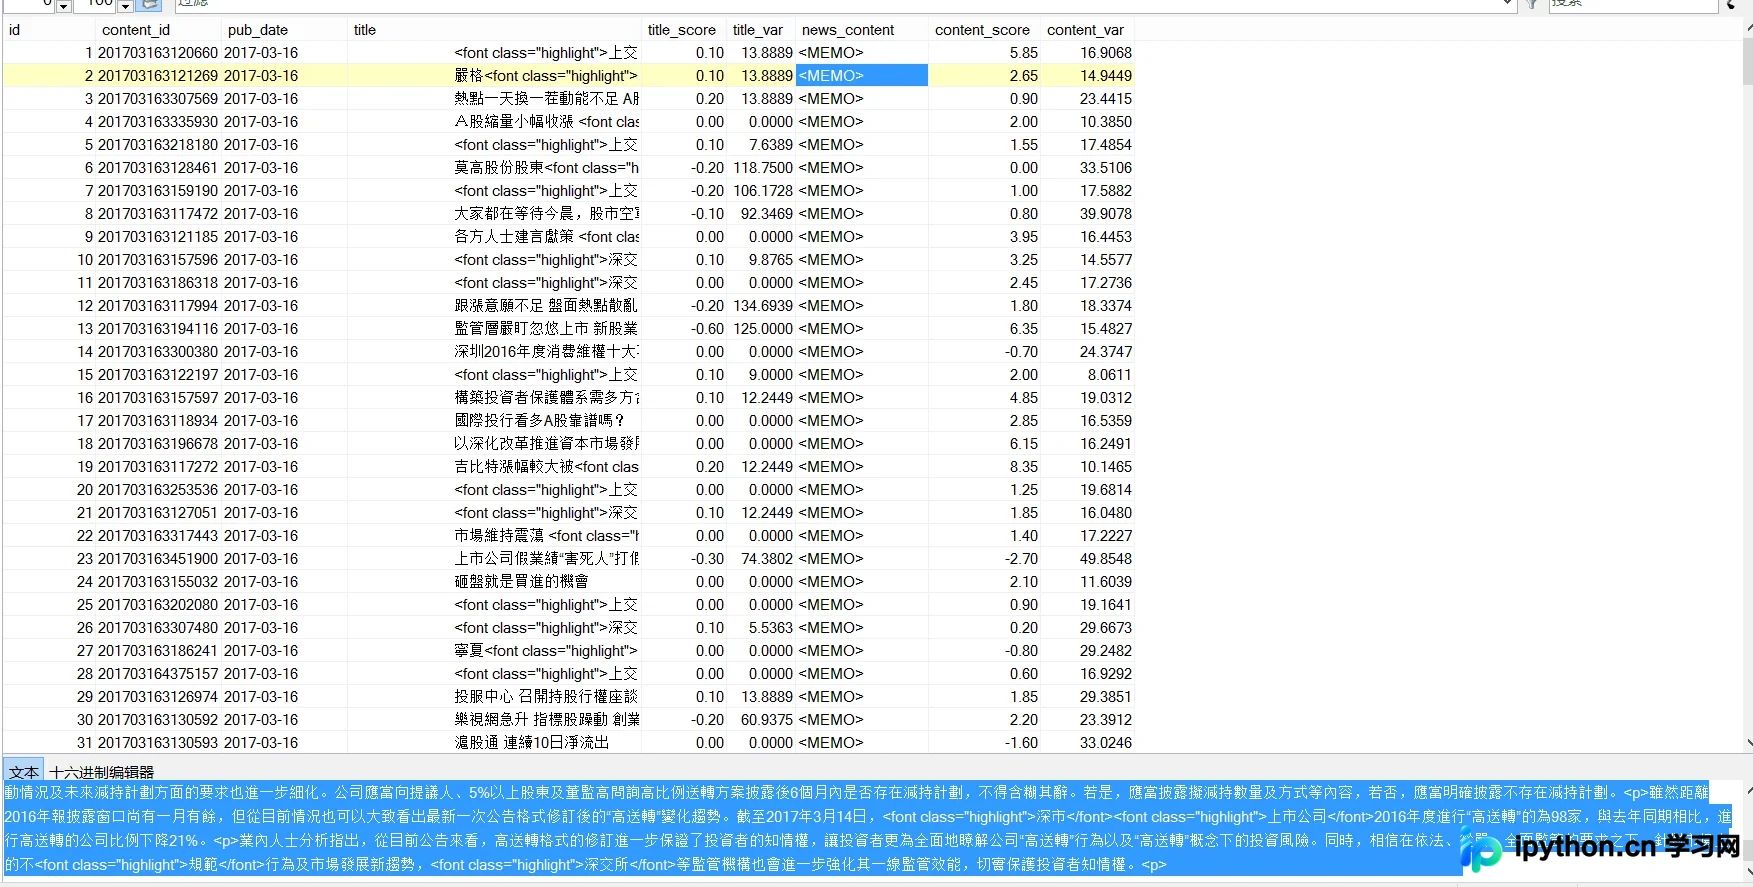
本文记录使用Python对23万条自然语言分析数据进行并行数据库读写优化的过程。通过为每个进程分配独立的connection和cursor避免冲突,并采用分表策略解决多进程写入竞争问题。文章详细阐述了并行读取与写入的实现逻辑及关键代码,旨在提升大规模数据处理的执行效率。
本文深入探讨Python中HTTP长连接客户端的实现,针对高并发场景下短连接导致的Time-Wait状态堆积和端口耗尽问题,提供了从单进程到多进程,再到长连接优化的完整解决方案。通过对比短连接与长连接代码,展示了如何利用Requests库的Session对象维持连接,显著提升系统稳定性和处理效率。
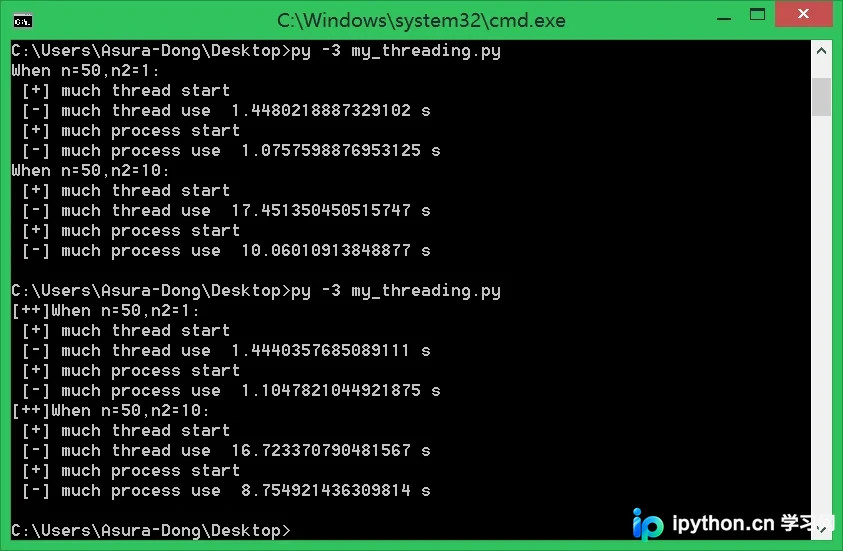
本文深入探讨Python中多进程与多线程的性能差异。受GIL限制,多线程在CPU密集型任务中无法真正并行,而多进程可独立利用多核资源。文章通过端口扫描(IO密集)和循环计算(CPU密集)实例验证:IO密集型场景多线程更高效,而CPU密集型场景多进程优势明显,并给出判断依据与代码示例。
本文分享一个基于Python的网络测试工具,通过多线程并发ping指定IP列表,利用xlrd和xlwt库实现Excel数据的读写,并采用subprocess模块解决Windows平台兼容性问题。文章详细解析了代码逻辑、线程处理函数及正则表达式匹配现状,旨在为需要批量检测网络状态的用户提供实用参考。