

Python爬虫效率优化:单线程、多线程、多进程与协程性能对比
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
2026-10-14
6

本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
本文介绍使用 python-redis-lock 库解决 Celery 多 Worker 并发执行时的数据冲突问题。通过对比数据库悲观锁、乐观锁及 Redis 方案,重点讲解 python-redis-lock 的灵活配置(超时、刷新、阻塞),并提供基于 Lua 脚本原子操作的代码示例,帮助开发者根据场景选择最优锁机制。
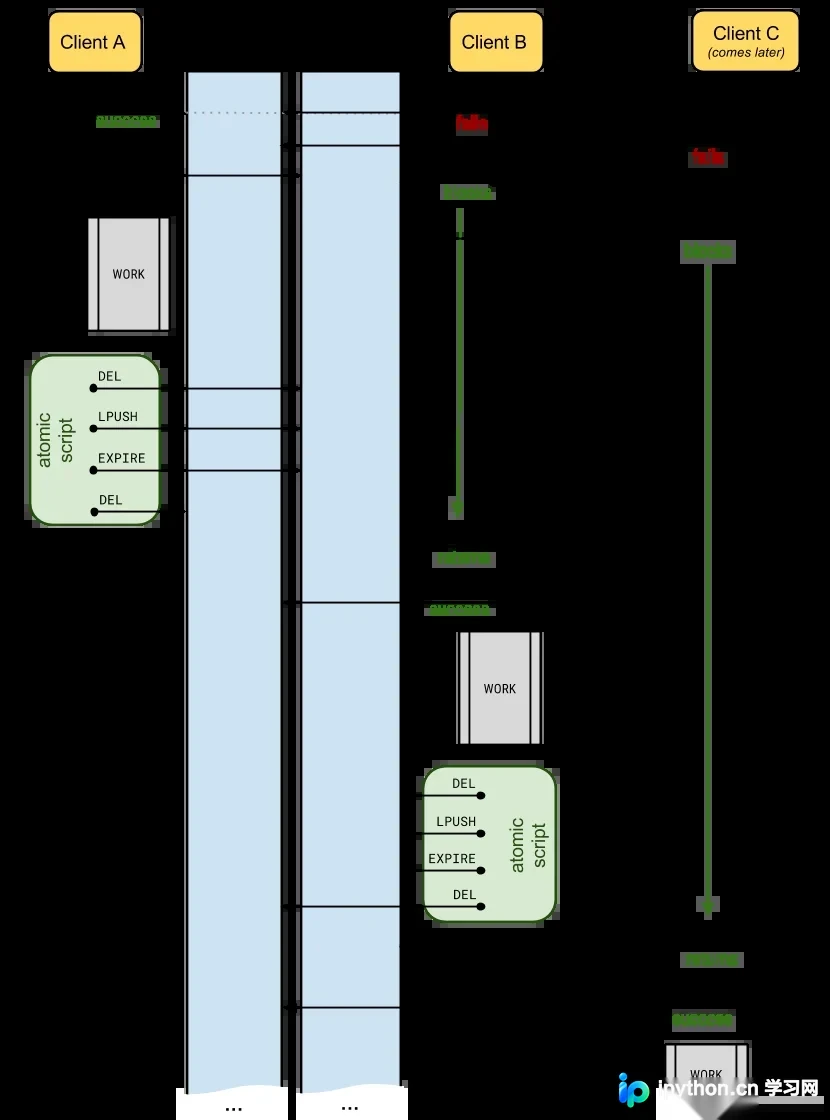
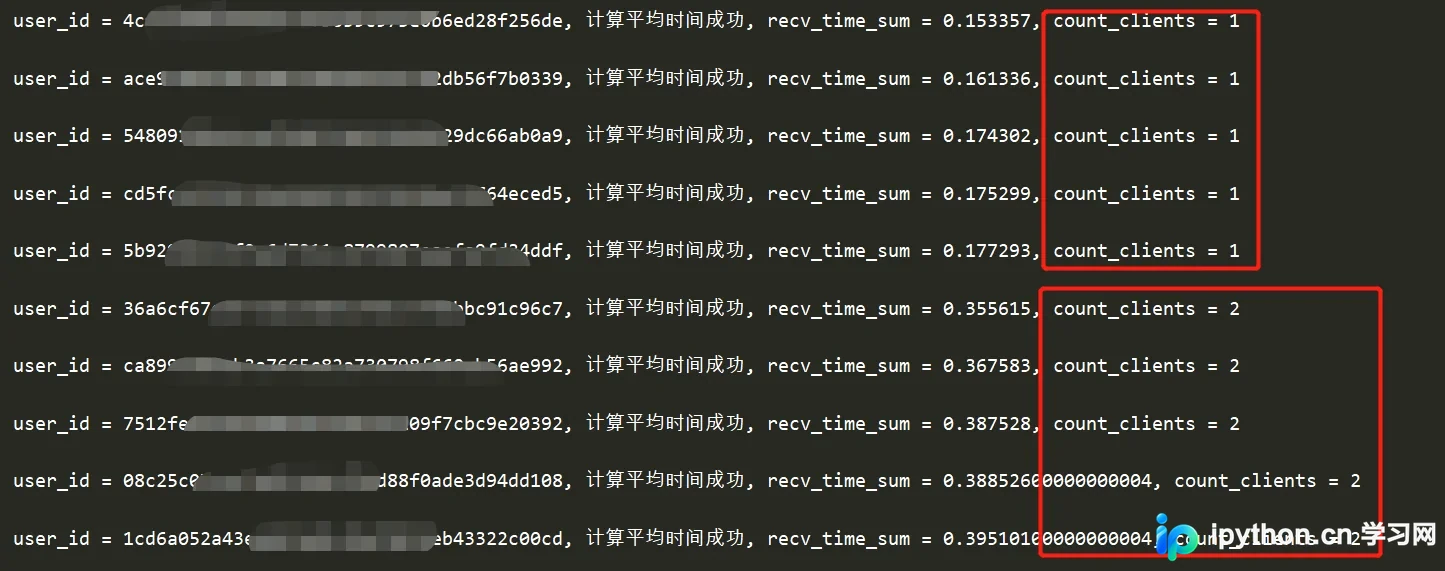
本文针对Redis高并发场景下客户端读写数据相互覆盖的问题,介绍使用python-redis-lock库实现分布式锁的方法。通过示例代码演示如何获取锁、执行业务逻辑并释放锁,有效避免多客户端同时读取同一数据导致的计算错误,确保数据一致性。
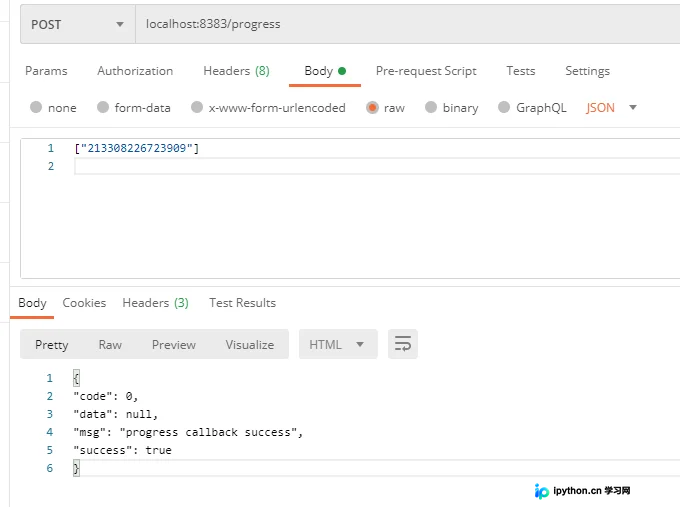
本文详解如何使用Python Flask框架结合Gevent库构建轻量级高并发HTTP服务。通过配置豆瓣源安装依赖,利用monkey.patch_all()实现IO阻塞自动切换协程,并展示完整的异步回调处理代码及Postman验证方法,适用于需要简单高效且具备一定并发能力的场景。
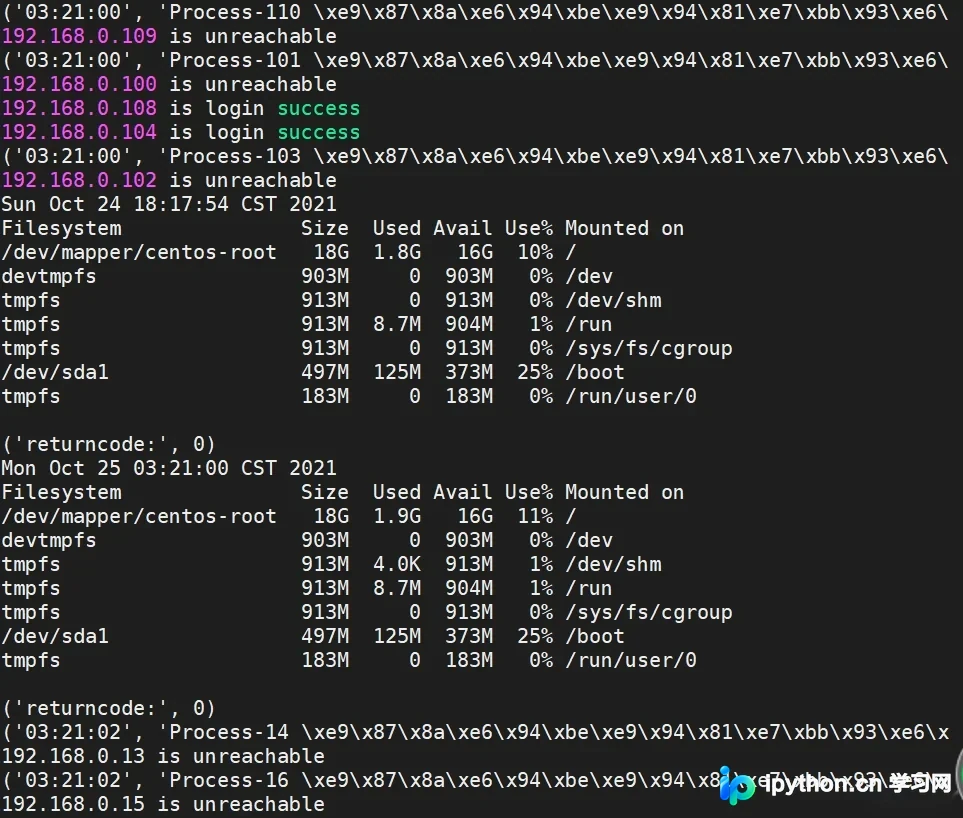
本文介绍如何利用Python的multiprocessing模块结合Semaphore信号量,实现多进程并发登录远端服务器。通过限制同时运行的进程数量,有效管理系统资源并避免连接过载,适用于大规模服务器批量运维场景。
本文介绍如何在Scrapy框架中利用Twisted库的adbapi模块实现数据库的异步写入。通过建立连接池和runInteraction方法,解决同步提交导致的阻塞问题,显著提升数据解析与写入的效率,适用于高并发爬虫场景。
本文介绍Java并发包中BlockingQueue在线程间消息传递的应用。通过LinkedBlockingQueue实现百万级数据快速传输(约50ms/十万条)的性能测试,并深入解析offer和poll方法基于ReentrantLock和AtomicInteger的底层实现机制,说明其利用条件变量信号实现高效线程同步的原理。
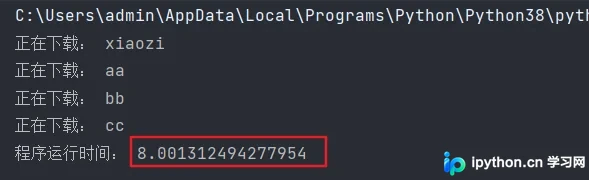
本文详细解析Python异步爬虫中处理多个URL请求时的性能优化方案。通过对比单线程阻塞、多线程及线程池三种方式,展示了如何利用并发机制减少等待时间。重点介绍了线程池在降低系统开销方面的优势,并提供了具体的代码示例与运行结果分析,帮助开发者选择合适的并发策略。
本文详细解析 C# 中基于委托的 BeginInvoke 和 EndInvoke 异步编程模式。涵盖同步与异步的区别,四种调用策略(阻塞等待、轮询、回调等),并结合代码实例展示如何处理异步结果及网络请求中的回调应用。
本文详细介绍Python中multiprocessing模块的使用,涵盖Process类的实例化、参数传递及常用方法,演示通过继承Process类创建进程的方式,并深入解析进程池Pool的应用场景与代码实现。最后对比多进程与多线程的优缺点,帮助开发者根据实际需求选择合适并发模型。
本文深入分析 PHP 中如何利用 curl_multi 系列函数实现高效的并发 HTTP 请求。通过封装 curlMultiRequest 方法,结合 CURLOPT 选项配置与多线程模拟循环,显著提升批量抓取网页数据的性能。文中提供完整可运行的 PHP 示例代码及关键参数说明,适用于需要高并发的网络数据采集场景。
本文详解C/C++在Windows环境下的多线程编程,重点讲解_beginthreadex函数创建线程的参数与返回值、线程函数的规范定义、Visual C++中运行期库的配置方法,以及线程安全退出的四种方式与资源释放原则,帮助开发者快速掌握底层并发技术。