Python jieba库分词模式与词性标注实战
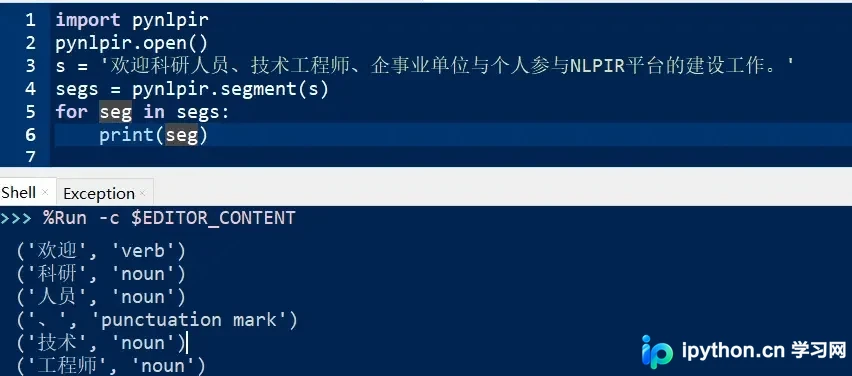
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
2026-10-14
5

本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
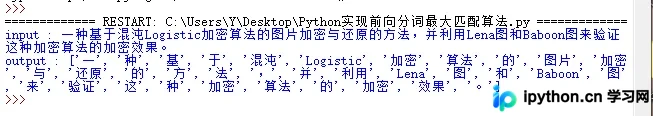
本文详细介绍基于词表的中文分词方法,重点讲解前向最大匹配算法的原理与Python实现。通过定义最大词长、递归匹配字典及主循环处理,演示如何对包含英文、数字及特定术语的中文句子进行有效分词,并提供完整代码供参考。
本文介绍如何使用Python的jieba库进行中文分词,涵盖精确模式、全模式和搜索引擎模式三种用法。通过示例代码演示如何结合停用词表过滤无意义词汇,实现高效的文本预处理流程,适用于NLP基础场景。
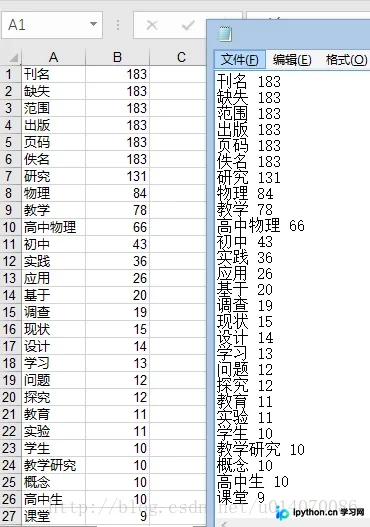
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
本文详细解析自然语言处理中基础的中文分词算法——前向最大匹配法。通过设定最大词长,从左至右扫描文本并与词典比对,逐步缩短候选子串直至匹配成功或转为单字。文章提供了完整的Python代码示例,演示如何读取输入文件与词典,并输出分词结果,适合NLP初学者参考学习。
本文介绍如何在Django项目中通过Haystack框架集成Whoosh搜索引擎,实现高效的全文检索功能。内容涵盖环境配置、中文分词器(jieba)的定制与替换、索引文件的创建以及搜索结果的自定义渲染。此外,还讲解了如何重写SearchView以扩展搜索逻辑,并利用高亮标签优化搜索结果展示,帮助开发者快速搭建具备中文支持的专业级搜索服务。
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。