

Python爬虫批量下载PDF文件实战:从Excel链接到自动化脚本
本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
2026-10-14
5

本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
本文详细介绍如何使用Python编写一个自动化脚本,定时从北京工业大学官网抓取新闻数据。通过requests和BS4解析HTML,利用pymysql将数据存入MySQL数据库,并结合smtplib实现邮件自动发送。文章涵盖环境配置、代码逻辑分析及schedule定时器的使用方法,适合初学者参考。
本文介绍如何使用Python的Requests库对文件分片上传接口进行自动化测试。通过模拟前端行为,将大文件按指定大小分片,计算整体及分片MD5值,并循环调用后端接口上传各分片。最后通过对比服务器返回的MD5值来验证上传完整性与正确性,适用于Vue前端与PHP后端的系统测试场景。
本文介绍如何使用Python通过pypiwin32库实现键盘按键与鼠标点击的自动化模拟。内容涵盖库的安装方法,以及利用win32api模块编写按键按下、抬起、点击及鼠标移动、左右键操作的完整代码示例,适用于Windows环境下的自动化测试与脚本开发。
本文介绍了如何利用Python的Paramiko库实现远程服务器管理。通过封装SSH连接方法,结合RSA密钥认证,实现了安全的服务器连接。文章提供了批量执行远程命令和上传文件到服务器的完整代码示例,包含错误处理与日志记录机制,适用于运维自动化场景。
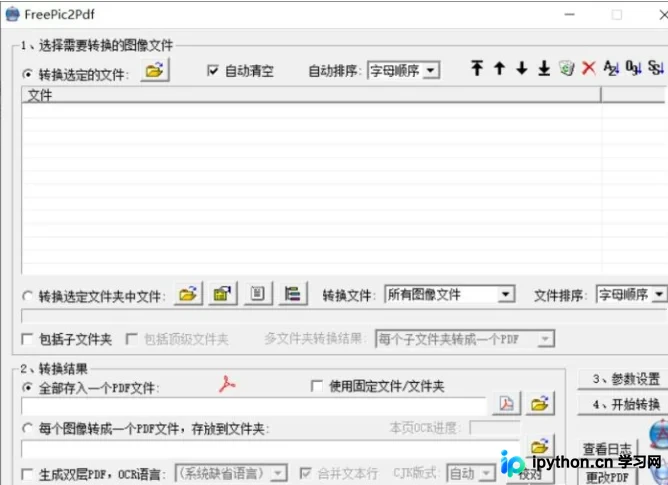
本文介绍如何利用Python脚本与FreePic2Pdf工具,为缺乏目录的PDF文件生成并导入书签。通过解析TXT格式的原始目录内容,自动处理层级缩进与页码,解决页面偏移问题,实现高效、美观的PDF目录添加。
本文详细介绍如何利用ffmpeg命令行工具结合Python脚本,自动合并B站PC端缓存的MP4格式音频与视频文件。内容涵盖ffmpeg的安装配置、环境变量设置、基础命令使用,以及通过解析缓存目录中的info和dvi文件实现批量自动化合并的完整代码示例与逻辑解析。
本文介绍如何利用 Python3 结合 GitLab REST API 编写自动化脚本,实现多项目、多分支的批量合并操作。内容涵盖获取个人令牌、配置项目 ID 及分支信息、验证 Token 有效性以及处理合并请求失败时的自动清理逻辑。针对 GitLab API 版本升级导致的兼容性问题,提供了基于 gitlab 库和 urllib 的具体实现代码,适用于软集、UAT 及 Master 分支的日常维护。
本文介绍利用Python脚本修改微信和支付宝步数的方法。通过安装乐心健康App并同步数据,使用提供的Python代码调用其API接口,可自动设置每日步数。脚本支持定时执行,推荐步数范围30000至90000,需配置账号密码及运行时间,适用于希望自动化获取运动能量或排行榜排名的用户。
本文介绍如何利用Python脚本批量爬取百度指定类别的图片。通过配置关键词文件name.txt、设定每类图片数量,并运行提供的源代码,可实现自动化下载。文章涵盖核心逻辑解析与完整代码示例,帮助开发者快速掌握批量获取网络图片的方法,适用于数据采集与素材收集场景。
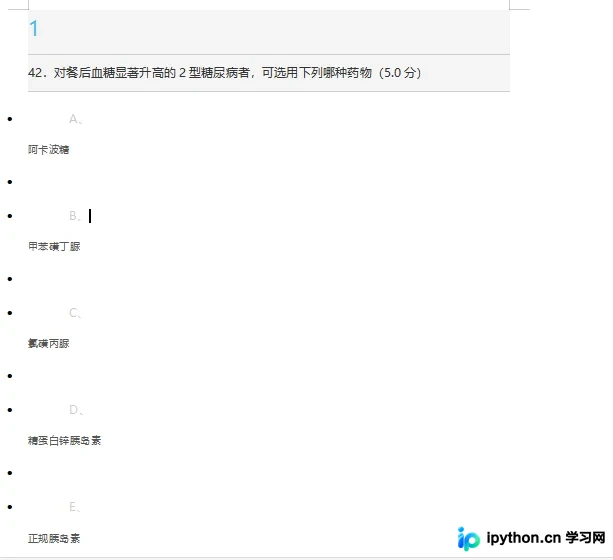
本文介绍如何利用Python的python-docx库自动化处理杂乱的Word题库文档。通过遍历段落、识别特定字符(如序号后的点号、选项符号)及过滤无效行,实现自动删除多余空白、修正错误题号、合并选项行及移除“窗体顶端/底端”等冗余内容,最终生成格式规范的标准化文档。
本文详细介绍如何利用Python的Paramiko库实现交换机的自动化巡检。通过读取设备列表和指令文件,脚本可自动连接交换机并执行环境、CPU、内存及日志等关键状态检查命令,适用于批量网络设备的日常运维监控。