

MySQL 自定义序列号生成方案:序列表与函数实现
为解决业务中唯一 ID 或高并发场景下的不重复序号需求,本文提供两种 MySQL 自定义序列号的实现方式。方法一通过创建序列表配合原子操作函数 `seq` 获取增量值;方法二构建包含 `f_currval`、`f_nextval` 和 `f_setval` 函数的完整序列管理方案。无需引入外部组件如 ZooKeeper 或 Redis,即可利用数据库自身的事务特性保障并发安全。
2026-10-15
8

为解决业务中唯一 ID 或高并发场景下的不重复序号需求,本文提供两种 MySQL 自定义序列号的实现方式。方法一通过创建序列表配合原子操作函数 `seq` 获取增量值;方法二构建包含 `f_currval`、`f_nextval` 和 `f_setval` 函数的完整序列管理方案。无需引入外部组件如 ZooKeeper 或 Redis,即可利用数据库自身的事务特性保障并发安全。
本文介绍如何使用 Python 的 pyecharts v1 版本绘制中国和世界地图。文章详细说明了 v0.5.X 与 v1 版本的兼容性及 Python 版本要求,并提供了完整的代码示例,包括数据准备、地图初始化、全球选项设置及 HTML 文件生成与打开方法,帮助开发者快速掌握地图可视化技能。
本文对比了Python单线程与多线程爬虫的性能差异,详细讲解了如何使用multiprocessing.dummy模块中的Pool类构建线程池。通过具体代码案例,展示了如何利用线程池处理阻塞型网络请求,从而显著缩短视频数据下载时间,适用于需要批量处理耗时操作的场景。
本文介绍如何使用Python构建一个简单的IP代理池。通过requests库从指定网站抓取IP数据,利用正则表达式提取IP和端口,并结合telnetlib库进行连通性测试,筛选出可用的代理IP并保存至文件。
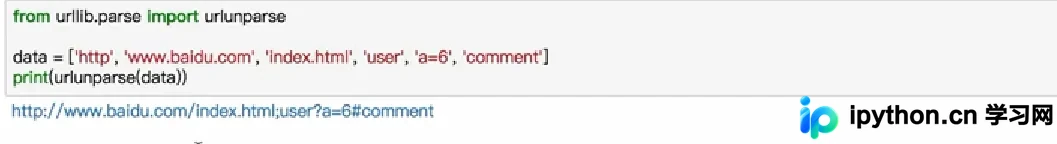
本文详细介绍Python内置urllib库的四大核心模块:urllib.request用于发起HTTP请求,urllib.error处理网络异常,urllib.parse解析与拼接URL,以及urllib.robotparser解析robots.txt。通过对比Python 2与3的差异,演示urlopen、Request对象、代理设置、Cookie处理及参数编码等关键用法,帮助开发者掌握底层网络请求原理。
本文详解Python3中自定义排序的两种实现方式:通过functools.cmp_to_key使用cmp函数,以及重写类的比较运算符(__lt__等)。文章对比了Python2与Python3的差异,提供了基于二维点的排序示例及完整代码,帮助开发者掌握Python3中的排序技巧。
本文详解 LeetCode 1805 题的 C++ 解题思路。核心在于将非数字字符替换为空格后提取连续数字串,通过去除前导零规范格式(如 01 和 1 视为相同),利用 unordered_set 进行自动去重计数。算法时间复杂度 O(N),空间复杂度 O(N)。
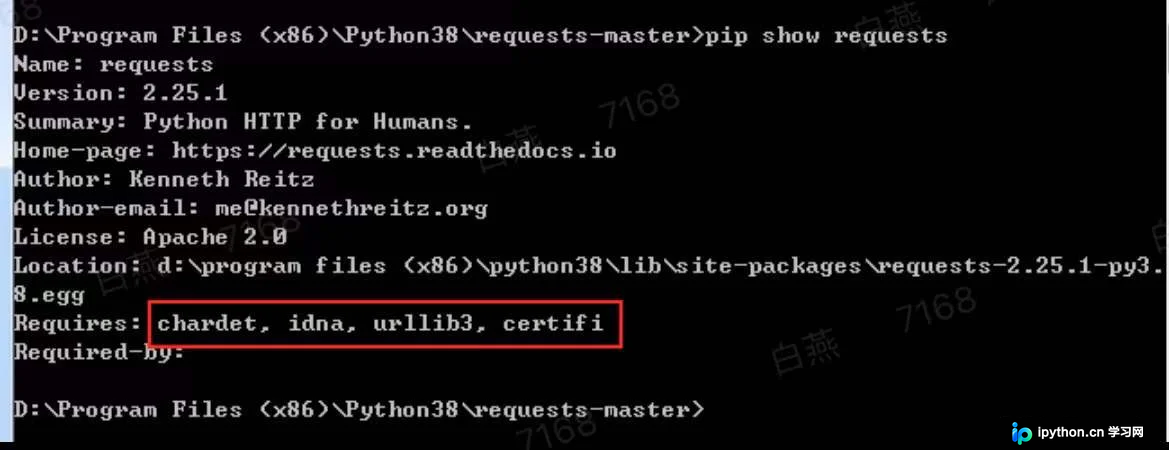
本文详细记录了在 Windows 7 环境下,针对 Python 3.8.9 版本进行离线安装 requests 库的完整流程。文章涵盖了从检查依赖包(chardet, idna, urllib3, certifi)到下载源码及 whl 文件,再到通过命令行逐一安装依赖并最终安装 requests 的全过程。特别指出了在 Win7 系统中可能遇到的 pip 解析器警告及忽略报错的方法,帮助用户在无网络环境下成功配置开发环境。
本文详细解析Python Flask微框架的核心功能,涵盖环境安装、调试模式开启、路由与路径变量定义、URL构造、HTTP方法处理、静态文件与模板渲染,以及请求参数、文件上传、Session管理和错误处理等关键实战技巧,帮助开发者快速构建Web应用。
本文介绍如何在Python中递归查找包含特定关键字的文件,并处理多层目录结构下的文件读取问题。同时提供使用os和shutil模块删除文件或文件夹的多种方法,包括单文件删除、递归删除目录及清理解压后文件的实用代码示例,帮助提升文件处理效率。
本文介绍如何使用Python Pandas库筛选或删除数据框中指定列包含特定值的行。通过isin()函数结合逻辑取反符号~,可以精准提取包含或排除特定数值(如货币代号1)的数据,并演示了多列组合条件下的行删除操作,适用于常见数据清洗场景。
Go语言摒弃了传统的继承机制,转而采用组合思想提升代码复用。本文详解如何通过结构体嵌入复用字段与方法,以及如何通过接口嵌合集成功能集,并提供完整示例展示其实现逻辑与实际应用场景。