Python with语句用法原理详解
本文深入解析Python中with语句的运行原理。通过剖析__enter__()和__exit__()两个核心魔术方法的调用时机,详细说明了在正常执行与发生异常两种情况下,代码块的执行顺序及异常处理机制。
2026-10-11
23

本文深入解析Python中with语句的运行原理。通过剖析__enter__()和__exit__()两个核心魔术方法的调用时机,详细说明了在正常执行与发生异常两种情况下,代码块的执行顺序及异常处理机制。
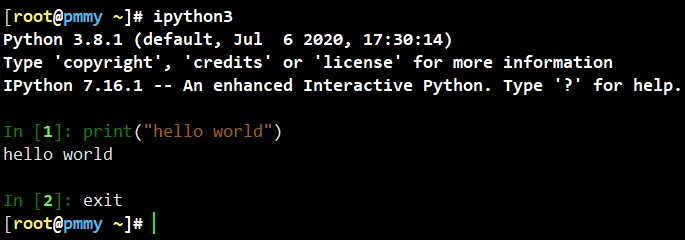
本文详细解析Python3环境下交互式shell ipython3的安装与使用。通过pip3命令快速安装,体验自动补全、自动缩进及Bash命令支持等核心功能。相比默认Python shell,IPython提供更高效的交互体验,是Python开发者的必备工具。
本文详细解析Python序列解包的底层机制与实战应用场景。内容涵盖多变量同步赋值、无需临时变量交换数值、函数多返回值提取、嵌套数据结构解析。同时深度说明下划线占位符与星号收集操作符的具体规则及边界条件,附带标准代码示例与常见报错排查指南,助力开发者编写更简洁高效的Python代码。
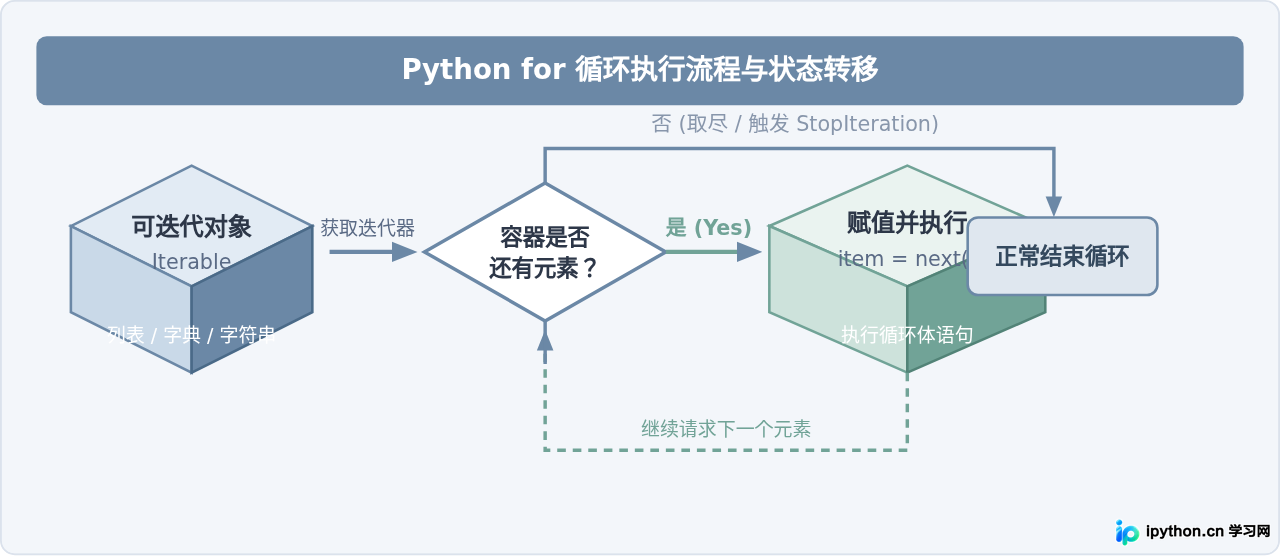
本文详细讲解如何使用 Python 中的 for 循环依次遍历列表、字典和字符串三种常用数据类型,结合代码示例、执行过程图解与常见问题排查,帮助读者掌握基础迭代操作。
Python语言通过缩进而非括号来识别代码块,这是其核心语法特征。本文详细解析缩进在if、for、while及函数定义中的作用,说明冒号的必要性及空格一致性要求,并提供C语言与Python的代码对比示例,帮助开发者掌握正确的缩进规范。
本文详解Python中的进制转换方法。通过bin()、oct()、hex()及int()内置函数可快速实现十进制与二、八、十六进制互转。同时结合取余整除与加权求和原理,提供完整的自定义转换函数代码,帮助开发者掌握底层逻辑并直接应用于项目计算。
本文详细解析Scrapy框架中items文件夹的标准工作流程。通过创建继承自scrapy.Item的结构化数据类,在Spider解析函数中提取并填充字段,最后经settings.py配置的Pipeline管道进行清洗或入库,可彻底告别松散字典传递,实现高效稳健的爬虫数据管理。
本文详解sklearn中predict_proba与predict的区别。predict_proba返回所有类别的概率值,列数由分类数量决定,按self.classes_排序。通过示例展示如何解读概率值(如大于0.5判定为某类),并对比predict直接返回预测标签。包含逻辑回归与SVM的完整代码及可视化示例,帮助理解概率输出机制。
本文介绍如何使用Python与Pillow库实现单张及批量图片裁剪。涵盖环境准备、坐标定义规范、单图裁剪逻辑及带文件夹遍历的批量处理方案。通过自动计算边界并统一输出格式,快速完成图像预处理任务,显著降低人工操作成本。
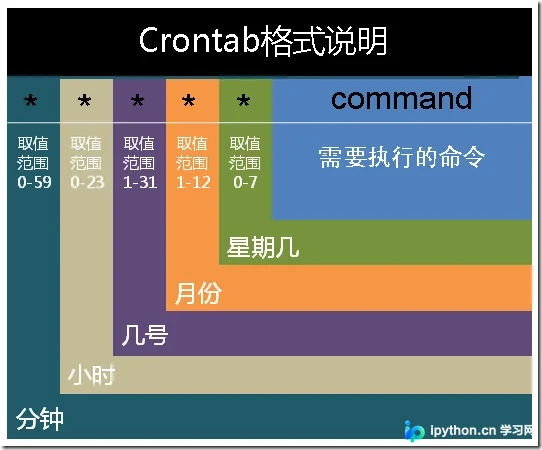
本文介绍在 CentOS 7 系统中利用 crontab 实现 Python 脚本定时执行的方法。内容涵盖 crontab 的安装、时间表达式语法解析、Python 路径确认以及任务的添加与重启服务。
本文深入解析 Python 字符串池化机制,探讨 CPython 如何通过内存复用提升性能。重点分析空字符串、单字符、含下划线及特殊字符的池化规则,以及常量折叠在编译期的作用。通过 id() 函数和 is 运算符验证不同场景下的对象引用关系,揭示长度限制对池化的影响。
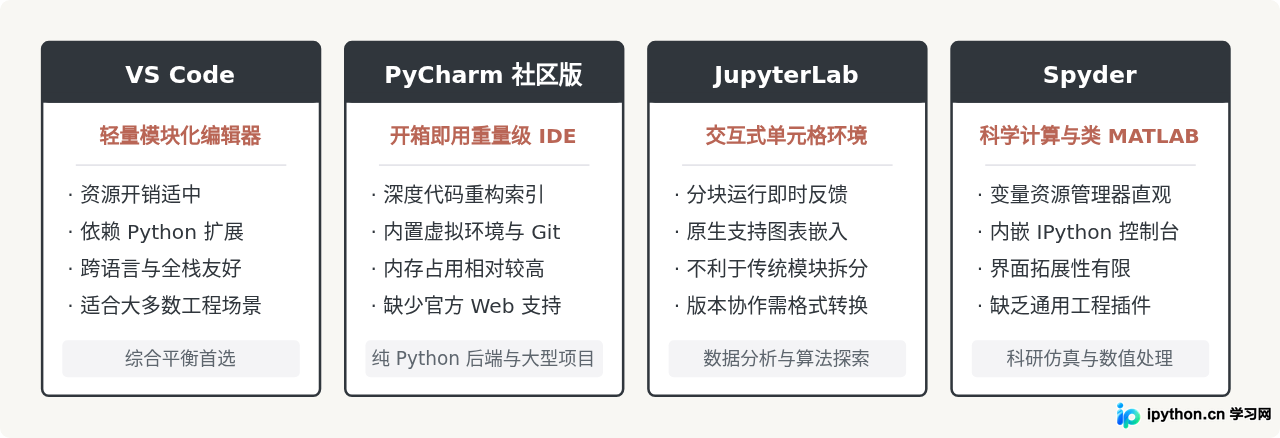
针对Python初学者与进阶开发者的免费且好用的IDE推荐指南,深度对比VS Code、PyCharm社区版、JupyterLab与Spyder的核心差异、适用场景、安装配置流程与选型依据。