

Python生成requirements.txt的两种方法及pipreqs推荐
本文介绍Python项目中requirements.txt的作用及生成方法。对比了pip freeze(生成全量依赖,推荐配合虚拟环境使用)与pipreqs(仅扫描项目实际引用,更精准)两种工具。重点讲解pipreqs的安装与参数用法,并辨析setup.py与requirements.txt的共存关系,帮助开发者优化依赖管理流程。
2026-10-15
7

本文介绍Python项目中requirements.txt的作用及生成方法。对比了pip freeze(生成全量依赖,推荐配合虚拟环境使用)与pipreqs(仅扫描项目实际引用,更精准)两种工具。重点讲解pipreqs的安装与参数用法,并辨析setup.py与requirements.txt的共存关系,帮助开发者优化依赖管理流程。
本文介绍基于Python Socket的TCP/IP网络通信基础,涵盖UTF-8与UTF-16编码的空间效率对比及适用场景。通过服务端与客户端代码示例,演示如何建立连接并执行远程系统命令,包括文件查看、目录管理及弹窗调用等具体操作,旨在提供技术层面的原理说明。
本文详解JavaScript实现表单验证的方法,涵盖通过onsubmit提交前校验及HTML5内置required属性。重点解析Constraint Validation API,利用checkValidity()、validity对象属性及setCustomValidity方法实现动态错误提示与自定义校验逻辑,提升前端交互体验。
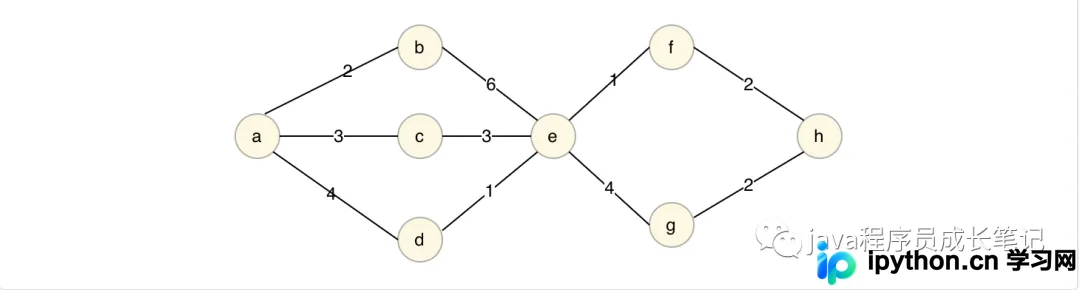
本文详细解析Dijkstra(迪杰斯特拉)单源最短路径算法的核心原理,针对Java标准库优先队列不支持值更新的痛点,提供完整的最小堆实现方案。通过图文步骤演示算法执行过程,并给出包含邻接矩阵、节点管理类及测试用例的Java代码实现,帮助开发者快速掌握该算法在实际工程中的应用。
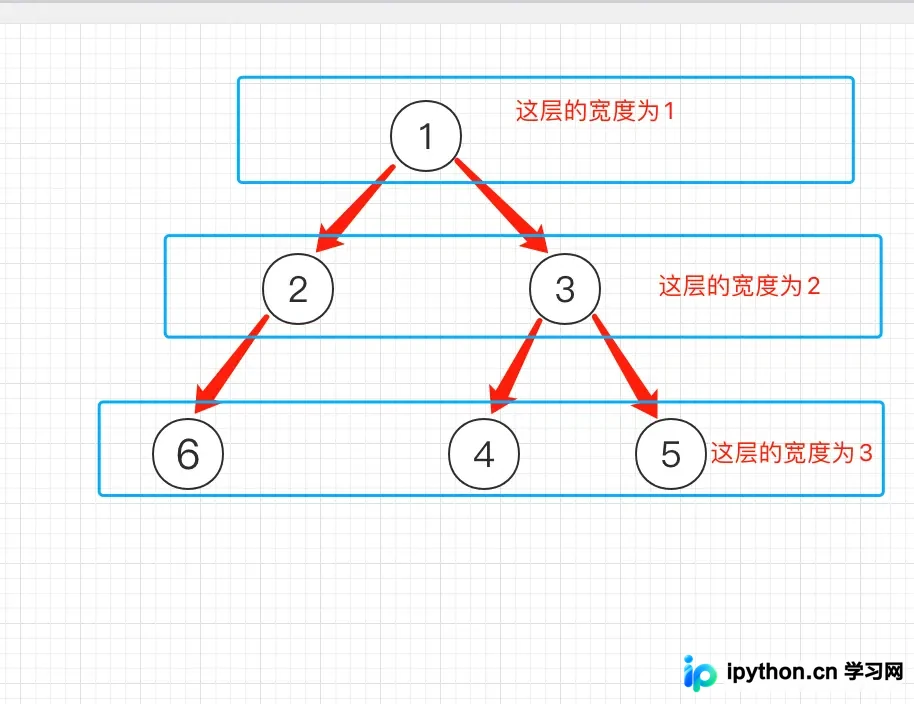
本文介绍利用Go语言和队列数据结构,通过层序遍历算法求解二叉树的最大宽度及其所在层级。文章提供了完整的数据结构定义、核心算法逻辑图解及可直接运行的测试代码,适用于算法学习与面试准备。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
本文介绍SQL Server中T-SQL标识符的命名规范,包括常规标识符与带分隔符标识符的规则。同时提供两种在表中无排序生成序号的方法:使用ROW_NUMBER()配合SELECT 0,以及利用IDENTITY函数创建临时表并提取序号。
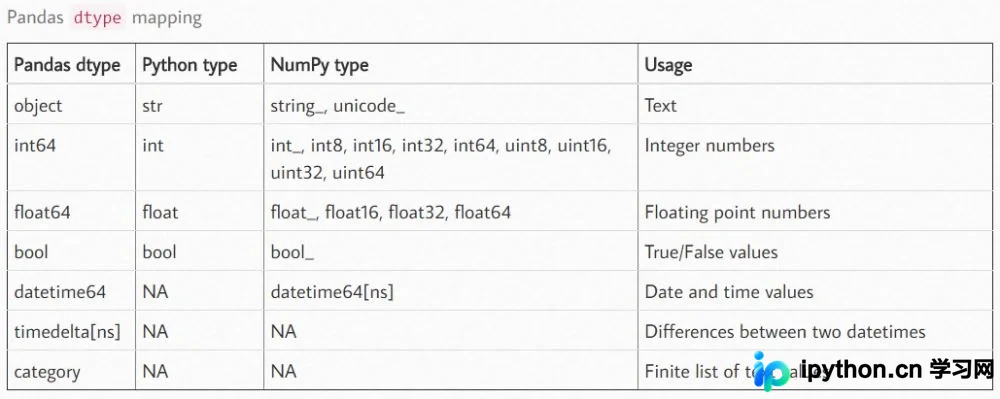
本文详细介绍Pandas中查看和转换数据类型的核心方法。通过df.dtypes、df.shape及df.info()快速获取数据框的维度、列名、非空计数及内存占用等关键信息。重点讲解df.astype()函数的多种用法,包括全局转换、指定列转换及索引类型转换,并深入解析object类型的特殊性及其清洗策略,帮助开发者高效处理数据格式问题。
本文详细解析Python中静态方法@staticmethod的定义与使用。静态方法既不需要访问实例属性也不需要访问类属性,通过@staticmethod装饰器定义,无需self或cls参数。可通过类名或实例对象调用,有助于减少内存占用并提升性能。文章包含多个代码示例,对比实例方法、类方法与静态方法的差异,帮助开发者合理封装逻辑。
本文系统整理了Python中Pandas库的45个高频实用命令,涵盖数据读取、类型转换、缺失值处理、时间序列分析及数据可视化等核心场景。通过具体代码示例,帮助开发者快速掌握高效处理大型数据集的方法,提升数据分析与建模效率。
本文详细解析NumPy中asarray函数的用法,包括输入数据、数据类型和存储顺序等参数。重点对比array、asarray和asanyarray在内存复制、子类处理及copy/subok参数下的行为差异,通过代码实例说明何时生成副本及何时共享内存。
本文通过反汇编代码深入解析Go语言的函数调用约定与多返回值机制。研究表明,Go遵循类似__stdcall的调用规范,参数自右向左经栈传递并在调用后清理。对于多返回值,Go采用巧妙的“隐式指针”技术:将返回值直接映射到函数栈帧的参数位置,在被调函数内部填充,由调用方负责取值拷贝,从而在不改变底层架构的前提下实现了语法层面的多返回值支持。