

Java实现Dijkstra算法:图解与自定义最小堆代码

Dijkstra算法是解决赋权图中单源最短路径问题的经典贪心算法。本文将深入剖析其工作原理,并重点解决Java环境下因PriorityQueue缺乏动态更新功能而需要手动构建最小堆的技术难点,提供可直接运行的完整代码与图解说明。
算法原理与图解
Dijkstra算法主要特点是以起始点为中心向外层层扩展,直到扩展到终点为止。该算法适用于计算一个节点到其他所有节点的最短路径,但要求图中不存在负权边。对于无向图G=(V,E),若每条边E(i)拥有长度W(i),算法旨在求出由源顶点V0到各目标节点的最短距离。
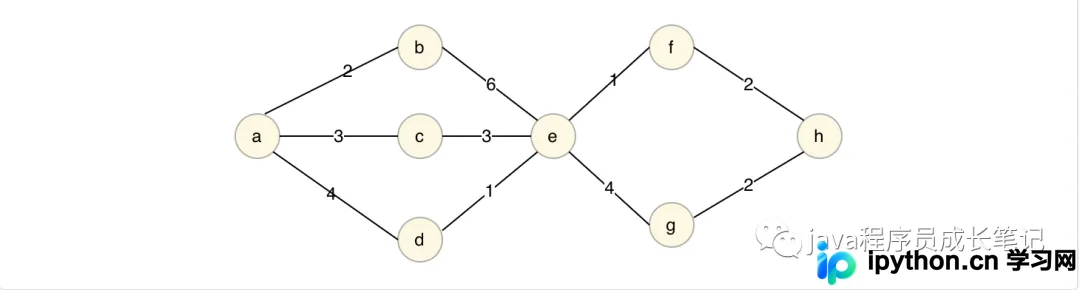
核心工作逻辑
算法通过将顶点集合划分为两组来逐步推进:已确定组(finallyNodes)存储最终求得最短路径的顶点,未确定组(processNodes)存储剩余待求解节点。
具体操作流程如下:
- 初始化分组:将源节点加入 finallyNodes,其路径长度为0;其余所有节点加入 processNodes。若节点与源节点直接相连,初始距离设为边权重,否则设为无穷大(∞)。
- 选择最近节点:从 processNodes 中选择当前记录距离最小的顶点,将其移入 finallyNodes。
- 松弛更新:以新加入的顶点为中转点,检查其与 processNodes 中其他节点的连接。如果经过该中转点能使邻居节点的距离变短,则更新 processNodes 中的距离值为:
min(原距离, 当前节点最短路径 + 边权重)。 - 循环执行:重复步骤2和3,直到 processNodes 变为空集,此时所有节点的最短路径均已确定。
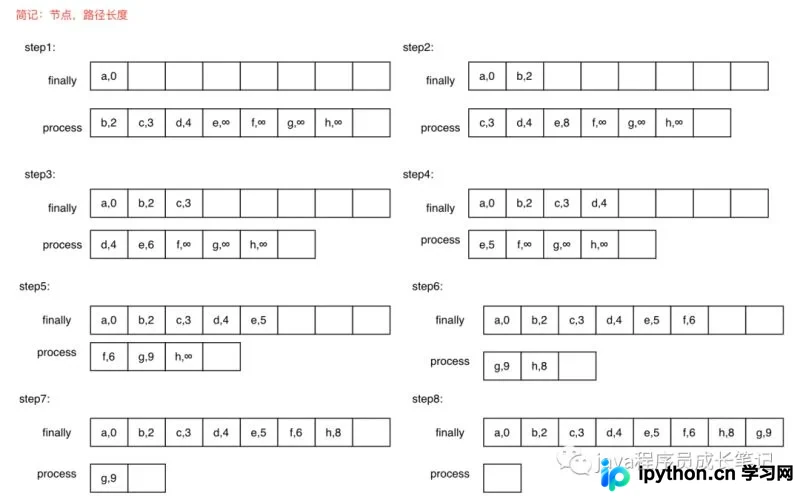
Java实现策略:为何需要自定义堆?
在实现 Dijkstra 的过程中,我们需要频繁执行“查找最小值”、“删除最小值”以及关键操作:“更新某节点在集合中的距离值”。
虽然 Java 提供了 java.util.PriorityQueue,但它仅支持插入和移除堆顶元素,并不支持直接修改堆内部任意元素的值并自动重排。因此,为了高效完成状态更新,必须自行实现一个小根堆(MinHeap),使其具备以下能力:
- 维护节点索引与对应距离的映射。
- 支持
pop()获取并移除最小距离节点。 - 支持
changeValue(index, newValue)在知道位置时更新距离并调整堆结构。
第1步:构建自定义最小堆类
首先实现底层数据结构的调整方法。堆中存储格式定义为 int[][],其中 [0] 存节点下标,[1] 存距离值,排序依据为距离值。
public class MinHeap {
    List heap;

    /**
     * 获取并移除堆顶元素,并调整堆结构
     * @return 堆顶元素 {节点索引, 距离}
     */
    public int[][] pop() {
        if (isEmpty()) return null;
        int[][] top = heap.get(0);
        // 将最后一个元素移到顶部
        heap.set(0, heap.get(heap.size() - 1));
        heap.remove(heap.size() - 1);
        // 向下调整恢复最小堆性质
        this.adjust(0, heap.size() - 1);
        return top;
    }

    /**
     * 判断是否为空
     */
    public boolean isEmpty() {
        return null == this.heap || this.heap.size() == 0;
    }

    /**
     * 修改index位置节点的value值,并调整最小堆
     * 注意:由于只可能变小,通常向上调整效率更高,此处提供通用处理
     */
    public void changeValue(int index, int value) {
        int src = heap.get(index)[1];
        heap.get(index)[1] = value;
        // 比较当前值是变大还是变小,决定上浮或下沉
        if (src > value) {
            this.upAdjust(index);
        } else {
            this.adjust(index, heap.size() - 1);
        }
    }

    /**
     * 向上调整:用于当值变小时,元素向根部移动
     */
    public void upAdjust(int index) {
        while (index > 0) {
            int parent = index >> 1;
            // 父节点已经比当前小,无需继续调整
            if (heap.get(parent)[1] <= heap.get(index)[1]) {
                break;
            }
            swap(index, parent);
            index = parent;
        }
    }

    /**
     * 初始化最小堆
     */
    public void init(int[][] nums) {
        heap = new ArrayList<>(nums.length);
        for (int[] num : nums) {
            // 拷贝一份避免引用问题
            int[] temp = new int[]{num[0], num[1]};
            heap.add(temp);
        }
        // 从最后一个非叶子节点开始自底向上建堆
        for (int i = nums.length / 2; i >= 0; --i) {
            this.adjust(i, nums.length - 1);
        }
    }

    /**
     * 向下调整:维持最小堆性质
     */
    private void adjust(int index, int end) {
        while (index <= end) {
            int left = index << 1; // 左孩子
            // 找左右孩子中较小的那个
            if (left + 1 <= end && heap.get(left + 1)[1] < heap.get(left)[1]) {
                ++left;
            }
            // 如果孩子都比自己大,或者没有孩子了,则终止
            if (left > end || heap.get(index)[1] <= heap.get(left)[1]) {
                break;
            }
            swap(index, left);
            index = left;
        }
    }

    private void swap(int i, int j) {
        int[] temp = heap.get(i);
        heap.set(i, heap.get(j));
        heap.set(j, temp);
    }
}
第2步:封装图的节点与初始化逻辑
采用邻接矩阵存储图结构,便于快速查询任意两节点间的权重。我们需要创建 Node 类来标记节点,并使用二维数组记录边的权重。不相邻的节点权重记为 Integer.MAX_VALUE。
// 节点定义
class Node {
    char value;
    Node(char value) { this.value = value; }
}

public class Dijkstra {
    Node[] nodes;
    int[][] adjacencyMatrix;
    boolean[] visited;
    List finallyNodes; // 记录最终结果:{节点索引, 最短距离}
    MinHeap processNodes;   // 记录求解过程

    /**
     * 初始化图结构
     * @param values 节点标识字符数组
     * @param edges 边信息字符串数组,格式如 "0,1,2" (索引A, 索引B, 权重)
     */
    private void initGraph(char[] values, String[] edges) {
        nodes = new Node[values.length];
        for (int i = 0; i < values.length; i++) {
            nodes[i] = new Node(values[i]);
        }

        // 初始化全为最大整数
        adjacencyMatrix = new int[values.length][values.length];
        for (int i = 0; i < values.length; i++) {
            Arrays.fill(adjacencyMatrix[i], Integer.MAX_VALUE);
            adjacencyMatrix[i][i] = 0; // 自身到自身距离为0
        }

        // 根据输入更新实际边权重(本例为无向图)
        for (String edge : edges) {
            String[] parts = edge.split(",");
            int u = Integer.parseInt(parts[0]);
            int v = Integer.parseInt(parts[1]);
            int w = Integer.parseInt(parts[2]);
            adjacencyMatrix[u][v] = w;
            adjacencyMatrix[v][u] = w;
        }
        visited = new boolean[nodes.length];
    }
}
第3步:执行 Dijkstra 核心算法
在初始化完成后,将源节点加入 finallyNodes,其余节点根据与源节点的距离放入 processNodes(最小堆)。随后进入循环:取出最小距离节点,尝试更新相邻节点的记录距离。
    /**
     * 初始化算法必要的两个集合
     */
    private void initDijkstra(int startNodeIndex) {
        finallyNodes = new ArrayList<>();
        processNodes = new MinHeap();

        // 源节点初始化
        finallyNodes.add(new int[]{startNodeIndex, 0});
        visited[startNodeIndex] = true;

        // 其他节点初始化距离
        int[][] processData = new int[nodes.length - 1][2];
        int j = 0;
        for (int i = 0; i < nodes.length; i++) {
            if (i == startNodeIndex) continue;
            processData[j][0] = i;
            processData[j][1] = adjacencyMatrix[startNodeIndex][i];
            j++;
        }
        processNodes.init(processData);
    }

    /**
     * Dijkstra 算法主循环
     */
    public void run() {
        while (!processNodes.isEmpty()) {
            // 1. 弹出当前距离最近的节点
            int[][] current = processNodes.pop();
            int currentNodeIndex = current[0];
            int currentDist = current[1];

            // 加入最终集合
            finallyNodes.add(current);
            visited[currentNodeIndex] = true;

            // 2. 遍历所有可能的邻居节点进行松弛操作
            for (int neighborIdx = 0; neighborIdx < nodes.length; neighborIdx++) {
                // 跳过已处理的节点或不相连的节点
                if (visited[neighborIdx] || adjacencyMatrix[currentNodeIndex][neighborIdx] == Integer.MAX_VALUE) {
                    continue;
                }

                int newDist = currentDist + adjacencyMatrix[currentNodeIndex][neighborIdx];

                // 3. 寻找该邻居在 processNodes 堆中的位置并更新
                // 注意:实际生产中可通过 HashMap 优化搜索位置的过程,这里按题目逻辑遍历查找
                for (int i = 0; i < processNodes.heap.size(); i++) {
                    if (processNodes.heap.get(i)[0] == neighborIdx) {
                        int oldDist = processNodes.heap.get(i)[1];
                        if (newDist < oldDist) {
                            processNodes.changeValue(i, newDist);
                        }
                        break;
                    }
                }
            }
        }
    }
}
测试运行与结果分析
以下测试用例构建了包含8个节点(A-H)的无向图,指定起点索引为0(即节点A)。通过打印 finallyNodes 列表即可得到 A 到各点的最短路径。
public static void main(String[] args) {
    char[] values = new char[]{'A','B','C','D','E','F','G','H'};
    // 边格式: start_index,end_index,weight
    String[] edges = {
        "0,1,2", "0,2,3", "0,3,4",
        "1,4,6", "2,4,3", "3,4,1",
        "4,5,1", "4,6,4", "5,7,2", "6,7,2"
    };

    Dijkstra dijkstra = new Dijkstra();
    dijkstra.initGraph(values, edges);
    int startNodeIndex = 0;
    dijkstra.initDijkstra(startNodeIndex);
    dijkstra.run();

    System.out.println("=== 计算结果 ===");
    for (int[] node : dijkstra.finallyNodes) {
        char nodeName = dijkstra.nodes[node[0]].value;
        System.out.printf("%c 距离 %c 的最短路径为:%d\n",
                          nodeName, dijkstra.nodes[startNodeIndex].value, node[1]);
    }
}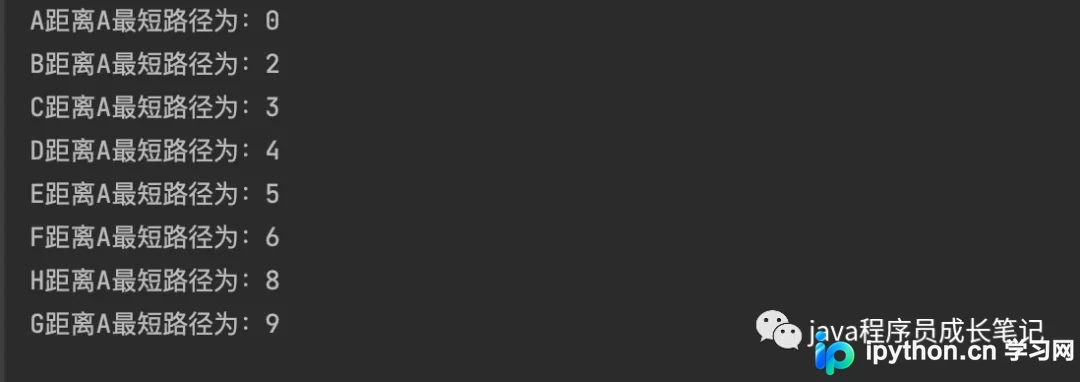
程序输出将展示源点到每个节点的具体距离数值。通过对比图解步骤与代码逻辑,可以清晰地看到邻接矩阵如何反映连通性,以及最小堆如何确保每次都能选取当前全局最优的子问题进行扩展。
以上就是详解Java中Dijkstra(迪杰斯特拉)算法的图解与实现的详细内容,更多关于Java最短路径算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









