

减少Python循环:列表推导式与enumerate的最佳实践
本文探讨如何在Python中减少显式for循环的使用,以提升代码的可读性与执行效率。通过列表推导式(List Comprehension)和字典推导式(Dictionary Comprehension),可以一行代码完成复杂的过滤与计算逻辑。同时,介绍enumerate函数在需要索引时的正确用法,帮助开发者写出更Pythonic的代码。
2026-10-12
33

本文探讨如何在Python中减少显式for循环的使用,以提升代码的可读性与执行效率。通过列表推导式(List Comprehension)和字典推导式(Dictionary Comprehension),可以一行代码完成复杂的过滤与计算逻辑。同时,介绍enumerate函数在需要索引时的正确用法,帮助开发者写出更Pythonic的代码。
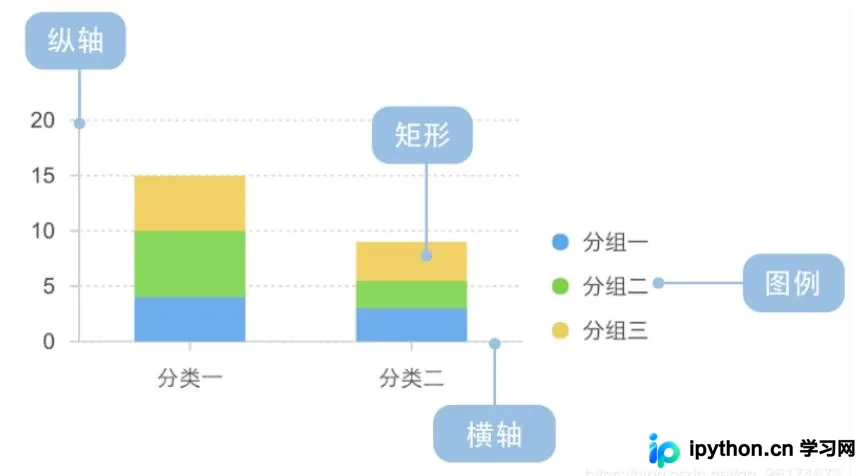
本文介绍如何使用Python的Matplotlib库绘制堆叠柱状图,展示各分类占比及与整体的关系。通过读取Excel文件数据,利用循环和bottom参数实现柱状图的堆叠效果,并自定义颜色与图例。
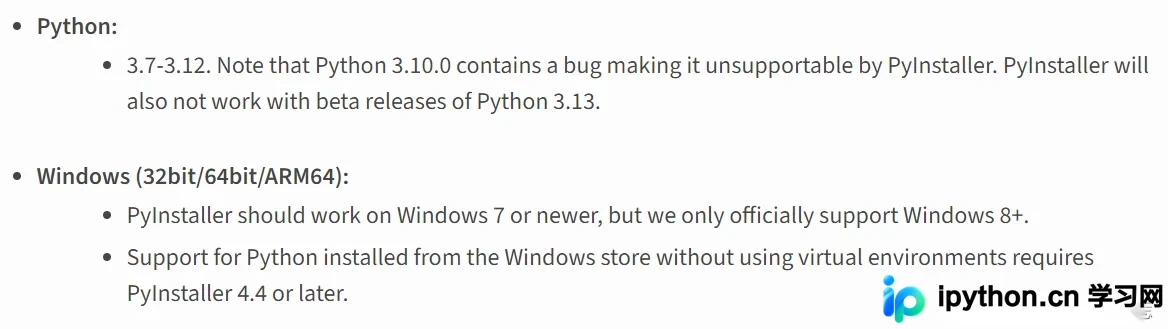
将Python脚本打包为exe时,常因环境版本不匹配、路径含特殊字符或依赖库方法弃用导致报错。本文介绍从版本校验、路径清理到日志分析与代码修正的标准排查流程,帮助快速解决打包失败问题。
本文介绍如何在 Python 中使用 for 循环实现累加求和。通过定义累加器变量,利用 range 函数生成数字序列,并在循环中逐步累加,最终输出结果。文章提供了完整的代码示例,包括输入处理、循环逻辑和结果打印,帮助初学者快速掌握基础编程技巧。
本文深入解析Python中利用Borg模式实现单例模式的原理与代码。通过共享状态字典__shared_state,确保所有实例拥有相同的属性值,从而在对象标识符不同的情况下实现逻辑上的单例。文章包含完整代码示例及运行结果分析,帮助开发者理解状态共享机制。
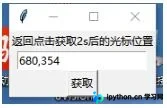
本文介绍如何使用Python3结合pyautogui和tkinter库,开发一个带有图形界面的鼠标位置获取工具。通过简单的代码实现,用户可以在指定延迟后获取当前鼠标的坐标位置,并在界面中显示结果。
本文详解Python中动态创建、查询和删除变量名的方法。通过操作locals()和globals()字典实现变量名的动态绑定,利用inspect库获取变量名,并演示如何安全地删除变量。文章包含具体代码示例,帮助开发者理解变量作用域与动态编程技巧。
针对体积庞大导致内存溢出的遥感TIFF数据,本文介绍基于Python与GDAL库的分段处理方案。通过按行划分批次、过滤无效值、执行像素级运算后分批写入磁盘,最终利用算术叠加完成多块TIF文件的无损拼接,并提供创建基准空白底图的配套方法。
将Python脚本转换为独立运行的可执行文件能有效解决终端环境缺失问题。本文系统对比PyInstaller、Nuitka、cx_Freeze等核心工具的底层机制与配置差异,提供从零开始的命令行参数、依赖处理流程及体积优化技巧,帮助开发者快速输出符合目标平台的稳定安装包,并纠正传统认知中的跨平台编译误区。
本文详细介绍 LangChain 框架对接大语言模型(LLM)的核心用法,涵盖文本补全与对话模式的底层逻辑、基础接口调用、自定义模型继承方法,以及异步调用、内存缓存、流式响应和 Token 统计等高级配置指南。
本文系统梳理了Python最核心的内置函数,覆盖基础数学计算、数据结构转换、迭代控制及对象反射等场景。文中详细讲解abs()、dict()、min()等工具的参数特征与使用逻辑,并配套提供可运行的代码示例。无论是初学者入门参考,还是开发者日常查阅,均可快速掌握其最佳实践,从而提升编码效率与代码可读性。
本文解析选择Python进行数据分析的五大核心优势,包括丰富的库生态、跨语言集成能力及持续创新的算法实现。同时详细指导如何配置Anaconda环境,通过命令行启动Jupyter Notebook服务,并介绍Cell操作、Markdown转换及多IDE集成等关键实操步骤,帮助开发者快速搭建高效的数据分析工作流。