

Python使用GDAL实现超大遥感TIF数据的分段读写与拼接

针对体积庞大导致内存溢出的遥感TIFF数据,本文介绍基于Python与GDAL库的分段处理方案。通过按行划分批次、过滤无效值、执行像素级运算后分批写入磁盘,最终利用算术叠加完成多块TIF文件的无损拼接,并提供创建基准空白底图的配套方法。
环境准备与数据规划
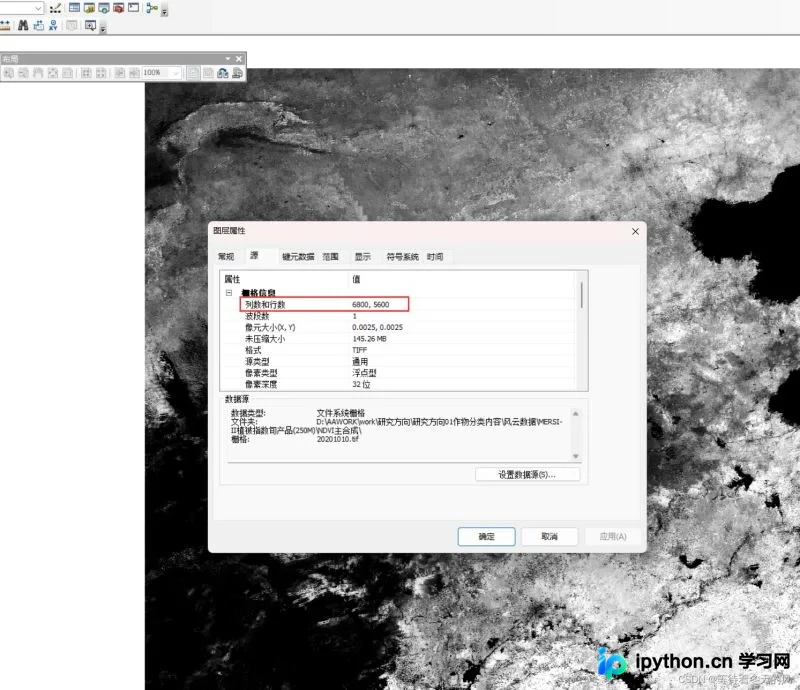
在处理分辨率极高(如5600×6800以上)的遥感栅格数据时,直接调用 dataset.ReadAsArray() 极易触发内存泄漏。采用分段(Block Processing)策略可将内存占用控制在常数级别。本方案依赖 osgeo.gdal 与 numpy,适用于Windows/Linux环境。
第1步:创建基准空白TIF文件
目的:为后续批量写入提供带有正确地理空间参考(仿射变换、投影信息)的底图框架。入口:打开已知尺寸的源TIFF。动作:复制几何属性,将阵列初始化为指定背景值(通常为0)。参数:输出路径、数据类型。完成状态:生成尺寸一致且全零的栅格文件。
from osgeo import gdal
import numpy as np

def create_blank_tif(src_path, out_path):
    ds = gdal.Open(src_path)
    if ds is None:
        raise FileNotFoundError(f"无法读取源文件: {src_path}")
    col, row = ds.RasterXSize, ds.RasterYSize
    geotrans = ds.GetGeoTransform()
    proj = ds.GetProjection()

    driver = gdal.GetDriverByName("GTiff")
    # 保持原始数据类型或根据需求调整,此处使用Float32
    dataset = driver.Create(out_path, col, row, 1, gdal.GDT_Float32)
    dataset.SetGeoTransform(geotrans)
    dataset.SetProjection(proj)

    # 高效填充零值,替代低效的双重循环
    band = dataset.GetRasterBand(1)
    band.WriteArray(np.zeros((row, col), dtype=np.float32))
    band.FlushCache()
    dataset = None
dc = None
第2步:配置分段读取策略与批量计算
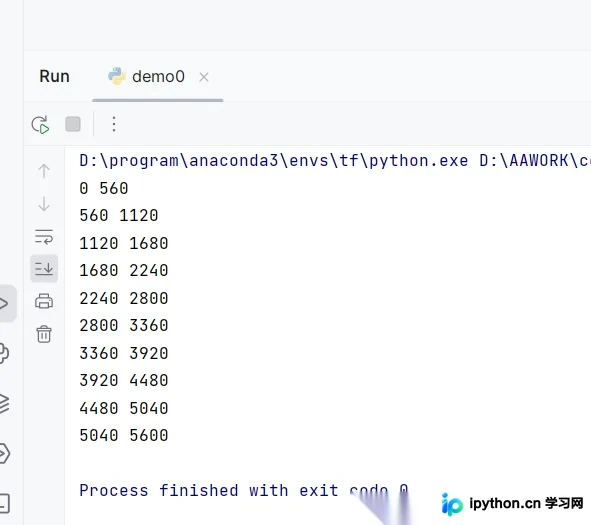
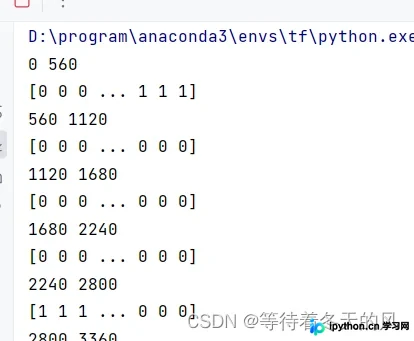
目的:避免一次性加载全图,按需切片并执行像素级逻辑(如多景NDVI求和过滤缺失值)。入口:定义行跨度列表 list_row = [0, 560, 1120, ..., 5600]。动作:遍历跨度区间,提取对应行切片,过滤 <= -3 的噪声及NaN,累加有效像素。参数:起止行号 row0, row1,列宽 col,输入阵列 data1, data2 等。完成状态:返回当前片段的计算结果列表。
def get_section(row0, row1, col, *arrays):
    """分段读取并进行计算"""
    res_list = []
    for i in range(row0, row1):
        current_vals = []
        for j in range(col):
            # 收集多通道/多文件对应位置的值
            vals = [arr[i][j] for arr in arrays]
            # 剔除超过两个缺失值的无效像素
            nan_count = sum(1 for v in vals if np.isnan(v))
            if nan_count <= 1:
                current_vals.append(int(sum(v for v in vals if not np.isnan(v))))
        res_list.extend(current_vals)
    return np.array(res_list)
第3步:按批次导出并保留地理坐标
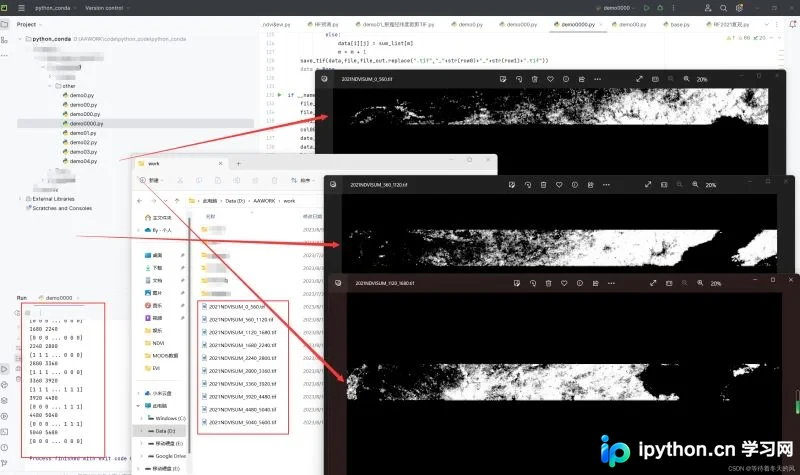
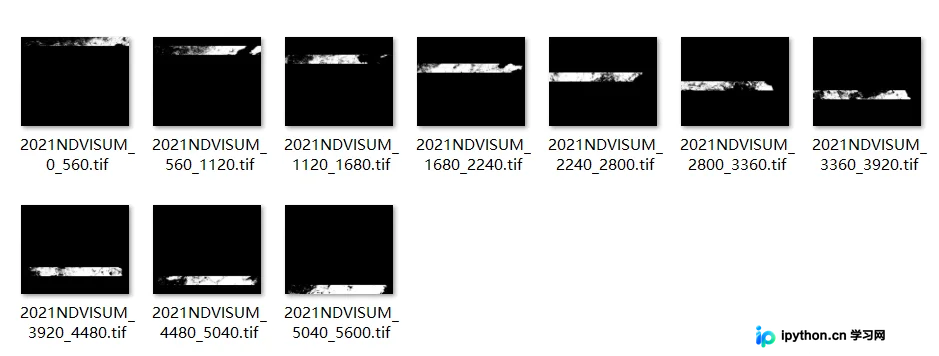
目的:将计算结果写回独立切片,确保每个文件携带完整的空间定位信息以便后续GIS软件识别。入口:切片结果 sum_list、原文件参考 src_ds。动作:重塑为一维网格,调用 driver.Create 写入波段并刷新缓存。参数:输出文件名、阵列形状。完成状态:目录内生成带命名规则(如 _0_560.tif)的中间TIF。
def save_section_to_tif(sum_list, row0, row1, col, src_ds, out_dir):
    # 重塑为二维栅格结构
    segment_data = np.array(sum_list).reshape(len(sum_list)//col, col)
    filename = f"segment_{row0}_{row1}.tif"
    out_path = os.path.join(out_dir, filename)

    driver = gdal.GetDriverByName("GTiff")
    dataset = driver.Create(out_path, col, len(segment_data), 1, gdal.GDT_Float32)
    dataset.SetGeoTransform(src_ds.GetGeoTransform())
    dataset.SetProjection(src_ds.GetProjection())
    # 动态调整仿射变换中的Y原点,保证拼接时位置准确
    y_offset = src_ds.GetGeoTransform()[3] + (row0 * src_ds.GetGeoTransform()[5])
    geo = list(dataset.GetGeoTransform())
    geo[3] = y_offset
    dataset.SetGeoTransform(tuple(geo))

    dataset.GetRasterBand(1).WriteArray(segment_data.astype(np.float32))
    dataset.FlushCache()
    dataset = None
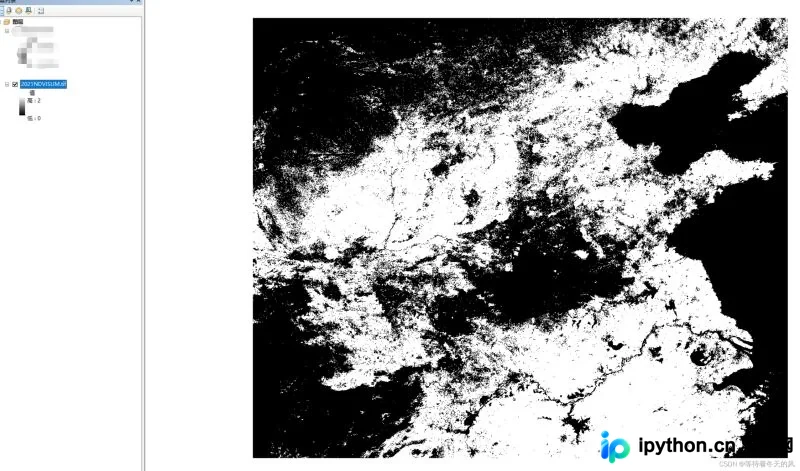
第4步:分段结果拼接还原为完整栅格
目的:将生成的多个切片合并为单一标准文件,供下游业务调用。入口:切片文件夹、空白底图。动作:逐片读取并执行矩阵加法累积至底图。参数:路径列表。完成状态:输出路径写入完整尺寸的合成TIF。
def merge_segments(seg_dir, base_path, final_out):
    ds_base = gdal.Open(base_path)
    ds_driver = gdal.GetDriverByName("GTiff")
    acc_data = np.load(os.path.join(seg_dir, "accumulator.npy")) if os.path.exists(os.path.join(seg_dir, "accumulator.npy")) else np.zeros_like(ds_base.ReadAsArray())

    for fname in sorted(os.listdir(seg_dir)):
        if fname.startswith("segment_") and fname.endswith(".tif"):
            seg_path = os.path.join(seg_dir, fname)
            seg_data = gdal.Open(seg_path).ReadAsArray().astype(np.float32)
            acc_data += seg_data

    ds_final = ds_driver.Create(final_out, ds_base.RasterXSize, ds_base.RasterYSize, 1, gdal.GDT_Float32)
    ds_final.SetGeoTransform(ds_base.GetGeoTransform())
    ds_final.SetProjection(ds_base.GetProjection())
    ds_final.GetRasterBand(1).WriteArray(acc_data)
    ds_final.FlushCache()
    print(f"拼接完成: {final_out}")
    ds_base = ds_final = None
异常排查与优化建议
- 内存依然飙升:检查是否意外将切片转为密集数组未释放引用。应在每轮循环末尾显式执行
del segment_data或交由Python垃圾回收机制管理。 - 坐标系错位:分段保存时必须同步调整仿射变换矩阵中的
Gy(第三项)偏移量,否则拼接后图形会发生严重拉伸或重叠。 - 数据类型截断:原始代码中输出驱动误用
GDT_Int16可能导致浮点NDVI精度丢失。生产环境应统一使用gdal.GDT_Float32或符合业务需求的格式。
总结
通过按固定行数切分、过滤异常值、独立导出带地理参考的中间层,最后进行矩阵累加,可稳定解决超大遥感图像的处理瓶颈。该方法无需更换重型分布式框架,纯依靠Python原生科学栈即可实现高效管线。以上就是Python实现分段读取和保存遥感数据的详细内容,更多关于Python遥感数据处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









