Python多版本共存与环境变量配置实战指南
本文详细讲解如何在Windows系统中安装Python并配置环境变量,实现多版本Python共存与灵活切换。通过自定义安装、添加Path路径及重命名可执行文件等步骤,解决不同项目对特定Python版本的需求,确保代码在不同环境下的兼容性与运行效率。
2026-10-12
24

本文详细讲解如何在Windows系统中安装Python并配置环境变量,实现多版本Python共存与灵活切换。通过自定义安装、添加Path路径及重命名可执行文件等步骤,解决不同项目对特定Python版本的需求,确保代码在不同环境下的兼容性与运行效率。
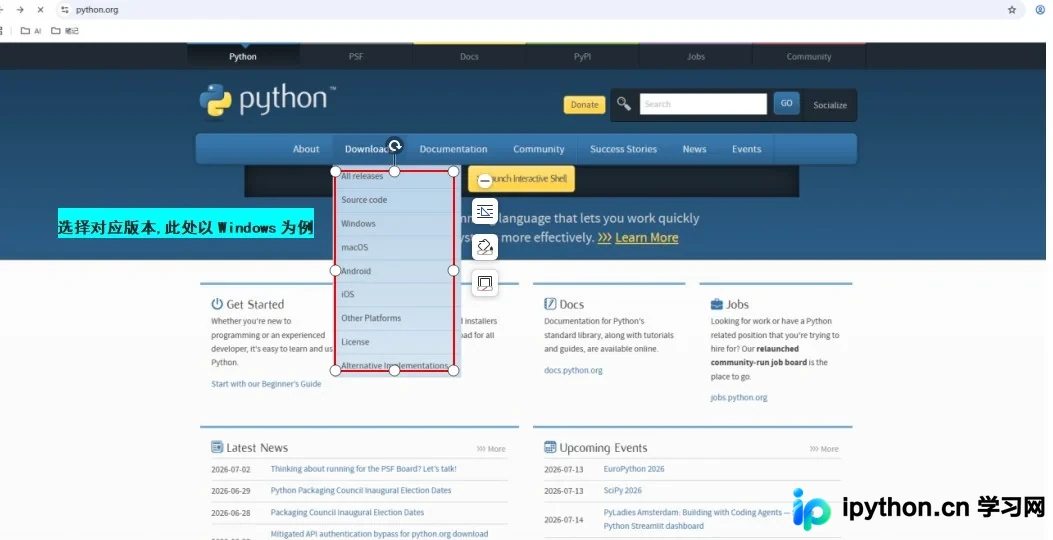
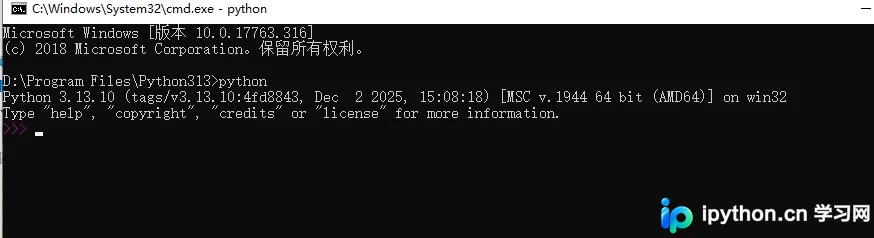
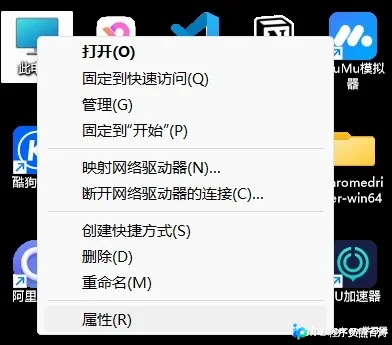
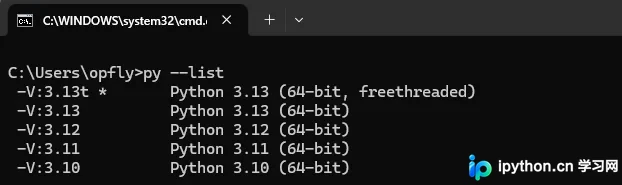
本文详细介绍在 Windows 系统中下载、安装 Python 的完整步骤,重点讲解环境变量的配置方法,包括手动添加与安装时自动配置的选项。此外,还提供了在系统中管理多个 Python 版本并实现共存的实用技巧,帮助用户灵活切换不同版本的 Python 环境。
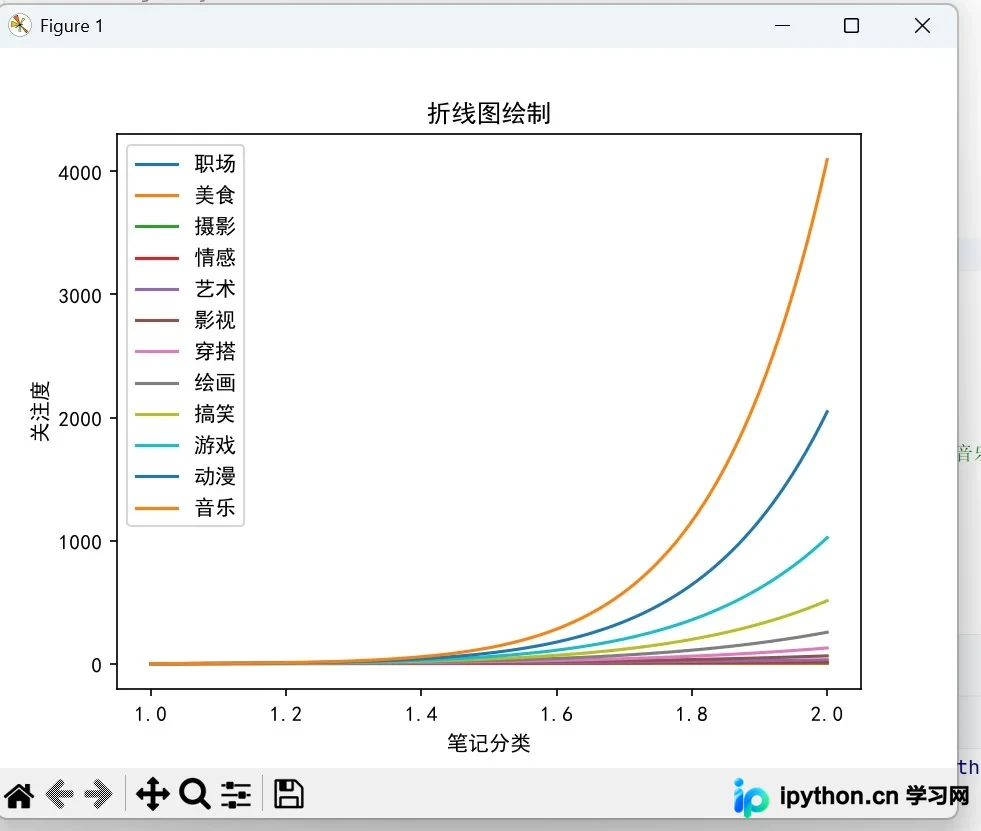
本文详解Python中Matplotlib库的八大核心图表绘制方法,涵盖折线图、柱状图、饼图、直方图、极轴饼图、三维散点图及三维曲面图。提供环境配置、中文字体设置及完整可运行代码,帮助开发者快速掌握数据可视化技能,适用于趋势分析、数值对比及多维数据展示场景。
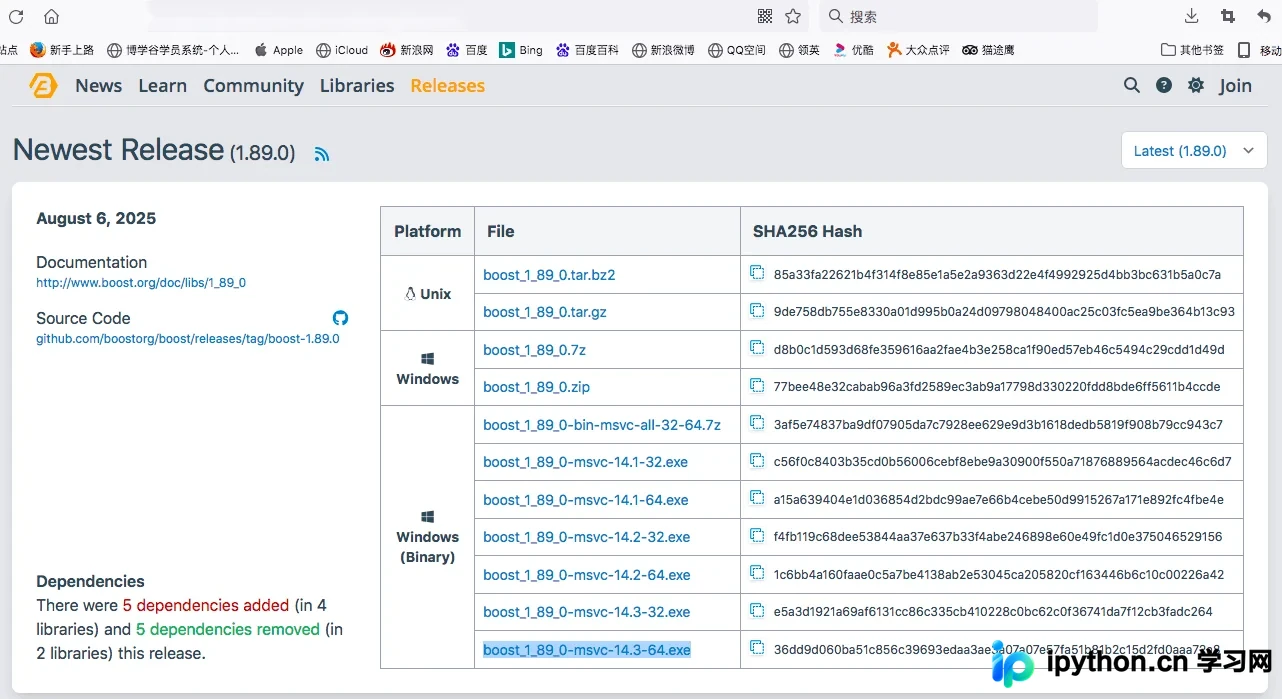
本文详细讲解在Windows环境下配置Boost.Python的全过程,涵盖从下载预编译包、生成b2工具、配置user-config.jam到使用MSVC 14.3编译静态库的完整步骤。同时包含Visual Studio项目属性设置、生成.pyd动态链接库文件以及Python端调用C++函数的完整代码示例与验证方法,帮助开发者实现C++代码向Python接口的无缝转换。
本文系统梳理Python提取PDF内容的完整方案,涵盖pypdf、pdfplumber、PyMuPDF、Camelot及OCRmyPDF等主流工具。详解文本与坐标级提取、表格识别(lattice/stream模式)、扫描件OCR转换、图片/链接/注释/表单及元数据读取。提供批量处理、清洗分块及RAG对接的实战代码与常见坑避坑指南,助力知识库构建与自动化处理。
本文详细讲解如何利用Python的os和shutil模块进行本地文件的自动化管理。内容涵盖路径拼接与导航、文件与文件夹的复制(含元数据保留)、移动剪切、删除(包括非空文件夹处理)、新建以及隐藏文件的识别与过滤。通过具体代码示例和三个实战案例(文件分类、清理空文件夹、备份),帮助开发者掌握文件系统操作的核心技能,提升自动化工作效率。
本文详细解析Python变量命名规范,涵盖字母数字下划线组合、大小写敏感及关键字限制。深入讲解int、float、str、bool及None五种核心数据类型,并通过实例演示各类数据间的相互转换规则,包括进制转换、字符串解析及布尔值判定逻辑,帮助开发者掌握Python基础编程要点。
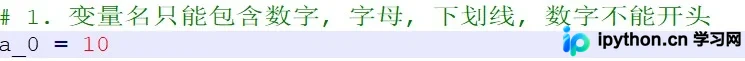
本文详细解析Windows系统中Python pip命令无法识别的问题原因,并提供三步配置环境变量的具体操作步骤,帮助用户在终端和编辑器中正常使用pip。
本文介绍如何使用Python循环批量保存和读取文本文件。以新闻文本主题分类数据为例,通过遍历列表将每个子列表保存为独立txt文件,并利用os模块遍历目录循环读取所有文件内容。代码包含保存与读取两个核心部分,适用于需要处理大量文本数据的场景,提供完整可运行的Python实现方案。
本文详细介绍在Windows系统中将Python从3.11版本升级至3.12的完整流程,涵盖官方安装程序、pip命令行及Conda虚拟环境三种升级路径。同时提供旧版本清理、环境变量优化及Pyenv多版本共存管理的实操指南,帮助开发者安全高效地管理Python环境。
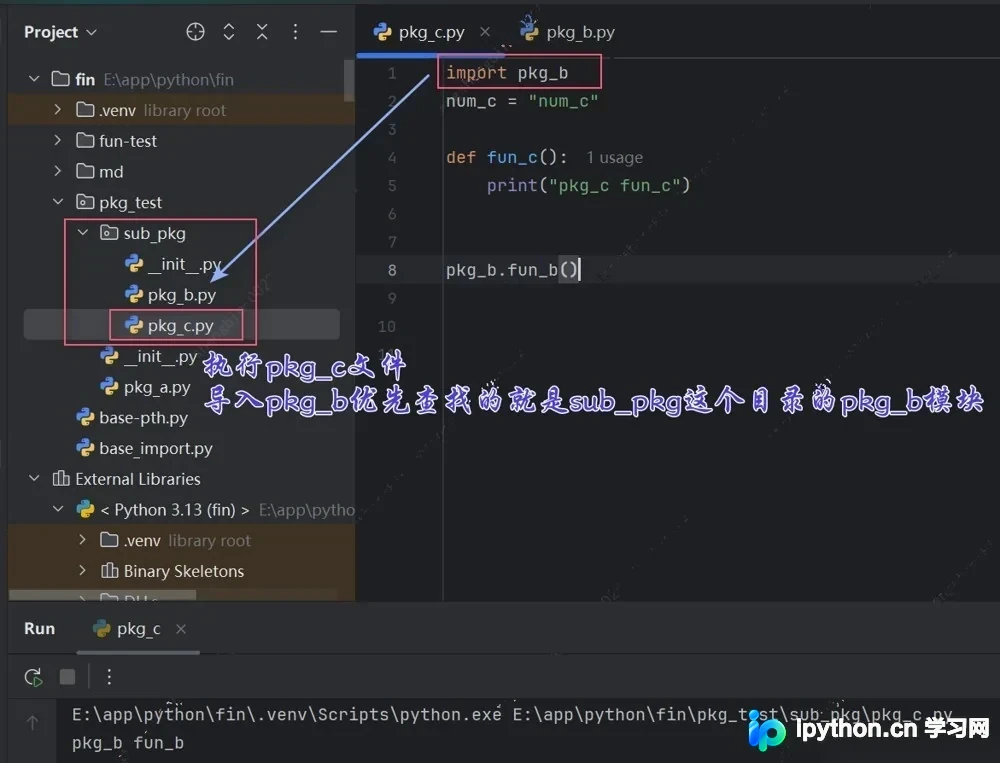
本文深入解析Python模块与包的导入机制,详细阐述sys.path的查找优先级、__init__.py在包组织中的作用,以及import与from...import语句的区别。同时涵盖相对导入的限制、命名空间(LEGB)规则及常见文件类型,帮助开发者快速定位模块导入错误并优化代码结构。
本文深入解析Python中列表与元组的核心用法。详细讲解从0开始的索引机制、负数索引逻辑及切片语法[start:stop:step]。对比列表的可变特性(append、insert等)与元组的不可变性,分析两者在定义语法、内存性能及适用场景上的关键区别,帮助开发者根据需求选择合适的数据结构。