

Python Socket实现文件传输:多并发接收与发送示例
本文介绍基于Python Socket库实现文件传输的两种接收端方案及发送端实现。通过struct模块打包文件名与大小信息,结合threading或SocketServer实现多并发处理。示例展示了从指定路径读取文件并发送,以及接收端保存为新文件的完整流程,支持持续收发新文件。
2026-10-13
24

本文介绍基于Python Socket库实现文件传输的两种接收端方案及发送端实现。通过struct模块打包文件名与大小信息,结合threading或SocketServer实现多并发处理。示例展示了从指定路径读取文件并发送,以及接收端保存为新文件的完整流程,支持持续收发新文件。
本文详细介绍Python中Pandas库的核心功能,涵盖Series一维数据与DataFrame二维表格的创建与操作。内容包含安装导入、数据选择切片、缺失值处理、统计函数应用、数据合并及时间序列重采样等关键操作,帮助开发者快速掌握科学计算基础。
本文介绍了如何使用 Python 脚本根据进程ID (PID) 终止指定进程。核心代码利用 os.kill 函数配合 signal.SIGKILL 信号实现强制结束进程,并包含异常处理以应对进程不存在的情况。该方案适用于需要程序化控制后台进程的场景,代码简洁且可直接复用。
本文详细介绍如何在Python环境中安装和配置virtualenv及virtualenvwrapper。内容涵盖pip基础命令、不同操作系统下的virtualenv安装方法、虚拟环境的创建与激活,以及virtualenvwrapper的高级管理功能。此外,还包含通过requirements.txt批量安装依赖库的实战技巧及常见错误排查,帮助开发者高效管理项目依赖。
本文详细解析Python中字符串连接的三种常用方法:加号(+)、join()及字符串格式化。通过Python 2.7在CentOS环境下的实测数据,对比了不同数量字符串连接时的性能差异。结果显示,连接少量字符串时加号效率更高,而大量字符串拼接则join方法优势明显,为开发者提供选型依据。
本文详解Python3中提取字符串内数字的两种常用方法。首先解析利用re.sub配合正则表达式\D替换非数字字符的实现原理及代码示例;其次探讨通过split()按空格分隔并取首元素的方式处理特定格式数据。对比两者适用场景与局限性,为处理爬虫数据或格式化文本提供清晰的技术参考。
本文详细介绍在Python中利用matplotlib和PIL库读取、显示及处理图片的两种常用方法。内容涵盖图像显示、单通道查看、RGB转灰度、图像缩放、保存图像以及numpy数组与PIL对象间的转换,帮助开发者掌握基础图像处理技能。
本文介绍了在Python中计算文件MD5值的两种常用方法。针对较小文件,推荐一次性读取全部内容进行哈希计算;而对于较大文件,则建议采用分块读取的方式,每次读取固定字节数(如8096字节)并更新哈希对象,以避免内存溢出。两种方法计算结果一致,代码已在Python 3.x版本测试通过,适用于文件完整性校验等场景。
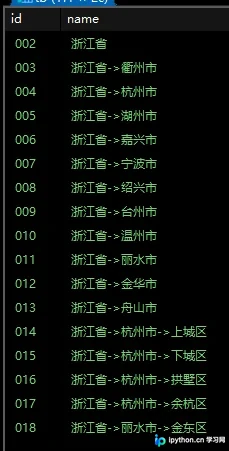
MySQL 8.0 引入的 WITH 子句(CTE)能显著提升复杂查询的可读性与性能。本文通过基础嵌套示例展示多临时表构建,深入解析 RECURSIVE 递归语法及列名定义规范,并提供行政区划层级查询实战,帮助开发者掌握这一强大的 SQL 特性。
本文详细解析了通过JSON跨域调用Python服务端的实现方法,重点介绍了jQuery中JSONP的配置参数与使用细节。针对AJAX跨域时POST转GET、回调函数执行机制及success失效等常见问题提供了具体代码示例与排查思路,并附带实用的JSON处理工具推荐。
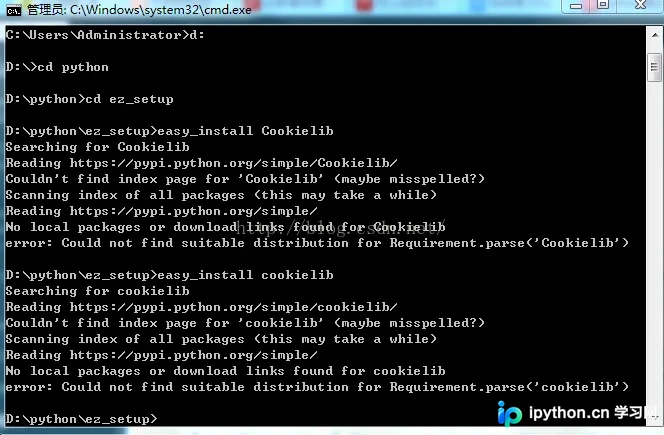
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
本文针对PHP初学者常遇到的两个配置问题进行解答。首先是Windows下Apache因未指定ServerName导致“cannot determine local host name”报错,需修改httpd.conf开启并设置该参数;其次是PHP4环境下Session因BUG导致的保存路径错误,通过将php.ini中session.save_path设为当前目录可解决。