

Python处理CSV文件:剔除指定列并写入新文件的两种方案对比
本文介绍在Python中读取CSV文件并剔除指定列后写入新文件的两种实现方式:原生文件IO循环处理与Pandas DataFrame操作。通过对比27万至110万条数据的处理耗时,结果显示Pandas方案在大数据量下效率提升约30%,逻辑更清晰且性能更优。
2026-10-13
30

本文介绍在Python中读取CSV文件并剔除指定列后写入新文件的两种实现方式:原生文件IO循环处理与Pandas DataFrame操作。通过对比27万至110万条数据的处理耗时,结果显示Pandas方案在大数据量下效率提升约30%,逻辑更清晰且性能更优。
本文分析PHP中session_regenerate_id函数因非原子操作导致的内存双释放漏洞。该漏洞允许远程攻击者通过恶意错误处理器触发拒绝服务甚至任意代码执行,主要影响旧版PHP分支。尽管官方补丁有限,开发人员可通过升级版本及优化会话管理策略降低风险。
本文详解Python3.6环境下如何通过PyMySQL模块连接MySQL数据库。针对Python3.6不支持MySQLdb的情况,介绍了使用pip安装pymysql的方法。通过完整代码示例,演示了建立数据库连接、获取游标、查看数据以及创建和删除数据库与表的完整操作流程,旨在帮助开发者快速掌握基础数据库交互技能。
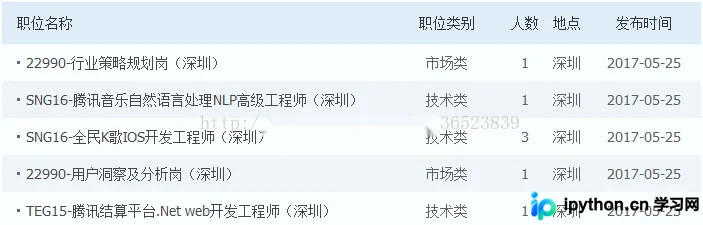
本文介绍如何使用Python3和Scrapy框架爬取腾讯招聘网信息并生成CSV文件。通过调用cmdline命令而非导入csv模块,实现高效数据导出。示例包含items定义、Spider编写及yield用法解析,适合新手参考学习。
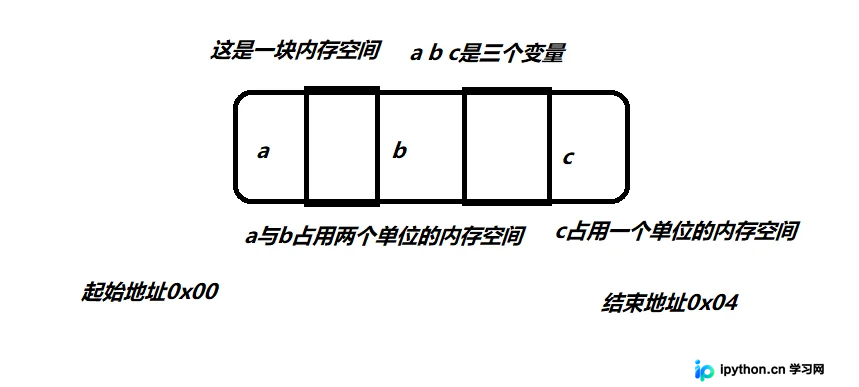
深入解析C/C++指针的核心机制,涵盖指针定义、类型约束、常量指针(指向常量的指针、常指针)的区别。详细演示如何通过new/delete进行堆内存管理,掌握指针与数组的互换关系及指针算术运算。最后通过指针和引用在函数参数传递中的应用,对比值传递与地址修改的差异,辅以希尔排序代码实例,帮助开发者避开内存越界风险。
在JavaScript中,等于(==)与全等(===)的核心区别在于是否进行隐式类型转换。==会在比较前尝试统一数据类型后再判断值是否相等,而===要求值和类型必须完全一致。遵循严格模式使用===是最佳实践,能有效避免因类型强制转换导致的逻辑错误,提升代码的可预测性和稳定性。
本文深入解析Go语言中引用类型的传递机制。通过对比Python的引用变量,证明Go不存在引用传递,仅支持值传递。文章揭示了map和slice等引用类型在函数传参时,实际传递的是指向底层数据结构的标头副本(类似指针),从而解释了为何修改参数能影响原对象,同时保持了语言设计的纯粹性。
本文介绍如何在Python中对嵌套列表进行去重,同时保留元素出现的原始顺序。通过示例展示直接使用set会导致顺序混乱,进而利用sort方法的key参数结合索引定位,实现既去重又保序的高效解决方案。
本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
本文详细解析Python解决N阶台阶走法问题的两种核心思路。针对兔子每次可跳1、2或3阶的场景,文章指出该问题属于排列而非组合,并分别提供了递归与非递归(递推)的代码实现。通过对比两种方法的逻辑与执行效率,帮助开发者深入理解基础算法在Python中的应用。
本文深入解析Python中多种优化算法的应用,涵盖随机搜索、爬山法、模拟退火及遗传算法。通过航班调度、宿舍分配及关系图绘制三个实际案例,演示如何将问题转化为数字序列并定义成本函数。文章提供完整代码实现,帮助开发者掌握寻找最优解的核心技巧。
本文深入解析Python中K最近邻(KNN)算法的实现。从基础分类原理出发,详细讲解欧几里得距离计算、K值选择及加权平均策略(反函数、减法、高斯函数)。通过白酒价格预测案例,演示数据预处理、交叉验证评估、属性缩放优化及概率分布分析,帮助开发者掌握KNN在实际项目中的应用与调优技巧。