Python使用whois模块查询域名注册信息的实现方法
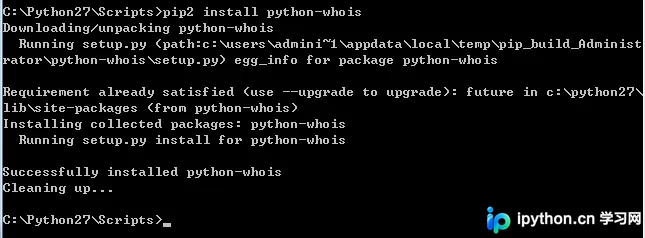
本文介绍如何在Python中利用whois模块查询网站域名及其所有者信息。通过pip安装python-whois库后,调用whois()函数即可获取包括注册商、创建日期、过期时间及所有者组织等详细数据。文中提供了Python 2与Python 3环境下的安装及运行示例,帮助开发者快速掌握域名信息查询技巧。
2026-10-13
29

本文介绍如何在Python中利用whois模块查询网站域名及其所有者信息。通过pip安装python-whois库后,调用whois()函数即可获取包括注册商、创建日期、过期时间及所有者组织等详细数据。文中提供了Python 2与Python 3环境下的安装及运行示例,帮助开发者快速掌握域名信息查询技巧。
本文介绍如何利用 TensorFlow 的 tf.app.flags 模块定义和解析命令行参数。通过 DEFINE_string、DEFINE_integer 和 DEFINE_boolean 等方法,开发者可以灵活接收外部输入并设置默认值。文章包含完整的代码示例及运行结果演示,帮助理解如何在模型训练或部署脚本中高效管理配置项。
本文介绍了在Python中利用os.path模块获取文件路径、文件名及后缀名的具体实现方法。通过os.path.split分离路径与文件名,再使用os.path.splitext提取主名与扩展名,从而完整解析文件信息。
本文介绍如何利用Python的xlsxwriter库实现Excel文件的自定义写入。通过两个实例,分别演示了将数据框按指定顺序和格式写入Excel表格,以及自动生成包含柱状图的自动报表。内容涵盖单元格格式化、数据写入及图表配置等核心操作,帮助开发者高效处理Excel数据输出任务。
本文总结Python读取TXT文件的两种常见场景:数值型数据处理与文本情感分类。针对数组运算中常见的字符串类型报错,提供将元素强制转换为float的解决方案;同时展示如何利用正则表达式删除电影评论数据集中的多余符号,并结合文件遍历实现大规模文本数据的预处理与分类存储。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文提供使用Go语言读取源文件、过滤空行并将非空内容写入目标文件的完整代码。通过 bufio.NewReader 逐行读取,利用 len(str) == 0 或 str == "\r\n" 判断空行,实现高效的文本清洗。
本文介绍在Go语言中如何实现基础定时器。核心使用time.NewTicker创建定时器对象,配合无限循环和select语句监听通道信号来触发周期性任务。同时展示通过Goroutine异步执行多个不同周期的定时器,确保主程序不阻塞等待。该方法简单直接,适用于无需复杂调度的常规定时场景。
本文介绍如何使用Python和numpy库读取文本文件并将其转换为矩阵。详细解析了字符串处理、类型转换及矩阵构造过程,并针对大规模数据场景提供了稀疏矩阵的替代方案与内存优化建议,帮助开发者避免MemoryError。
本文基于 Python 3.6 环境,演示了三种常见的文件操作场景:保持格式复制文件、读取内容并返回列表(适用于加载本地词典库),以及直接读取文件字符串。代码示例展示了如何处理 UTF-8 编码及去除 BOM 字符,为开发者提供实用的文件处理工具模块参考。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
本文详细介绍使用Python解决八皇后问题的回溯算法。通过定义冲突检测函数判断皇后位置是否合法,并利用递归生成所有可能的摆放方案。文章包含完整代码示例及运行结果分析,帮助开发者理解递归调用与状态更新机制,适用于Python数据结构与算法学习。