Scrapy爬虫框架核心架构解析与实战项目搭建指南
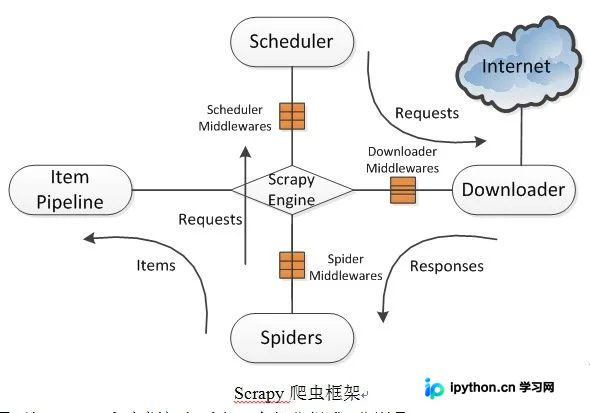
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
2026-10-13
22

本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
本文详解 C# System.Math 类的核心静态方法。涵盖绝对值、平方根、幂运算等数值处理;Acos/Asin/Atan 等三角函数应用;以及 Ceiling/Floor/Round/Truncate 等精度控制策略。通过分类梳理,帮助开发者快速定位所需算法实现数据转换与计算逻辑。
本文介绍Python中交换字典键值对的三种常用方法。通过zip函数结合dict构造、传统for循环遍历以及列表生成式配合dict转换,分别实现键值反转。每种方法均附带完整代码示例,帮助开发者根据实际场景选择最优方案,适用于数据清洗与映射处理。
本文介绍利用Python threading模块实现多线程并行统计指定文件夹下所有CSV文件行数的方法。通过自定义线程类封装文件读取逻辑,结合os模块遍历目录,最终汇总各文件行数。该方法适用于需要快速处理大量CSV文件的场景,代码包含完整的类定义、线程启动及结果收集过程。
本文详细解析了Python在指定目录下导入模块的两种方法。通过修改sys.path变量将目标路径加入搜索列表,或直接在目标目录下启动Python解释器,均可实现模块导入。文中结合Python 2.7环境下的实际终端操作示例,展示了具体的命令执行过程与注意事项,适用于需要灵活管理模块路径的开发者参考。
本文介绍使用Python实现类似MapReduce的大数据分析流程,涵盖大文件切分、Mapper映射及Reducer归约三个核心步骤。通过正则表达式提取日志日期并统计频次,结合多线程技术处理切分后的文件,最终输出按日期排序的统计结果,适用于系统日志的批量处理场景。
本文深入解析MySQL索引的核心类型及其优缺点,涵盖主键、唯一、联合及全文索引的应用场景。重点探讨InnoDB的行级锁定机制对索引的依赖,以及WHERE子句中使用函数或通配符导致的索引失效问题。通过EXPLAIN命令分析执行计划,结合key_len等参数优化SQL查询性能,为数据库设计与维护提供实用策略。
本文介绍Python中广泛使用的HTTP库requests。它基于Apache2许可证,旨在提供比标准库urllib2更简洁、人性化的API。文章涵盖通过pip或easy_install安装requests的方法,并演示了GET、POST等常见HTTP请求类型、参数传递、响应处理、编码设置及代理配置等核心功能,帮助开发者快速上手网络请求开发。
针对C++中处理超长整数的需求,本文介绍高精度加法的实现原理。通过将输入数据转为字符串并进行逆序存储以模拟竖式加法,逐位相加处理进位,从而解决标准类型范围限制问题,代码结构清晰适合初学者理解核心逻辑。
本文介绍如何在Python中对包含元组的列表进行多条件排序。通过自定义key函数,利用lambda表达式结合负号技巧,实现先按第一个元素升序、再按第二个元素降序的复杂排序需求,适用于需要多级排序规则的场景。
本文介绍了在Python中使用pandas库进行数据处理的技巧,重点讲解了cumsum函数的用法。该函数用于计算轴向元素的累积加和,并返回由中间结果组成的数组。通过具体示例,展示了如何对不同维度的数据进行累积求和操作,帮助读者快速掌握这一常用功能。
本文介绍如何在Python中利用texttable库为Pandas DataFrame格式化输出添加表格边框。通过设置列对齐方式(左、中、右)和数据类型(文本、整数等),并使用header=False参数避免首行被误识别为标题,从而实现美观的表格展示。