Python计算KS指标详解:处理NaN数据与多种实现方式对比
本文详解利用Python计算KS(Kolmogorov-Smirnov)指标的三种主要方法:基于pandas.crosstab、sklearn.roc_curve以及scipy.stats.ks_2samp。重点分析当数据包含NaN值时各方法的差异,指出直接调用内置函数可能因排序机制导致误差或报错,并提供提前清洗数据或使用自定义累积分布计算的正确解决方案,确保风控模型评估的准确性。
2026-10-13
19

本文详解利用Python计算KS(Kolmogorov-Smirnov)指标的三种主要方法:基于pandas.crosstab、sklearn.roc_curve以及scipy.stats.ks_2samp。重点分析当数据包含NaN值时各方法的差异,指出直接调用内置函数可能因排序机制导致误差或报错,并提供提前清洗数据或使用自定义累积分布计算的正确解决方案,确保风控模型评估的准确性。
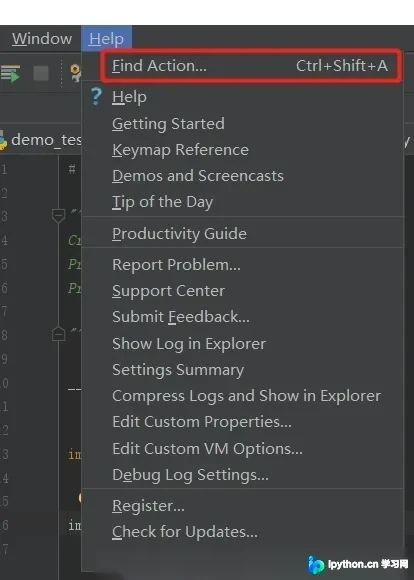
PyCharm 运行程序时提示 Out of Memory 错误,通常因默认分配的 1024M 内存不足导致。本文介绍两种修改 pycharm.exe.vmoptions 配置文件的方法:通过 Help 菜单直接编辑或手动修改安装目录文件,将 -Xmx 参数调整为更大值(如 2048m)以解决内存溢出问题。
本文介绍了在Python中生成大写32位UUID的方法,通过uuid模块生成标准UUID并去除连字符后转换为大写。同时补充了生成32位纯数字随机数的思路,涉及随机数生成与字符串拼接操作,提供相关代码参考。
本文通过具体实例介绍如何使用PHP通过ODBC接口连接数据库。主要涉及odbc_connect建立连接、odbc_exec执行SQL查询以及利用while循环和odbc_fetch_row提取数据,并提供完整的XHTML格式代码示例及错误处理机制。
本文通过Python代码示例,演示如何构建一个简易的快递价格查询系统。内容涵盖利用条件判断语句处理不同地区(如东三省、新疆等)及重量区间的计费逻辑,结合死循环实现持续交互。文章提供了两段不同实现的源码,分别展示了基于首重与续重计算的逻辑以及模块化函数设计的思路,适合Python初学者理解基础语法在实际场景中的应用。
本文介绍利用Python中的numpy.percentile和pandas.cut函数,通过计算数据百分位数实现等频数据分箱的方法。文章提供了生成随机数据、确定分位点、自定义标签及统计结果的完整代码示例,并补充了动态时点与静态时点百分位数的计算逻辑,适用于需要按分布比例划分数据区间的场景。
本文提供了一个基于PHP和cURL的Twitter API调用类示例,演示了如何抓取并解析用户时间线XML数据,同时处理链接与标签的高亮显示。需要注意的是,随着Twitter平台接口的更新,此类基础调用方法可能需要进行相应的调整以适应新的API版本。
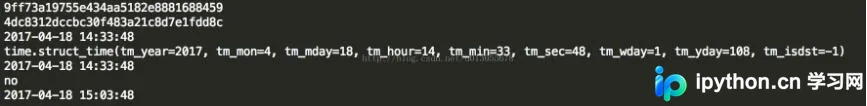
本文介绍Python中字符串与UUID的相互转换方法,涵盖str、int及hex格式到UUID对象的解析。同时补充了Python中时间字符串与time对象的互转、时间加减运算及比较逻辑,提供完整代码示例供参考。
本文介绍了在Python中生成13位和16位时间戳的方法,并提供了将时间戳反向解析为可读时间的代码示例。通过结合10位秒级时间戳与微秒部分,实现了不同精度的时间戳生成,适用于需要高精度时间标识的场景。
本文介绍如何使用C#语言通过面向过程的方式编写一个控制台应用程序,实现加权平均分的自动计算功能。主要逻辑包括获取课程数量、分别输入各科成绩与权重(学分),最后按公式累加并求平均,适合初学者理解基础的数据处理流程。
本文介绍如何使用Python生成六万个不重复的8位随机字符串,包含数字与大小写字母。通过集合自动去重机制确保唯一性,并将结果保存至CSV文件。同时提供固定长度不重复字符串及百万级数据生成的扩展代码示例,适用于测试数据造景场景。
本文详细介绍开源抓包工具mitmproxy的安装、配置及高级用法。涵盖Windows与Android平台的证书信任配置,解析mitmproxy、mitmweb与mitmdump三大组件的区别。重点讲解如何利用mitmdump对接Python脚本,通过request和response钩子实现请求头修改、URL重定向及响应数据自动存储,助力开发者高效进行网络调试与爬虫开发。