

Python抓包工具mitmproxy安装配置与脚本开发实战

本文详细介绍开源抓包工具mitmproxy的安装、配置及高级用法。涵盖Windows与Android平台的证书信任配置,解析mitmproxy、mitmweb与mitmdump三大组件的区别。重点讲解如何利用mitmdump对接Python脚本,通过request和response钩子实现请求头修改、URL重定向及响应数据自动存储,助力开发者高效进行网络调试与爬虫开发。
mitmproxy功能与原理概述
一、介绍说明
mitmproxy是一款支持HTTP和HTTPS协议的抓包工具,功能类似Fiddler和Charles,但采用命令行界面进行操作。
该工具包含两个重要关联组件:mitmdump是其命令行接口,允许通过Python脚本对接实现监听后的数据处理;mitmweb则是Web界面程序,提供可视化的请求观察体验。
mitmproxy主要功能包括:
1、拦截HTTP和HTTPS请求与响应
2、保存HTTP会话记录并支持后续分析
3、模拟客户端发起请求,或模拟服务器端返回响应
4、利用反向代理机制将流量转发至指定服务器
5、支持Mac和Linux系统的透明代理模式
6、通过Python脚本对HTTP请求与响应进行实时处理
mitmproxy运行在本地PC的8080端口,开启代理服务,该服务本质是一个HTTP/HTTPS代理服务器。
当手机与PC处于同一局域网时,将手机代理设置为mitmproxy的地址,手机访问互联网的流量数据包将流经mitmproxy。mitmproxy将数据包转发至真实服务器,并将服务器返回的数据包再转发回手机,从而起到中间人作用,捕获所有request和response。此外,该过程可对接mitmproxy,利用Python直接处理抓取的request和response内容,例如解析response并存入数据库,完成数据解析与存储流程。
安装配置与证书信任设置
二、安装以及配置
pip install mitmproxy
若安装失败出现timeout报错,可尝试多次重试或添加--timeout参数指定超时秒数。
pip --timeout 10000 install mitmproxy
注意:Windows平台不支持mitmproxy的控制台界面,但可使用mitmdump和mitmweb。
这三个命令功能一致,均可加载自定义脚本,区别仅在于交互界面不同。
启动mitmproxy命令后,提供命令行界面,用户可实时查看发生的请求,并通过命令过滤请求、查看请求数据。
启动mitmweb命令后,提供Web界面,用户可实时查看发生的请求,并通过GUI交互过滤请求、查看请求数据。
启动mitmdump命令后,无界面显示,程序后台运行,因此无法提供过滤请求或查看数据的功能,需结合自定义脚本工作。
证书配置
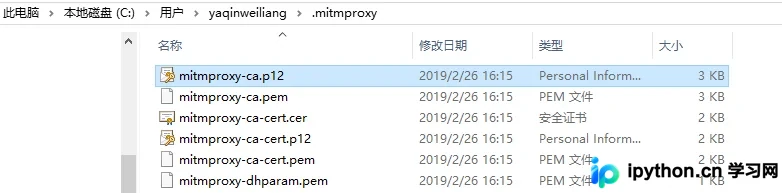
运行mitmdump命令生成CA证书,在用户目录下的.mitmproxy目录中找到CA证书,如下图所示。
在Windows平台下安装证书
点击mitmproxy-ca.p12,出现导入证书引导页,如下图所示:
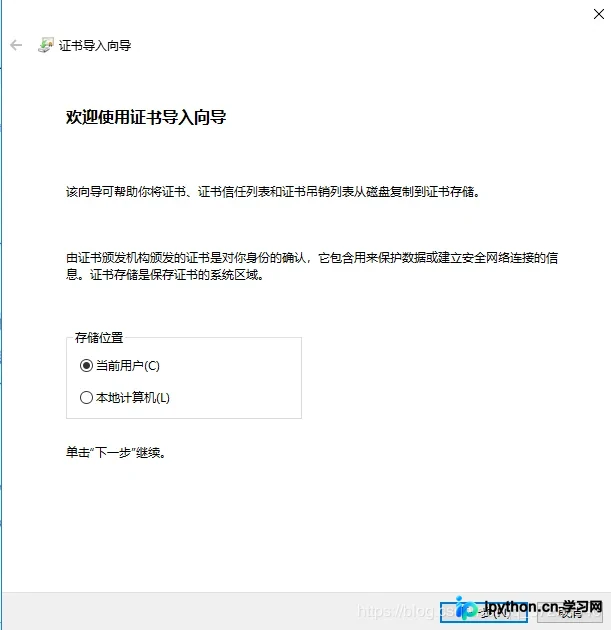
直接点击下一步,若无需设置密码,继续点击下一步。
接下来需选择证书存储区域,如下图所示。
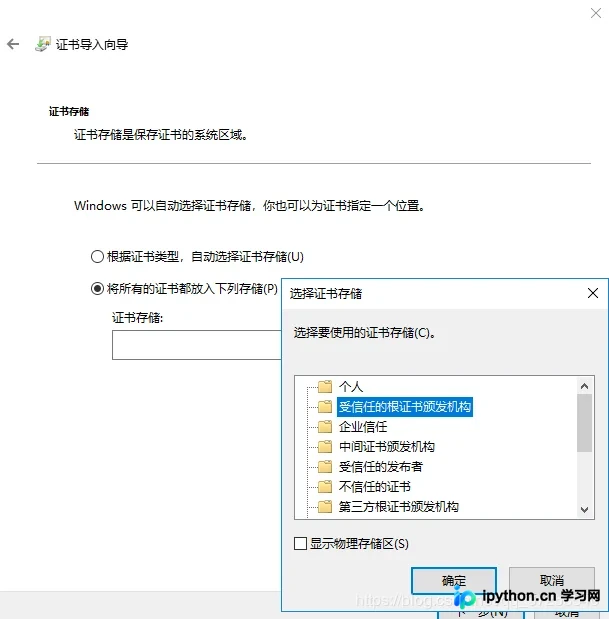
选择第二个选项“将所有的证书都放入下列存储”,点击“浏览”按钮,选择证书存储位置为“受信任的根证书颁发机构”,点击“确定”,再点击“下一步”。
最后,若弹出安全警告,直接点击“是”按钮即可完成CA证书配置。
在Android平台下安装证书
在Android手机上,需将mitmproxy-ca-cert.pem文件发送至手机,点击证书会出现提示窗口。
若手机无法识别.pem文件,可将.cer文件复制到手机,点击安装证书。
输入证书名称(如mitmproxy),点击确定完成安装。
安卓手机还有一种安装证书的方法
命令行输入ipconfig查看本机IP,并输入mitmweb启动mitmproxy
可以看到
Web server listening at http://127.0.0.1:8081/
Proxy server listening at http://*:8080
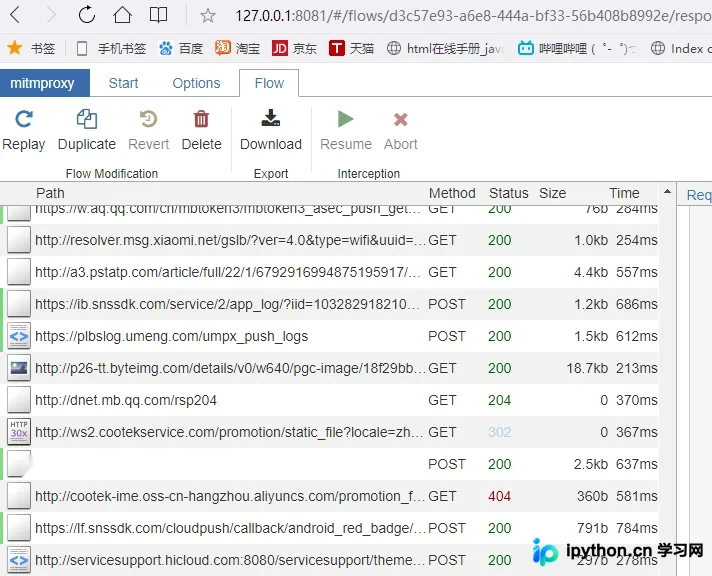
因此可确定代理IP端口号为8080,在手机Wifi设置中手动代理,输入本机IP和端口号8080。此时,打开mitmproxy界面并操作手机,可查看手机请求信息:
在手机端打开http://mitm.it/,进入如下界面:(若未进入该界面,请检查手机端代理IP和端口号输入是否正确!)
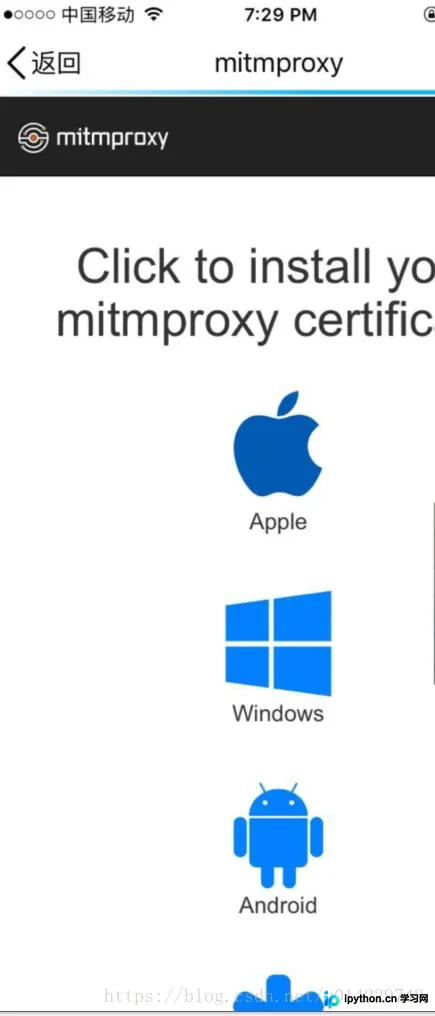
选择第一个进行证书安装,网络不佳时页面可能无响应,多试几次即可进入证书安装界面。
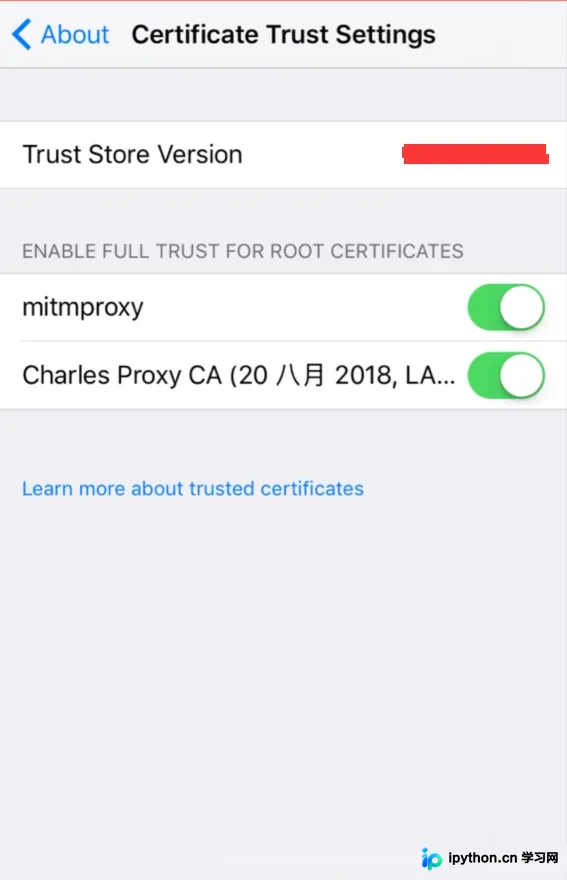
成功安装证书后,前往 Settings > General > About > Certificate Trust Settings. 在“Enable full trust for root certificates”下,开启对mitmproxy证书的信任。
mitmdump脚本开发与实战应用
三、mitmdump的使用
mitmdump是mitmproxy的命令行接口,可对接Python处理请求,相比Fiddler和Charles更为便捷。无需手动截获和分析HTTP请求和响应,只需编写处理逻辑即可。它还能实现数据解析、存储等工作,均通过Python实现。
1、可使用命令启动mitmproxy,并将截获数据保存到文件
命令如下:
mitmdump -w outfile
其中outfile名称任意,截获数据均保存至该文件。
还可指定脚本处理截获数据,使用-s参数即可
mitmdump -s script.py
此处指定当前处理脚本为script.py,需置于命令执行目录下。 可在脚本中写入如下代码:
def request(flow) :
   flow.request.headers['User-Agent'] = 'MitmProxy'
   print(flow.request.headers)
定义一个request()方法,参数为flow,即HTTP Flow对象,通过request属性获取当前请求对象。打印输出请求头,将User-Agent改为MitmProxy。运行后在手机端访问 http: //httpbin.org get 。
手机端返回结果的Headers即请求的Headers,User-Agent被修改为mitmproxy,PC控制台输出修改后Headers内容,其User-Agent内容正是mitmproxy。通过上述三行代码即可完成请求改写。
print()方法输出结果呈现在PC控制台,便于调试。
2、日志的输出
mitmdump提供专门日志输出功能,可设定不同级别以不同颜色输出结果,可将脚本修改为以下内容:
from mitmproxy import ctx
def request(flow):
   flow .request . headers['User-Agent'] ='mitmProxy'
   ctx.log.info(str(flow.request.headers))
   ctx.log.warn(str(flow.request.headers))
   ctx.log.error(str(flow.request.headers))
调用ctx模块的log功能,不同输出方法输出不同颜色结果,便于调试。例如:info()输出白色内容,warn()输出黄色内容,error()输出红色内容。
不同颜色对应不同级别输出,可将不同结果合理划分级别输出,更直观方便地查看调试信息。
3、request的使用
上文已实现request()方法并修改Headers。下文介绍request其他常用功能,如下:
from mitmproxy import ctx
def request(flow):
request = flow.request
info = ctx.log.info
info(request.url)
info(str(request.headers))
info(str(request.cookies))
info(request.host)
info(request.method)
info(str(request.port))
info(request.scheme)
在手机上打开百度,PC控制台输出一系列请求,找到第一个请求。控制台打印输出request常见属性,如URL、headers、cookies、host、method、scheme(请求链接)、请求头、请求cookies、请求host、请求方法、请求端口、请求协议等内容。
同时可对任意属性进行修改,如最初修改headers,直接赋值即可,例如修改请求URL,如下:‘
def request(flow):
url ='https://httpbin.org/get'
flow.request.url = url
仅需简单脚本即可成功将请求修改为其他站点,通过这种方式修改和伪造请求变得容易。
此例表明,有时URL正确但内容非正确,需提高安全防范意识。
因此能轻松获取和修改request任意内容,如修改cookies、添加代理以规避反爬。
4、响应的使用
爬虫更关心响应内容,因response body是爬取结果。对于响应,mitmdump提供对应处理接口,即response()方法。
from mitmproxy import ctx
def response(flow):
response = flow.response
info = ctx.log.info
inf(str(response.status_code))
info(str(response.headers))
info(str(response.cookies))
info(str(response .text))
打印输出响应状态码status_code、响应头headers、cookies、响应体text等属性,其中最重要的是text属性即网页源代码。
通过response()方法获取每个请求的响应内容,再进行响应信息提取和存储,即可完成数据爬取!
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









