

Pandas read_csv 处理字段数不匹配与 KeyError 报错详解
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
2026-10-13
30

本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
本文详细记录并解决Django执行数据库迁移时遇到的常见错误,包括表已存在、外键约束导致的删除失败以及迁移状态不一致等问题。通过实战演示,提供了从关闭外键检查、手动清理数据到重置迁移文件及重新配置数据库连接的完整排查步骤,帮助开发者快速恢复Django项目的数据库迁移功能。
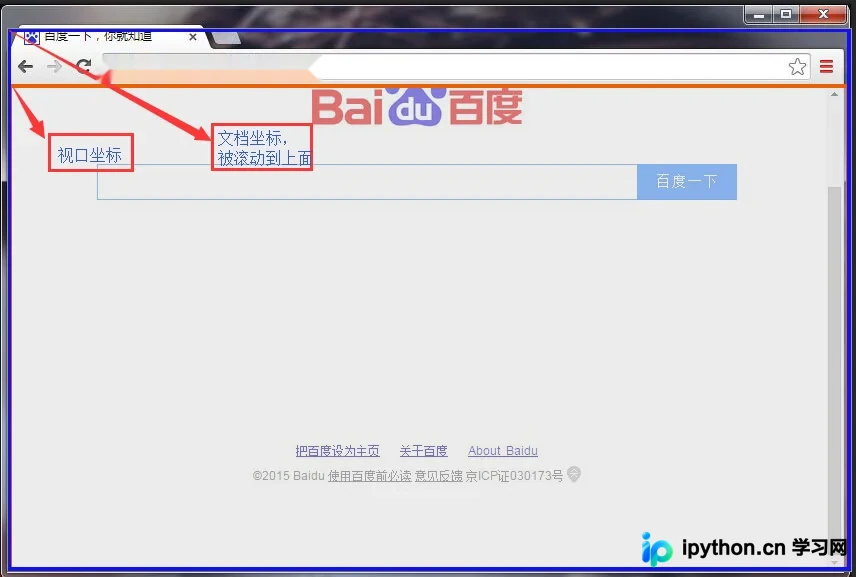
在Web开发中,理解元素的页面坐标(Document Coordinate)与视口坐标(Viewport Coordinate)至关重要。本文详细解析两者的定义、差异及相互转换逻辑,重点介绍利用 getBoundingClientRect() 结合滚动偏移量进行坐标转换的标准方法,并提供兼容主流浏览器的窗口尺寸获取代码,解决定位计算中的常见困惑。
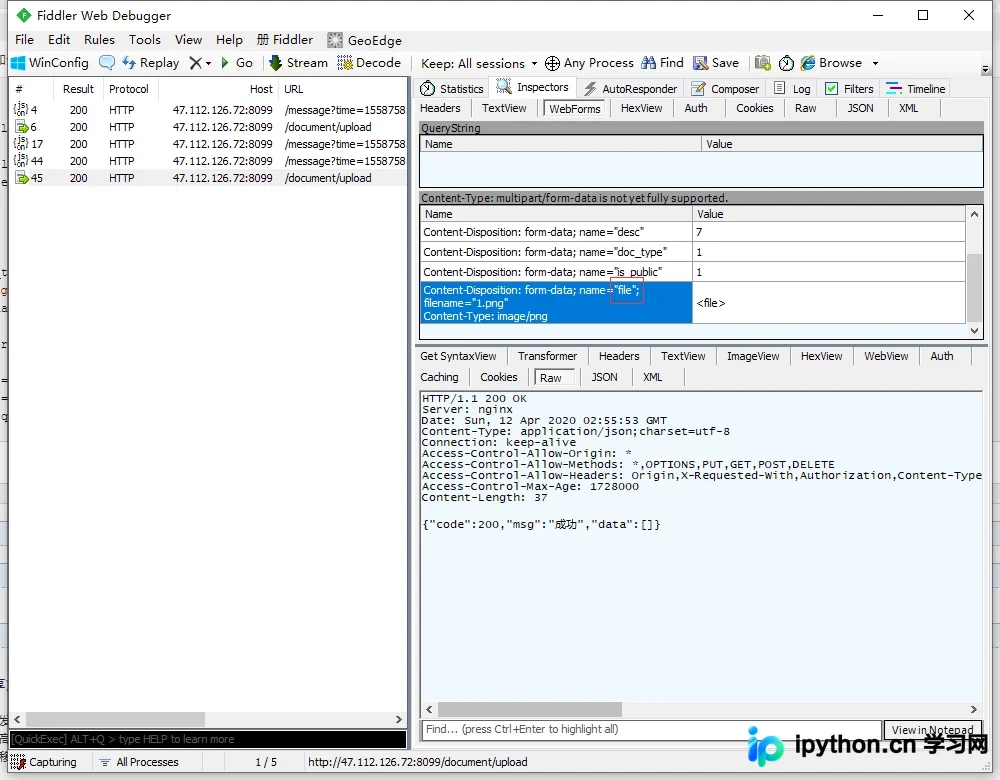
本文详细介绍Python中使用requests库进行文件上传的两种实现方式。方法一利用requests_toolbelt库的MultipartEncoder处理复杂表单数据,需手动转换参数类型并设置Content-Type;方法二直接使用原生requests,通过data和files参数分别传递附加信息与文件,无需额外依赖。文章包含完整代码示例及常见错误处理,适用于CRM接口测试等场景。
本文通过IL代码分析C#中Try-Catch机制,指出无异常发生时性能损耗极小,仅在捕获异常时需遍历Exception Handling Table。提供避免在循环中使用、明确异常类型及优先使用Try-Parse等优化准则,帮助开发者正确评估并合理使用异常处理。
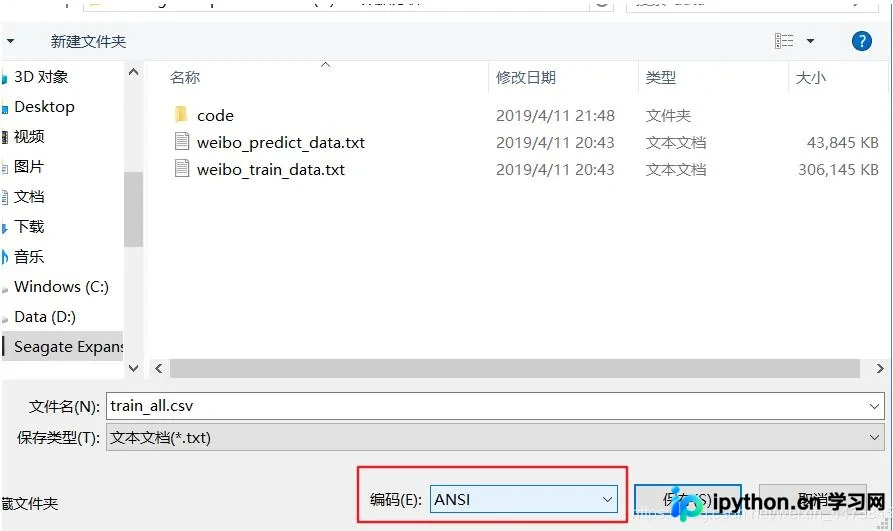
本文介绍在Jupyter Notebook中使用pandas导入CSV文件的方法,重点解决因文件编码非UTF-8导致的UnicodeDecodeError错误。提供两种解决方案:通过记事本将文件另存为UTF-8编码,或在pd.read_csv()中指定encoding参数(如gbk)以正确读取数据。
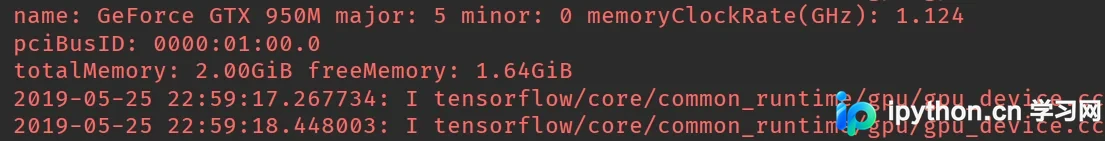
本文介绍如何在TensorFlow中指定CPU与GPU运算。通过device语句明确指派设备,利用ConfigProto配置日志与软放置。详解GPU资源分配策略,包括按需增长(allow_growth)与固定比例(per_process_gpu_memory_fraction),确保显存高效利用。
本文详细介绍在 Jupyter Notebook 中查询连接 Token 的方法,包括通过命令行执行 jupyter-notebook.exe list 获取 Token,以及在 Notebook 环境中使用 notebook.auth.passwd 模块设置密码。内容涵盖从 Anaconda 环境配置到 PyCharm 调试的完整流程,解决非默认浏览器访问时的身份验证问题。
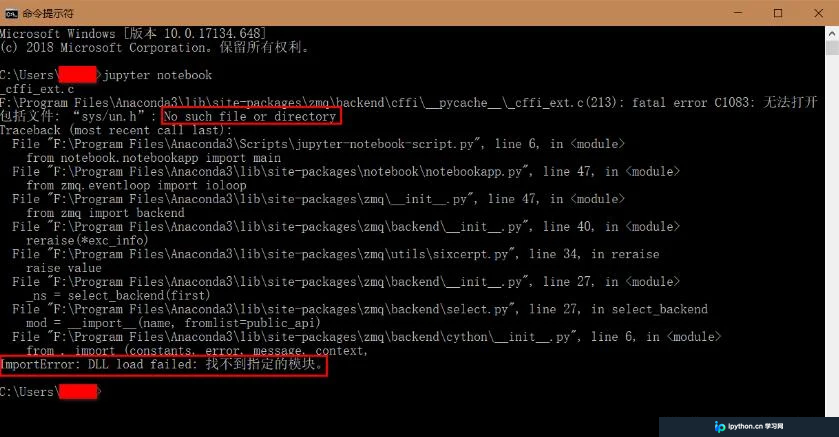
本文详解如何在Jupyter Notebook中处理.py与.ipynb文件的相互调用。通过将.ipynb转换为.py模块实现跨文件导入,并解决代码修改后需手动重载模块的问题,优化开发流程与工程结构。
介绍如何使用 C++ 编写一个高效的游戏角色随机姓名生成器。文章详细解析了利用 char* 指针数组优化内存布局、通过 rand() 快速组合姓氏与名字,并提供了完整的头文件与源码示例供参考。
本文详细介绍如何在同一Python环境中共存安装TensorFlow 1.x与2.0版本。通过Anaconda创建独立虚拟环境,分别指定不同版本号进行安装,并利用国内镜像源加速下载。最后演示如何在PyCharm中切换Python解释器以调用特定版本的TensorFlow,解决新旧代码兼容性问题。
本文深入解析 MySQL Order By 排序的内部机制,包括利用索引有序性获取数据和内存/磁盘文件排序(双路与单路)。通过调整 max_length_for_sort_data、去除冗余字段及合理配置 sort_buffer_size,可显著减少随机 IO 并提升查询效率,避免高并发下的资源耗尽。