

Python实现KNN分类算法:原理、优化与代码详解
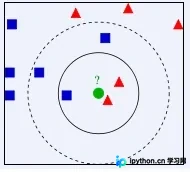
本文详细介绍KNN(K近邻)分类算法的核心原理,包括距离度量与投票机制。深入探讨暴力法、K-D Tree及Ball-Tree的性能差异与适用场景,解决维度灾难问题。通过Python与scikit-learn完整代码示例,演示数据预处理、模型训练、网格绘制及结果评估,帮助读者掌握KNN在复杂分类边界下的应用技巧。
2026-10-16
8

本文详细介绍KNN(K近邻)分类算法的核心原理,包括距离度量与投票机制。深入探讨暴力法、K-D Tree及Ball-Tree的性能差异与适用场景,解决维度灾难问题。通过Python与scikit-learn完整代码示例,演示数据预处理、模型训练、网格绘制及结果评估,帮助读者掌握KNN在复杂分类边界下的应用技巧。
本文深入解析Python NumPy库中的随机数生成模块。涵盖均匀分布函数np.random.random与rand的区别,整数生成np.random.randint,以及随机抽样np.random.choice的权重与替换参数。同时介绍标准与非标准正态分布np.random.randn与normal的实现,并探讨伪随机数生成器的种子机制及RandomState对象的使用,帮助开发者掌握数据模拟与算法测试的核心技巧。
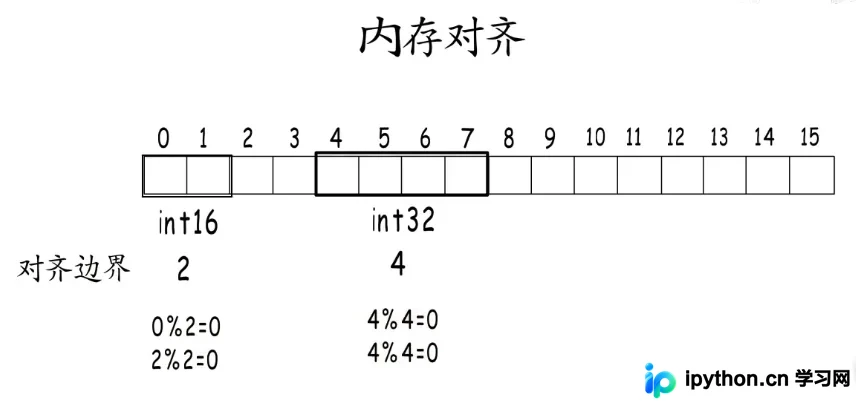
深入解析 Go 语言中内存对齐的底层原因,涵盖平台移植性与 CPU 读取性能的影响。文章详细说明了如何确定基本类型与结构体的对齐边界,通过 unsafe.Alignof 获取对齐值,并演示如何通过调整字段顺序来优化 struct 内存占用,避免不必要的内存浪费。
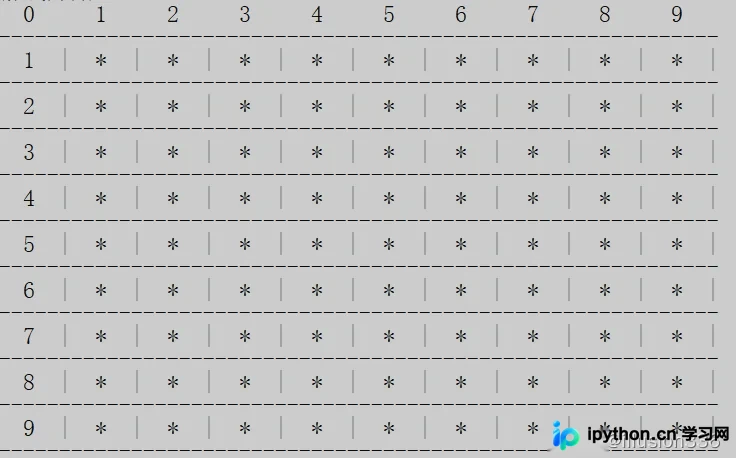
本文详细解析使用C语言开发9x9扫雷游戏的核心逻辑。通过12x12内部数组避免边界越界,利用ASCII码相加技巧快速统计周围雷数。重点讲解防止玩家首次点击踩雷的坐标替换算法,以及基于递归实现的空白区域自动展开机制,提供完整的模块化代码结构。
本文系统介绍Python Num库中创建数组的七种主要方法,涵盖蛮力构造、特殊数值填充、随机分布生成、定长分割、重复扩展、网格构建及自定义数据类型。通过具体代码示例解析参数用法与内存布局,帮助开发者高效掌握NumPy数组初始化的核心技巧。
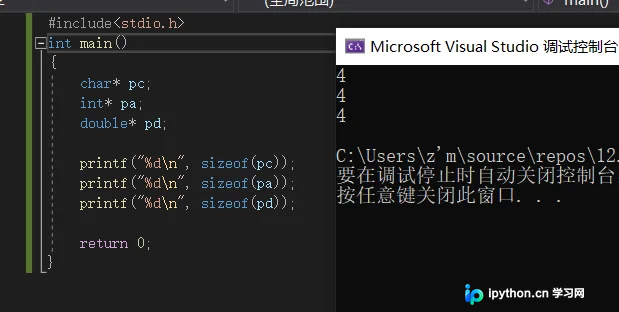
本文深入解析C语言指针的本质,阐明指针大小与系统位数的关系及类型决定访问步长的特性。详细列举未初始化、越界访问、悬空引用等常见野指针成因,并提供初始化为NULL、有效性检测等预防措施。同时涵盖指针加减整数、同数组间相减计算元素个数、二级指针操作及指针数组的使用场景,帮助初学者建立清晰内存模型并规避典型错误。
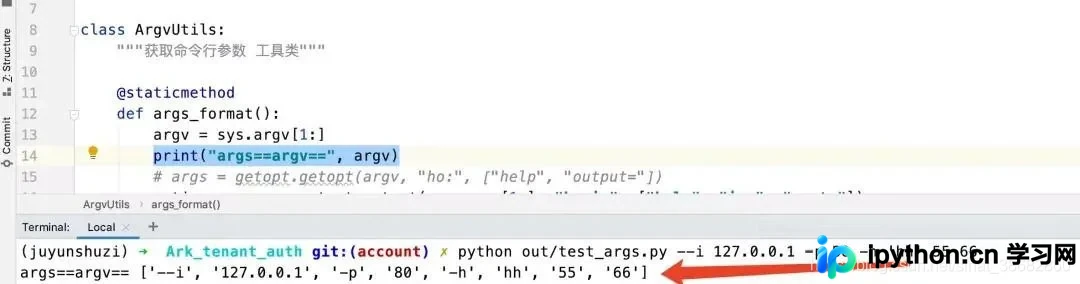
本文详细解析Python脚本中获取命令行参数的三种主流方式:sys.argv直接获取、getopt模块分组处理以及argparse标准库的高级解析。通过对比三者的功能特性、代码示例及适用场景,帮助开发者根据参数复杂度选择最合适的方案,提升脚本的可读性与兼容性。
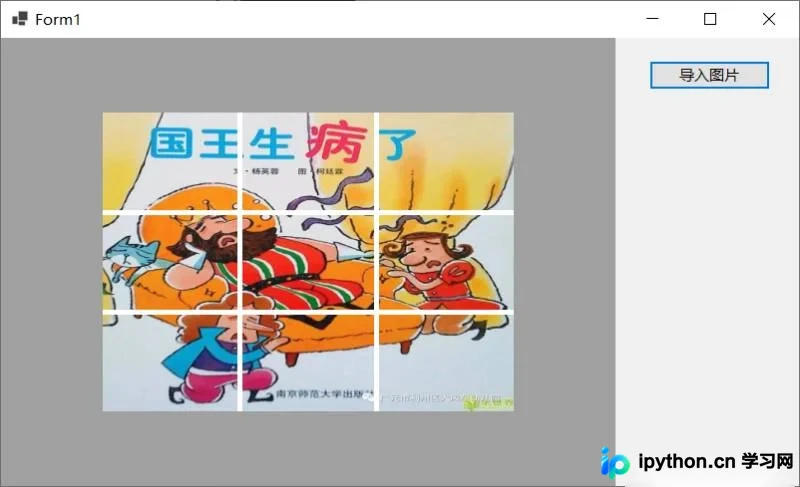
本文介绍在C# WinForm中如何使用GDI+将图片切割为九宫格形式。主要包含两种思路:一是在完整图像上直接叠加网格线,适用于预览且无需局部放大;二是调用DrawImage重载函数截取并分别绘制九个区域,结合背景填充实现精确的拼图效果。文章提供了关键参数计算逻辑与代码片段。
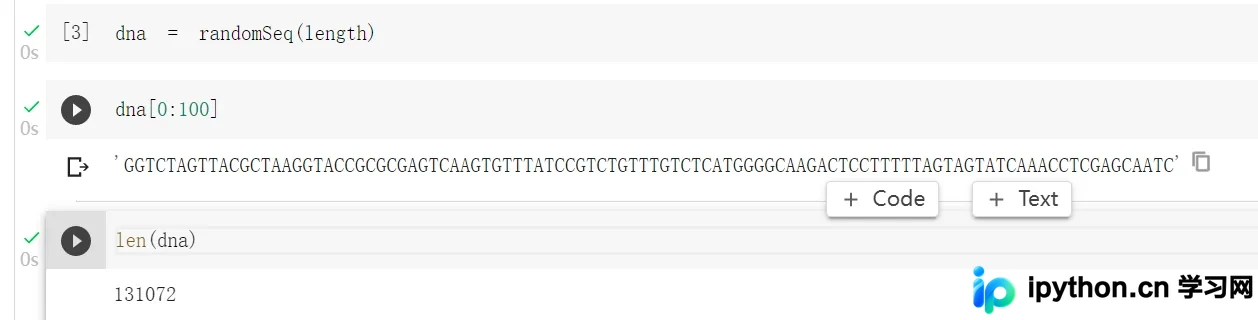
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
本文详细解析 SQL Server 数据库基础编程,涵盖创建与切换数据库(含文件配置)、定义精确/近似数字及字符串等数据类型、管理表结构(字段约束、主外键)、以及执行数据的插入、查询、修改和备份等核心 T-SQL 操作。
本文通过完整代码示例,展示如何使用Go语言标准库与第三方工具处理CSV考勤文件。涵盖GBK至UTF-8编码转换、命令行参数解析、数据筛选写入JSON文件,以及基于JSON的工时汇总计算。同时提供使用官方csv库和Gin框架实现数据导出的最佳实践,解决中文乱码及内存占用问题。
本文详细介绍Python中集合(Set)的创建、访问、增删及数学运算。涵盖使用set()或大括号创建集合,遍历获取元素,利用add()、update()添加,remove()、discard()、pop()、clear()及del删除元素。同时解析copy()、issuperset()、union()、difference()、intersection()、symmetric_difference()及isdisjoint()等方法,助力掌握集合去重与逻辑处理。