

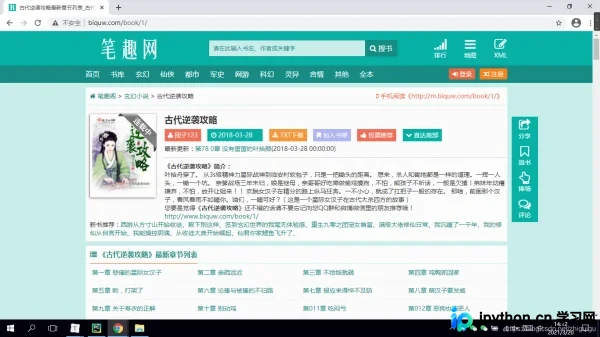
Python爬虫实战:使用Requests与BeautifulSoup抓取笔趣阁小说
本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。
2026-10-14
26

本文详细介绍如何使用Python的Requests和BeautifulSoup库编写爬虫程序,从笔趣阁网站抓取小说列表及正文内容。重点解决编码乱码问题,并通过DOM解析提取章节链接与文本,最终实现小说文件的自动保存。
本文介绍使用Python进行文件名批量重命名的脚本实现。主要步骤包括安装相关依赖库,修改脚本中的源文件路径、目标路径及命名格式参数。文中提供了处理普通文件和批量重命名图片文件的具体代码示例,通过遍历目录并重命名文件,实现自动化批量处理任务。
本文详解Python中获取当前时间戳的多种精度方法,包括秒级、毫秒级及微秒级时间戳的生成代码。同时介绍如何将标准日期字符串转换为秒级时间戳,以及将时间戳还原为可读日期格式。此外,还涵盖了不同日期格式间的相互转换及struct_time结构体的处理技巧,提供完整的代码示例与输出结果分析。
本文介绍使用Python获取淘宝服务器时间的多种代码示例。主要方法包括通过requests库调用淘宝开放API接口获取时间戳,以及利用http.client和urllib库直接解析HTTP响应头中的Date字段。文中提供了完整代码,展示如何从GMT时间转换为北京时间,并指出当前示例仅能精确到秒,毫秒级精度需另行解决。
本文详细介绍如何使用PHP内置的fopen和stream_context_create函数手动构造并发送HTTP POST请求。通过封装独立的do_post_request函数,无需安装cURL扩展即可实现简单的数据提交,并提供了JSON数据处理及参数转换的具体代码示例。
本文深入解析Python德州扑克项目中比较玩家手牌大小的核心逻辑。在获取牌型与牌值后,通过分类处理高牌、对子、四条等不同牌型,结合中间牌与五张牌的逐位比较,实现高效的玩家实力排序。
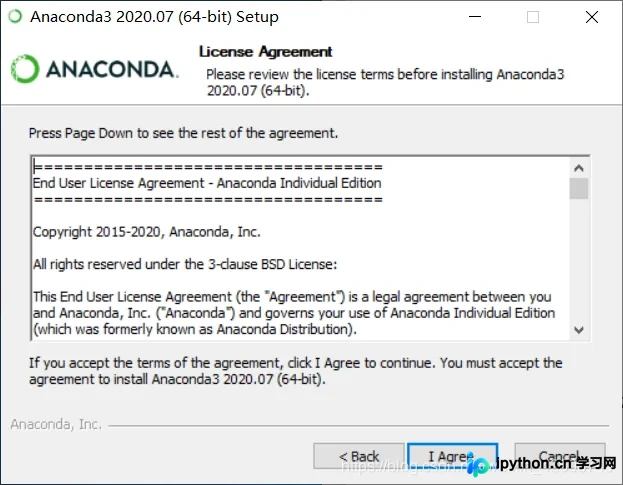
本文详细介绍在Windows系统中安装Anaconda和PyCharm的完整步骤,涵盖环境变量配置、路径设置及常见错误排查。通过实例演示如何配置Python解释器并安装OpenCV库,帮助开发者快速搭建稳定的计算机视觉开发环境。
本文详细介绍C语言中用于时间格式化的核心函数strftime。通过解析其函数原型、关键参数及包含的头文件,并结合完整的代码示例,演示如何将struct tm结构体中的数据转换为指定格式的字符串(如YYYY/MM/DD HH:MM:SS),适用于需要在控制台或日志中输出标准化时间的场景。
本文介绍 C# 中常用的时间日期操作方法,包括使用 DateTime.Now 获取并格式化当前时间,以及将 Unix 时间戳转换为指定格式的日期字符串。提供完整的代码示例及参数说明,帮助开发者快速实现常见的时间处理需求。
本文演示在C# WPF应用中,如何通过三种不同的LINQ方式查询AdventureWorks数据库并绑定到ListBox。包括使用LINQ to Entities的声明式查询、LINQ to SQL的纯文本参数化查询,以及通过EntityClient直接执行字符串命令的低级操作。每种方法均展示完整的代码逻辑与界面交互实现。
本文介绍一种基于Django和requests库的接口自动化测试方案。通过封装公共测试方法,仅需传入URI、请求方式及参数即可批量执行接口测试。同时,优化代码以支持将测试结果优雅地输出为带有样式的Markdown文件,实现测试过程的一键化与可视化,提升接口测试效率。
本文介绍如何在Java项目中利用开源库HTMLParser从HTML页面中提取纯文本内容。通过展示具体的类导入、URL请求、节点遍历及编码处理等步骤,提供可直接运行的代码片段,帮助开发者解决从网页源码中剥离HTML标签获取有效文字的问题。