

MySQL 数据汇总与分组统计实战:聚合函数、GROUP BY 与 HAVING 详解
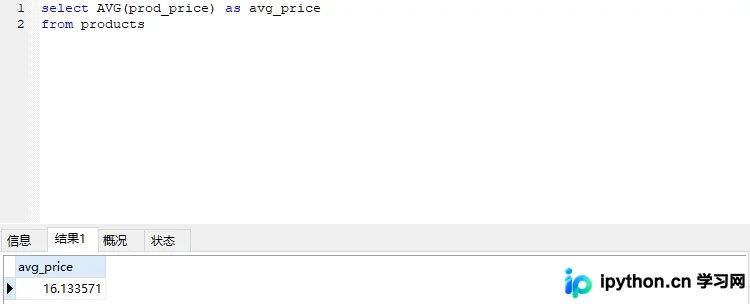
本文详解 MySQL 中如何实现不检索实际数据而是直接进行统计分析。介绍 AVG、COUNT、SUM 等聚合函数的使用方法,重点解析 GROUP BY 子句的嵌套规则、NULL 值处理以及与 HAVING 的区别。结合 ROLLUP 和 ORDER BY 提供完整的分组统计操作示例,帮助开发者快速掌握复杂报表生成的 SQL 编写技巧。
2026-10-16
14

本文详解 MySQL 中如何实现不检索实际数据而是直接进行统计分析。介绍 AVG、COUNT、SUM 等聚合函数的使用方法,重点解析 GROUP BY 子句的嵌套规则、NULL 值处理以及与 HAVING 的区别。结合 ROLLUP 和 ORDER BY 提供完整的分组统计操作示例,帮助开发者快速掌握复杂报表生成的 SQL 编写技巧。
本文详细解析C语言联合体(Union)的核心机制,包括成员共用内存空间、地址重合特征及同一时刻仅能使用一个成员的限制。深入讲解联合体大小的对齐计算规则,并展示如何利用该特性高效判断系统内存存储为大端或小端模式。
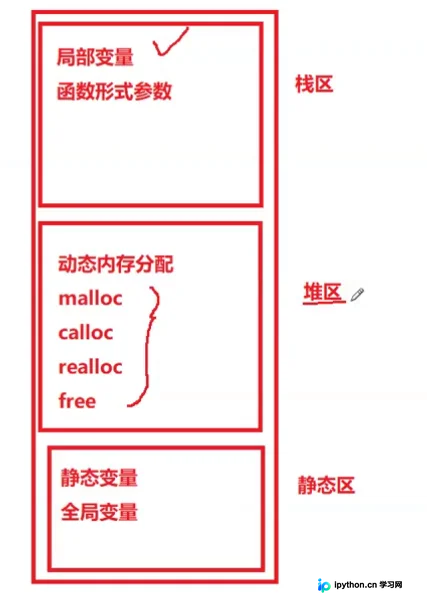
在C语言中,静态数组无法满足运行时动态变化的内存需求,此时需使用堆区动态内存分配。本文详细解析malloc、calloc和realloc函数的用法与区别,重点梳理对NULL指针解引用、越界访问、重复释放等六大常见致命错误,并提供规范的代码处理方案以保障程序稳定。
文章深入解析 MySQL ORDER BY 语句的索引优化策略,涵盖 B-Tree 索引机制、联合索引设计原则及常见误区。通过 EXPLAIN 分析工具,针对排序+LIMIT、条件+排序、IN查询、函数应用及多字段排序等五类典型场景,提供具体的索引创建方案与 SQL 改写建议,帮助开发者提升查询效率并避免回表性能损耗。
本文解析 JavaScript 中防抖(Debounce)与节流(Throttle)的核心区别及实现方法。通过 clearTimeout 清理定时器实现防抖,适用于搜索框等需等待操作完成的场景;利用标志位控制执行频率实现节流,适用于滚动加载等需持续触发但限制频率的场景。两者均用于优化高频事件对性能的影响。
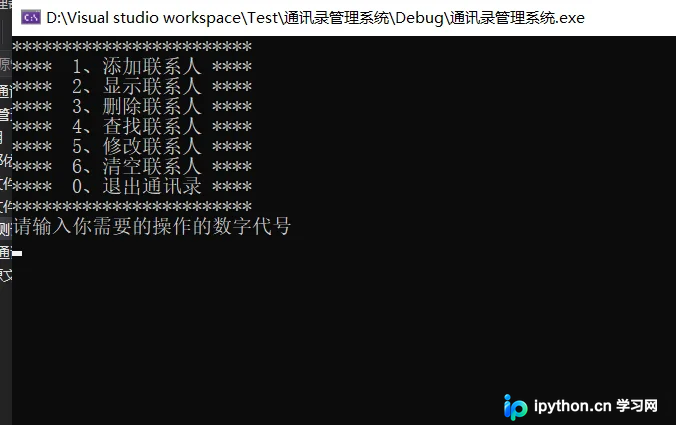
本文详细讲解如何使用 C++ 标准库中的结构体和数组,从零构建一个基于控制台的通讯录管理系统。文章涵盖了联系人信息的模块化设计、输入数据的合法性校验(如手机号格式)、以及添加、显示、查找、修改、删除和清空等核心功能的代码实现与运行效果解析,适合 C++ 初学者巩固面向对象与内存管理基础。
在Smarty模板引擎中,date_format用于格式化时间变量。它基于PHP的strftime函数,支持多种转换说明符(如%Y年、%m月、%d日)。通过指定格式参数,可将时间输出为自定义样式,例如“2001-02-06”或“Tuesday, February 06, 2001”。
本文深入解析C语言中常用的内存处理函数,包括memcpy、memcmp、memmove和memset。详细说明了各函数的参数、返回值及使用注意事项,重点剖析了存在内存重叠时memcpy与memmove的行为差异,并提供了完整的底层模拟实现代码,帮助开发者掌握内存操作原理与安全用法。
本文详解 JavaScript 中防抖(Debounce)与节流(Throttle)的核心概念、适用场景及常见实现方式。通过定时器和时间戳两种策略,帮助开发者在窗口 resize、搜索框输入等高频触发场景中优化性能,减少不必要的函数执行。
本文详细解析C语言中的核心操作符与关键字。涵盖单目、关系、逻辑、条件及逗号表达式的具体用法;深入讲解sizeof在数组中的特殊行为;系统梳理auto、break、const等常用关键字的功能,重点剖析static对局部变量生命周期及全局变量/函数链接属性的影响,帮助建立扎实的C语言基础。
本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。
本文详细解析Go语言的核心控制流:for循环的四种变体及协程演示,以及break/continue控制;深入讲解switch语句的基础、多表达式匹配、无表达式模式及fallthrough穿透机制。通过精简代码示例,助您快速掌握Go的条件判断与循环逻辑。