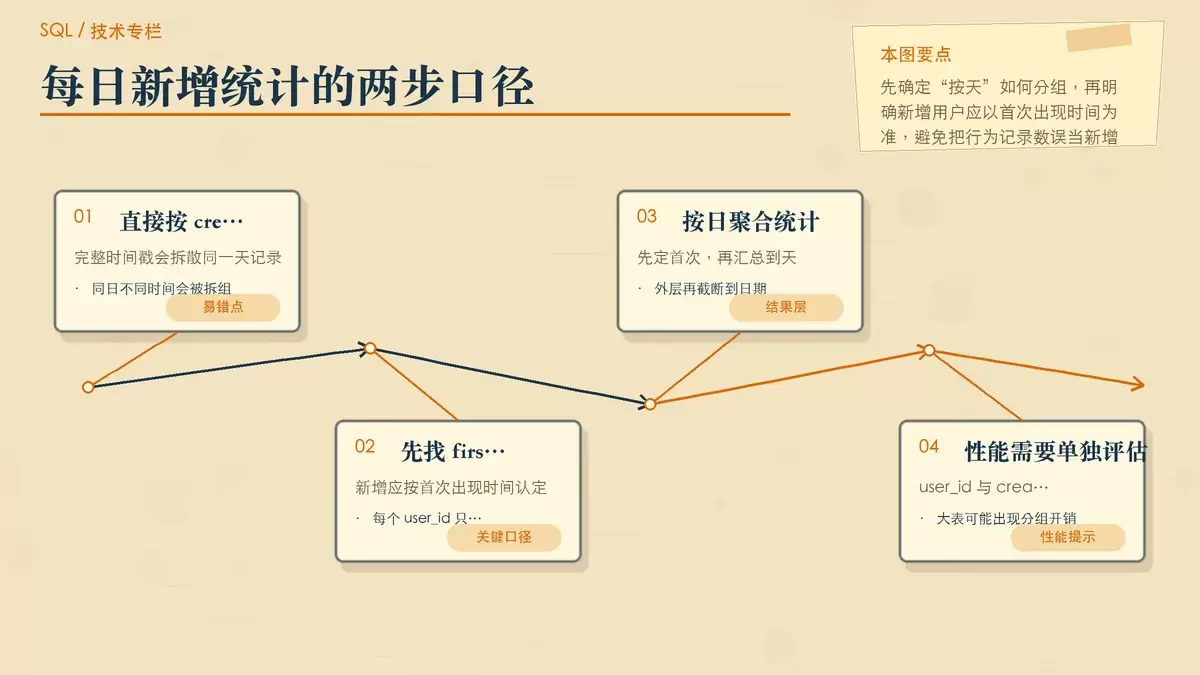
Golang 中 new 与 make 的区别及适用场景
在 Go 里,`new` 和 `make` 都和内存分配有关,但职责并不相同。前者返回某个类型的零值指针,后者只服务于 `slice`、`map`、`channel`,并直接完成可用结构的初始化。理解这层差异,才能避免 `nil map`、空通道这类常见问题。 刚接触 Go 时, new 和 make 很容易被当成“两个都能申请内存的函数”来记忆,但一到写结构体、切片或映射时,差别马上就会暴露出来。
2026-08-25
119

在 Go 里,`new` 和 `make` 都和内存分配有关,但职责并不相同。前者返回某个类型的零值指针,后者只服务于 `slice`、`map`、`channel`,并直接完成可用结构的初始化。理解这层差异,才能避免 `nil map`、空通道这类常见问题。 刚接触 Go 时, new 和 make 很容易被当成“两个都能申请内存的函数”来记忆,但一到写结构体、切片或映射时,差别马上就会暴露出来。
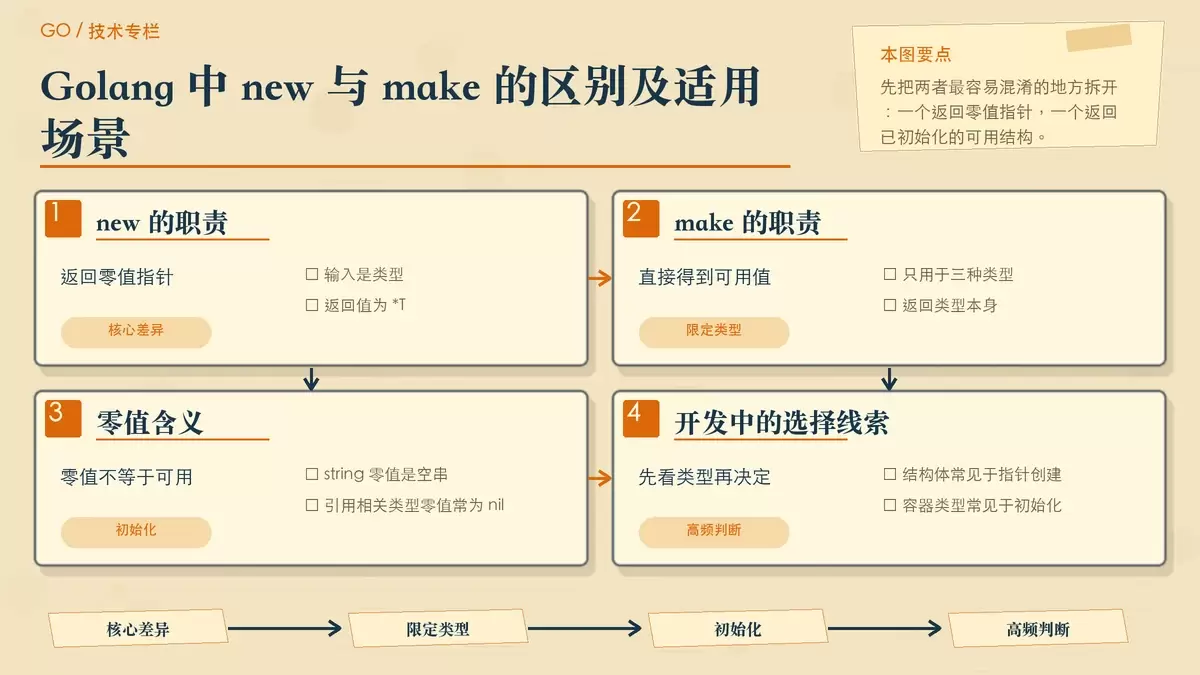
在 PostgreSQL 14 里,SQL 触发器函数有几条不能踩的硬规则:返回类型必须是 `TRIGGER`,结尾必须返回 `NEW`、`OLD` 或 `NULL`;动态 SQL 里表名、列名要用 `format('%I', ...)`;`NEW` 和 `OLD` 只能按 `TG_OP` 对应场景访问。再加上行级触发器在批量更新时的性能成本,这些细节决定了触发器是稳定运行还是一上生产就报错。
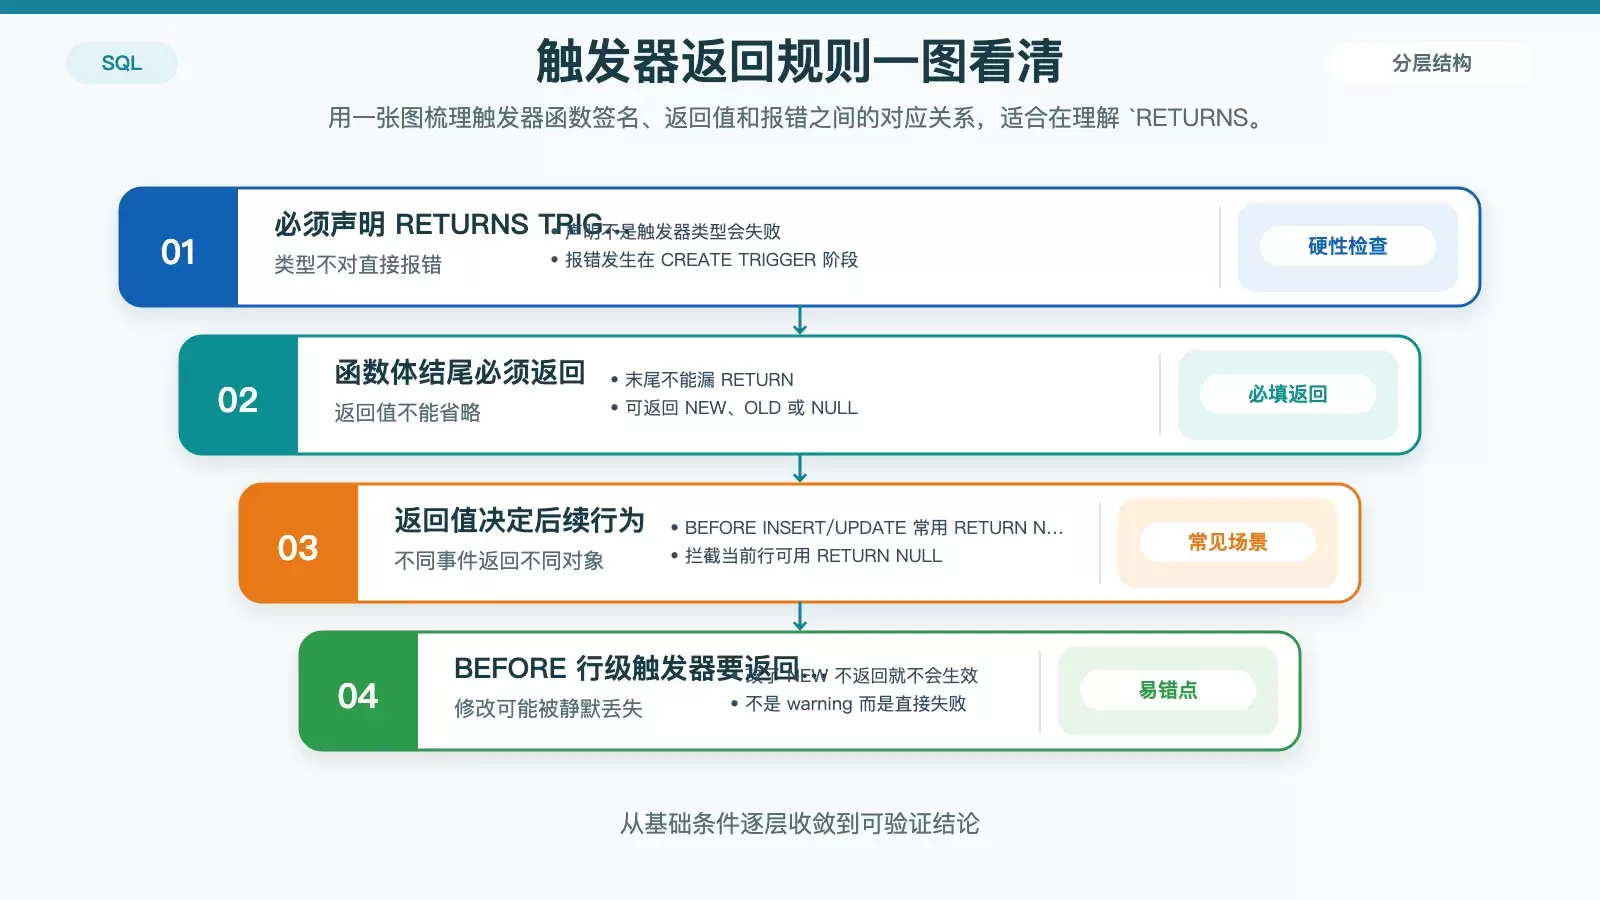
在 Ubuntu 上更新 Node.js,常见做法主要有两种:通过 NodeSource 软件源安装固定版本,或通过 NVM 管理多个版本。前者适合希望长期锁定 18.x、20.x 这类版本的环境,后者更适合需要在不同项目间灵活切换的开发场景。
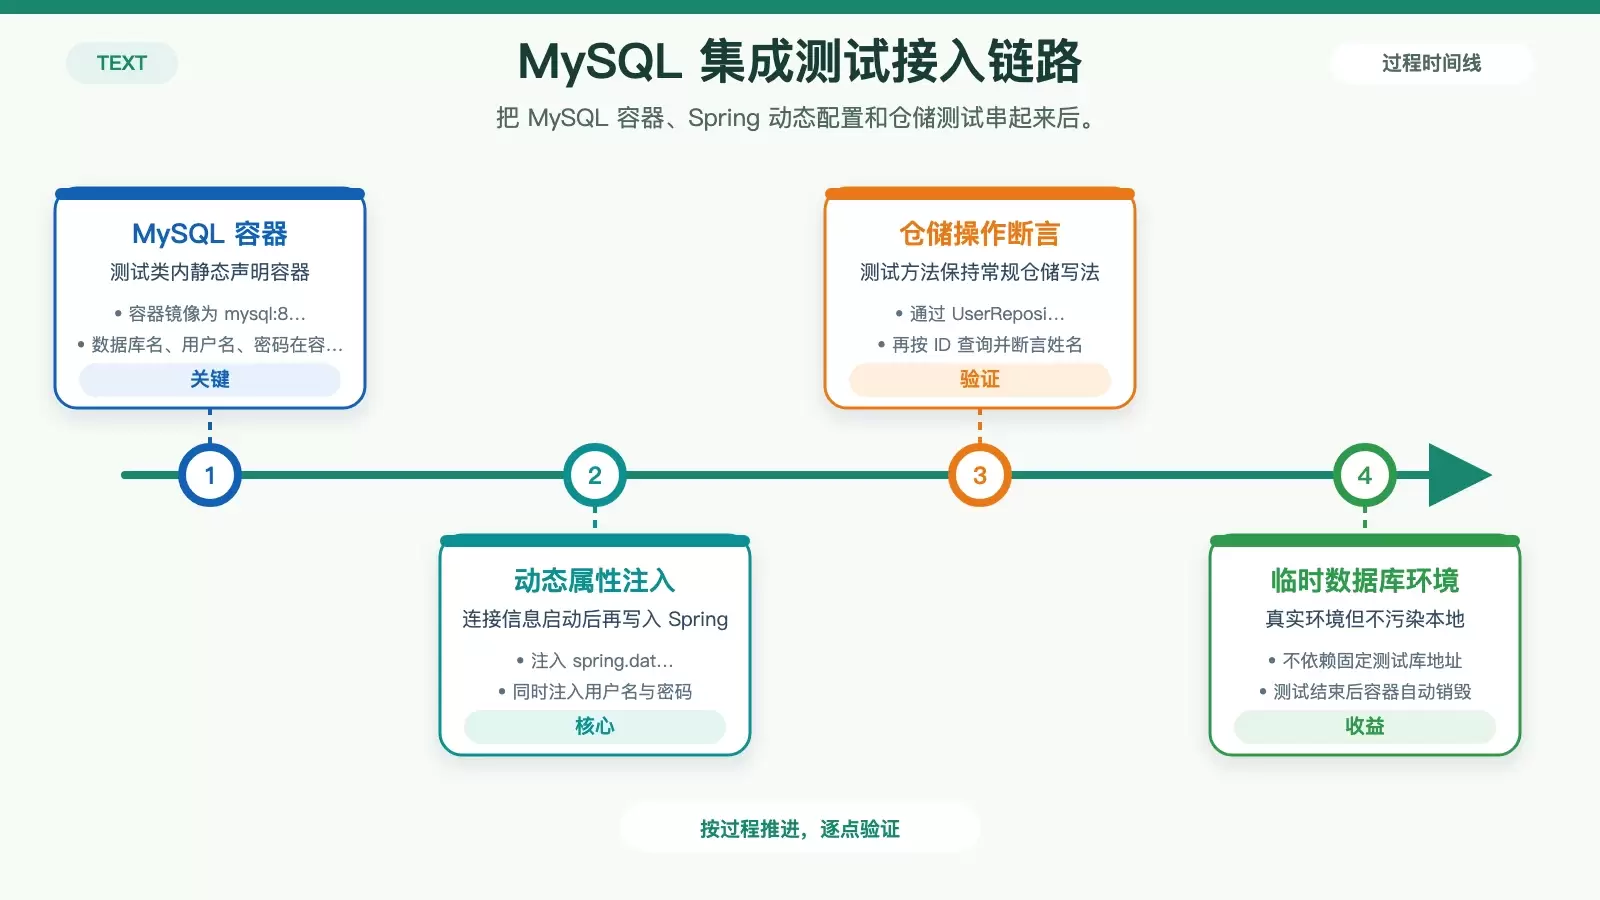
这篇文章用 Spring Boot + Testcontainers 演示真实集成测试的基本做法,覆盖 MySQL、Redis 以及共享容器三类场景。重点保留依赖版本、注解用法和动态注入配置,帮助你判断什么时候该单独起容器,什么时候该用基类复用。
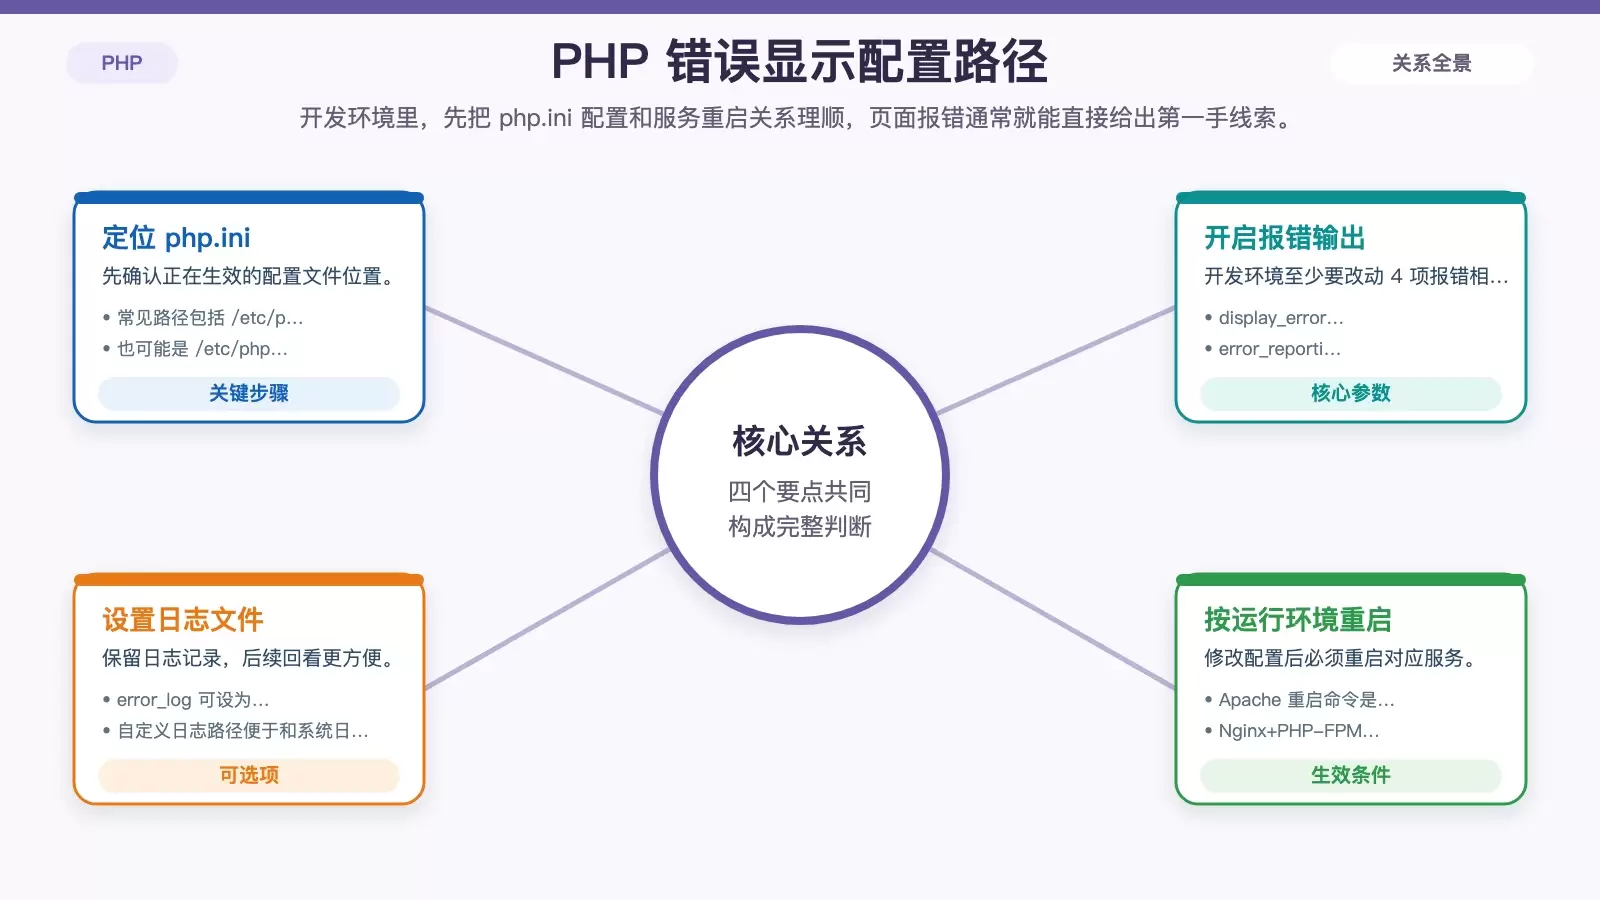
这篇文章围绕 Ubuntu 上 PHP 报错排查,按开发环境显示错误、生产环境看日志、Xdebug 断点调试三条主线展开,并补充权限、升级和配置校验等细节,帮助你根据场景选择最快的定位办法。 PHP 在 Ubuntu 上出错时,最怕的不是报错本身,而是不知道该先看哪里。
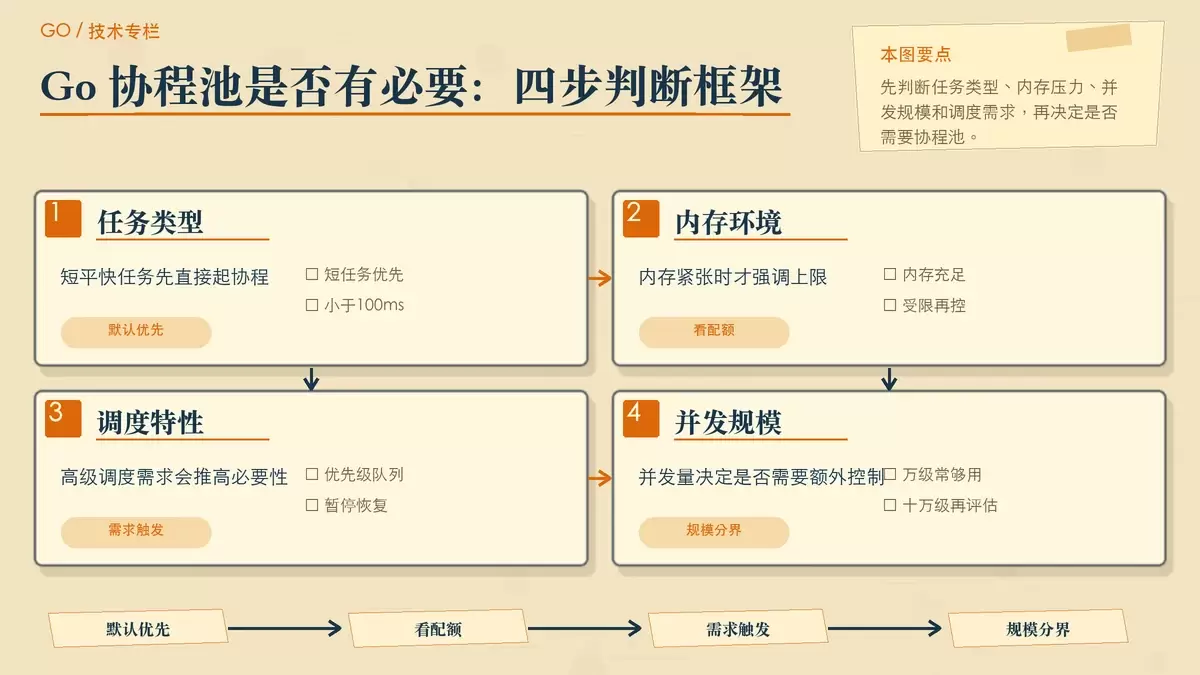
Go 的 goroutine 足够轻量,但这不等于任何场景都该无上限地 `go func()`。这篇文章把协程池的价值、争议点和实际判断标准拆开说明:什么时候直接起协程最合适,什么时候该用池控住并发、内存和系统负载。
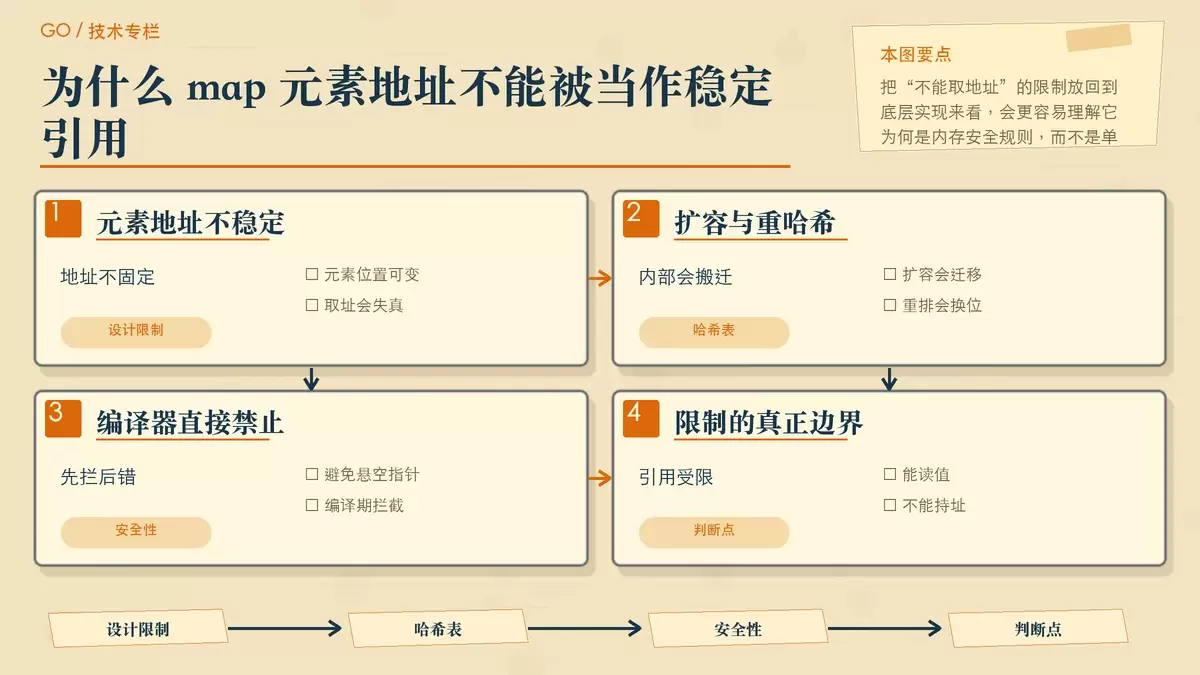
Go 不允许直接对 map 元素取地址,这不是语法上的任性限制,而是为了避免元素在扩容、重哈希后地址变化带来的悬空指针。理解这一点后,就能更稳妥地选择“取出-修改-存回”或指针类型 map,并避开 range 遍历时的取址陷阱。
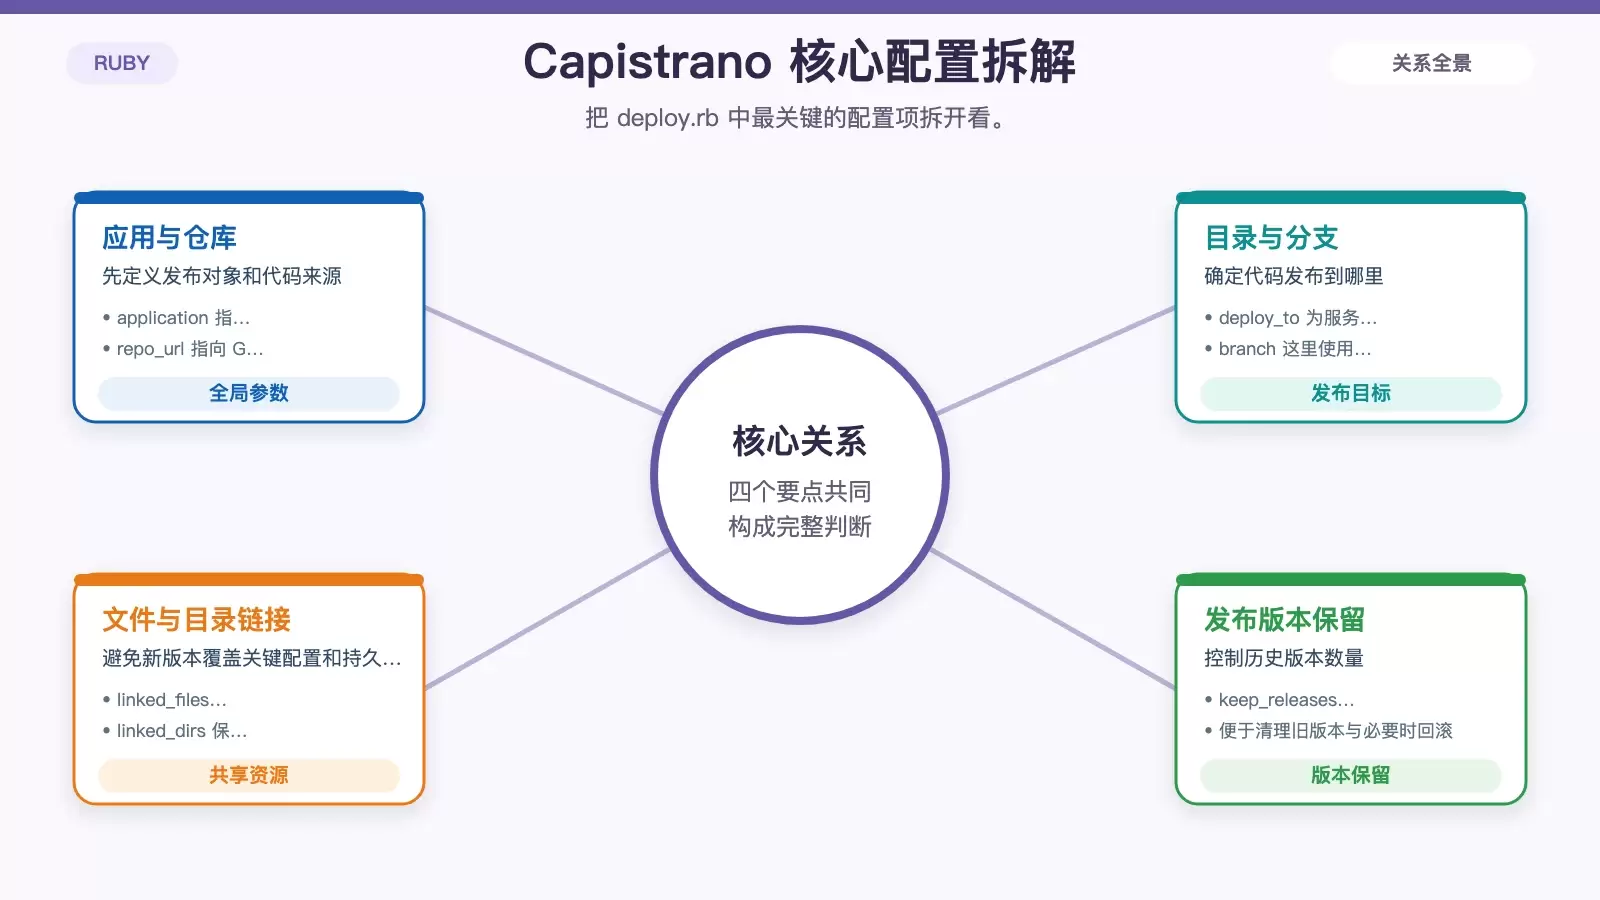
Capistrano 是 Ruby 项目里常见的自动化部署工具,适合把代码发布、目录链接、依赖安装和自定义任务收进统一流程。本文按“安装、配置、任务接入、执行部署”四步梳理它的基本用法,并保留关键命令与配置示例,方便快速判断是否适合自己的项目。
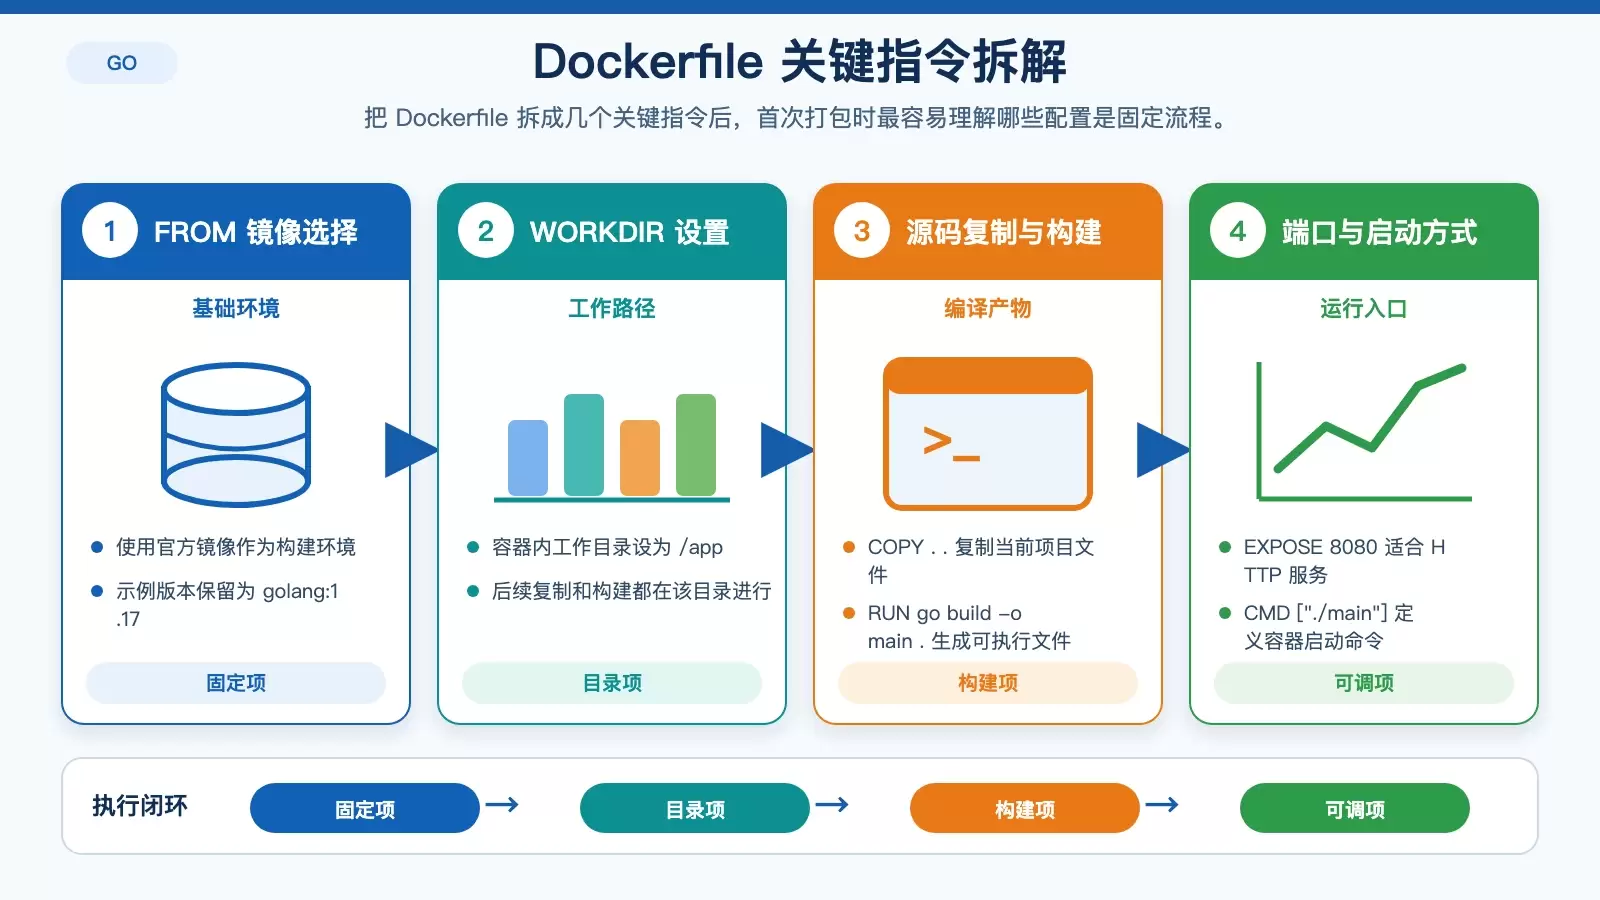
这篇文章用一套最小可行流程,演示如何在 Ubuntu 上把 Go 应用打包成 Docker 镜像并运行起来。你可以直接照着完成 Docker 安装、编写 Dockerfile、构建镜像、启动容器和结果验证,也能顺带判断哪些配置需要按项目实际情况调整。
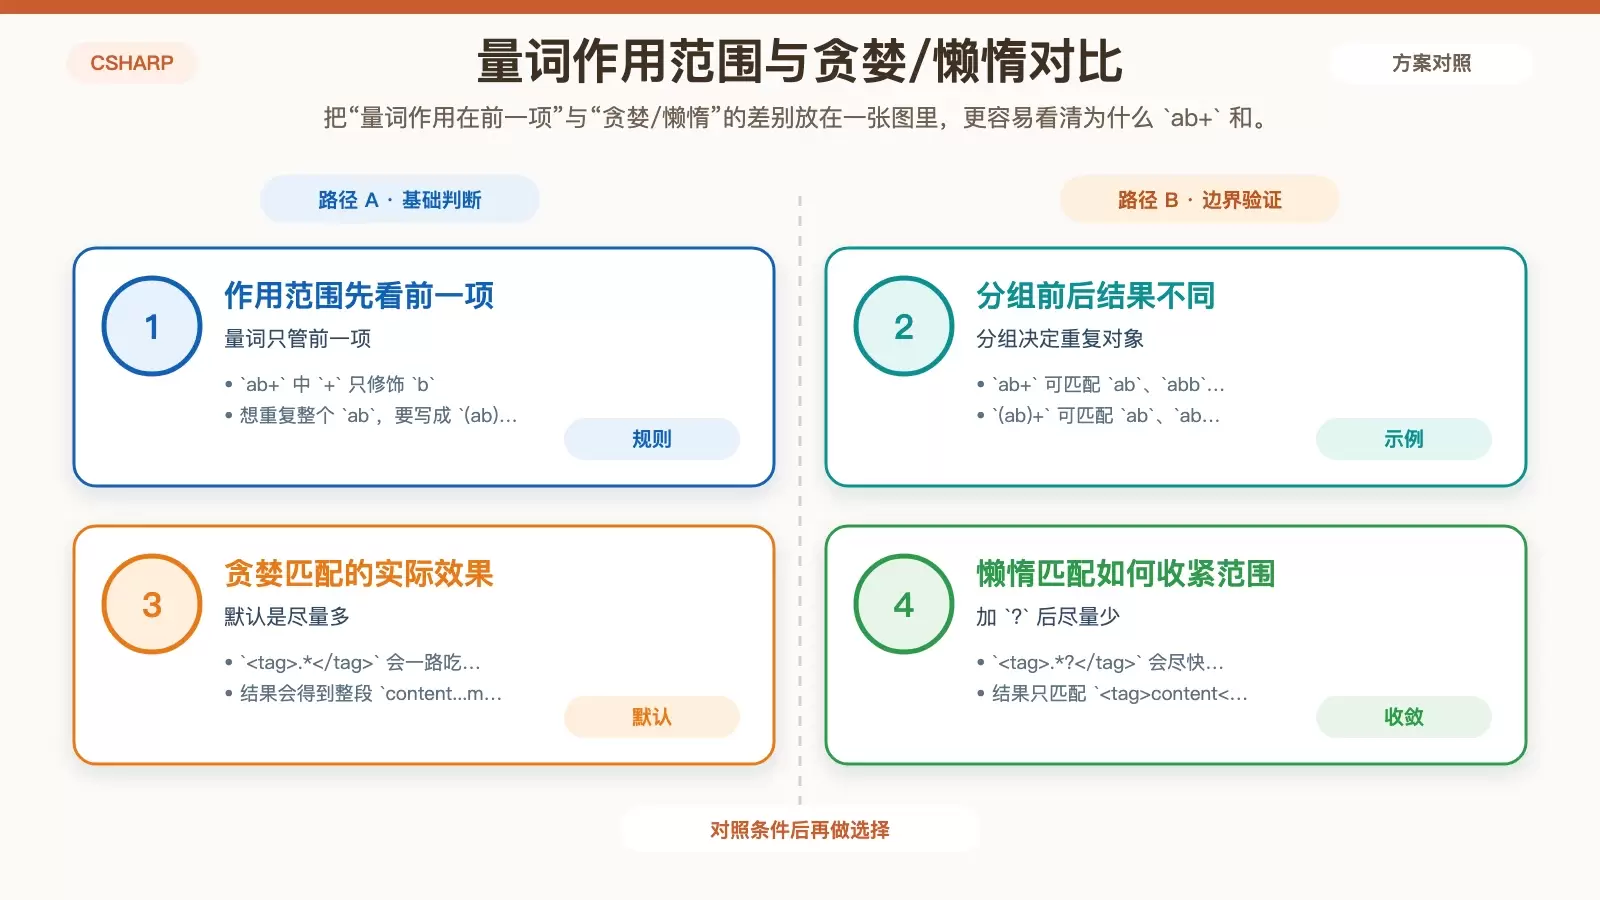
这篇文章用 C# 的常见示例,把正则表达式里最容易混淆的量词、贪婪与懒惰、锚点、单词边界以及 `Multiline`/`Singleline` 选项串起来讲清楚。重点不是死记符号,而是判断它们分别控制“重复次数”“匹配范围”和“位置边界”。
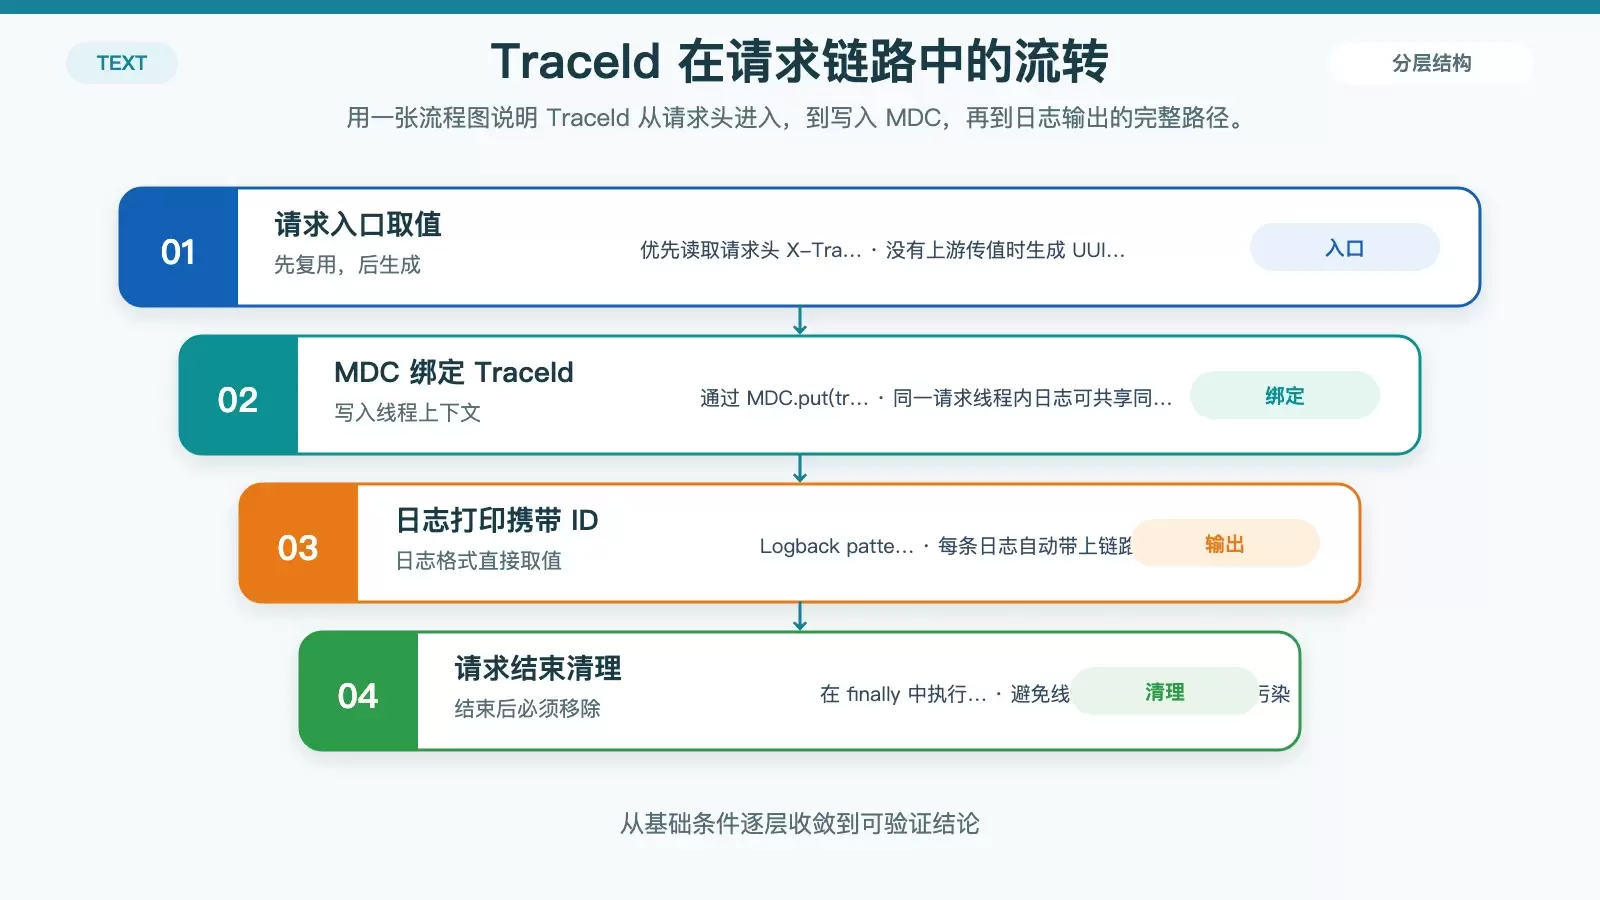
这篇文章用 Spring Boot 常见的 MDC、Filter、AOP 组合,讲清全局日志与请求链路追踪怎么落地:既能给每次请求挂上 TraceId,也能自动记录入参、出参和耗时,并补上脱敏、异步日志、线程池透传等生产环境关键细节。
按日期统计每日新增用户,常见误区不是 SQL 语法,而是统计口径和时间处理。关键点有三处:先把时间截断到“日”,再用每个用户的最早注册时间定义新增,最后把时间过滤放进子查询,同时排除 NULL 和异常时间值,结果才可靠。