

Python结合Pandas与SQLAlchemy连接Oracle数据库并生成DataFrame
本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
2026-10-13
10

本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
本文介绍一种基于Python的批量端口检测方法,旨在解决传统工具如nmap或在线站长工具在批量处理、端口范围指定及日志记录方面的不足。通过解析配置文件,该方案支持同时检测多个地址或域名,并允许指定端口范围进行批量扫描。结果包含开放端口状态及详细日志,适用于局域网或外网环境的快速端口可用性验证,后续可进一步优化异步处理以提升效率。
本文介绍在Python中如何将print函数的输出内容保存至txt文件。通过自定义Logger类并重定向sys.stdout,实现控制台输出与文件记录同步进行。代码示例展示了如何创建日志对象、重写write和flush方法,以及最终的应用效果,适用于需要保留运行日志的场景。
本文介绍如何使用Python的win32com模块结合MySQLdb,自动从MySQL数据库获取表结构信息并生成Word文档。内容涵盖模块下载、数据库连接、表及字段信息提取,以及利用COM接口创建Word表格并填充数据的完整流程,旨在简化数据库设计文档的编写工作。
本文介绍如何利用Python读取保存训练ground_truth的文本文件,通过splitlines()方法逐行获取图片标签数据,并按空格分割提取边界框坐标。
本文介绍Python中如何使用csv模块进行CSV文件的读写操作。重点解析写入时因换行符导致的多余空行问题,并提供通过设置newline=''参数的解决方案。包含完整的写入与读取代码示例,帮助开发者快速掌握Python处理CSV数据的核心技巧。
本文介绍如何在Python中使用Dataframe筛选出两列时间值相差一年的所有行。通过示例代码展示具体实现步骤,包括原始数据与筛选后数据的对比分析,帮助读者快速掌握相关技巧。
本文介绍在 Python 3.x 中判断字典是否包含特定键的方法。Python 3 已废弃 has_key() 函数,推荐使用 'key' in dict 的方式。该方法底层调用 __contains__ 方法,既简洁又符合现代 Python 编程规范,避免了旧版本代码在 Python 3 中报错的问题。
本文介绍Python中Pandas库对DataFrame数据的修改与NaN值处理方法。通过loc和iloc定位修改特定单元格,利用条件筛选批量更新数据,并演示如何添加含NaN的新列。最后讲解使用isnull和np.any检测缺失值,以及fillna进行数值填充的完整流程,帮助开发者高效处理数据异常。
本文介绍在Python中利用scipy进行数据插值以及使用pandas进行下采样的方法。通过scipy.interpolate模块实现从1024点到4096点的Bspline插值,并利用pandas的date_range与resample功能,以不同频率对时间序列数据进行高效重采样和降频处理,适用于文件操作及信号处理场景。
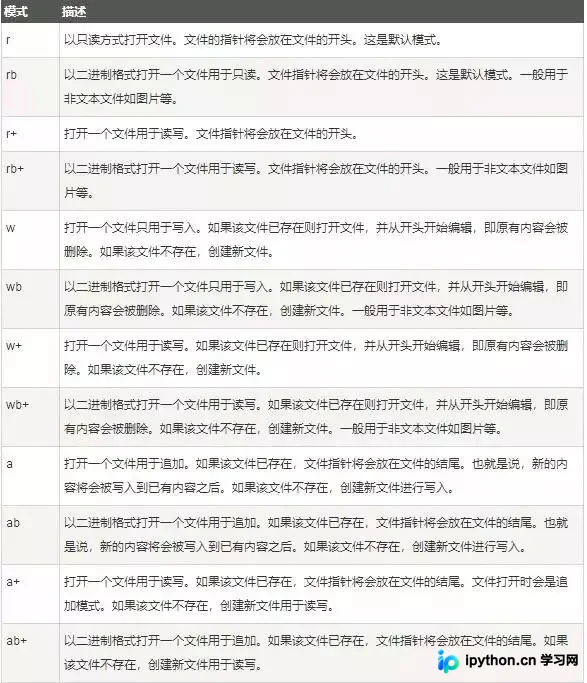
本文系统梳理Python中四种主流文件存取方式。详细解析内置open/write/read/close方法及其with语法最佳实践;介绍NumPy模块中loadtxt/savetxt处理数组数据的用法;列举os模块中文件创建、重命名、删除及底层写入操作;最后演示csv模块读写CSV文件的完整流程。涵盖参数说明、代码示例及常见错误排查,适合Python初学者及需要处理数据文件的开发者参考。
本文详细解析NumPy中ndarray多维数组的取值机制,重点讲解冒号与逗号在切片操作中的应用。通过具体代码示例,演示如何选取特定行、列及子数组,帮助开发者掌握高效的数据提取技巧。