

Django Admin 自定义替换 change 页面模板的方法
本文介绍如何在 Django Admin 中通过模板继承机制自定义替换 change 页面。核心步骤包括:将 admin/change_form.html 拷贝至项目指定目录,利用 extends 标签继承原模板,并在子模板中修改样式或删除按钮。该方法适用于需要调整后台编辑界面布局或功能的场景,通过覆盖特定应用的模板实现精细化控制。
2026-10-13
10

本文介绍如何在 Django Admin 中通过模板继承机制自定义替换 change 页面。核心步骤包括:将 admin/change_form.html 拷贝至项目指定目录,利用 extends 标签继承原模板,并在子模板中修改样式或删除按钮。该方法适用于需要调整后台编辑界面布局或功能的场景,通过覆盖特定应用的模板实现精细化控制。
本文介绍了在 Python 中利用 xlwt 和 xlsxwriter 库将数据导出为 Excel 文件的两种实现方式。通过 Django 框架示例,展示了如何从数据库查询数据并生成 .xls 或 .xlsx 格式文件,包含单元格样式设置及 HTTP 响应处理,适用于数据量较大或需要复杂格式的场景。
本文详细解析了Python 3中调用urllib.urlencode时出现的AttributeError错误。通过对比Python 2与Python 3的模块结构差异,指出urlencode功能已迁移至urllib.parse模块,并提供正确的import语句与调用示例,帮助开发者顺利完成代码升级。
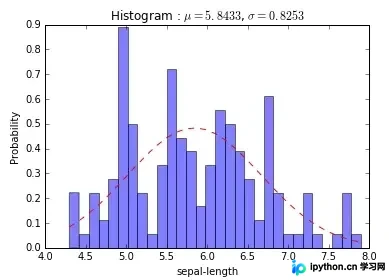
本文介绍在Python中为直方图添加拟合曲线的两种常用方法。首先通过matplotlib的mlab模块结合正态分布函数进行拟合,但需注意其局限性;其次推荐采用seaborn库的distplot函数,通过设置kde参数实现更贴合数据分布的核密度估计曲线,并支持自定义线条与柱状图样式。
本文介绍在Python多网卡环境中,如何通过修改socket的source_address参数来指定特定网卡发送HTTP请求。文章详细解析了urllib和requests库的底层实现,提供了针对urllib3的适配方案及解决ConnectionError异常的代码示例,帮助开发者在多IP场景下精确控制网络出口。
本文介绍如何在Django中通过自定义装饰器实现用户登录状态判定。利用Session存储用户ID,未登录用户自动重定向至登录页,登录成功后跳转至指定业务页面。代码包含视图层处理、Session读写及Cookie记忆功能,提供完整的登录判定与跳转逻辑示例。
本文介绍Django中使用auth模块时遇到的TypeError错误。当调用is_authenticated()方法时报错,原因是该属性为布尔值而非方法。解决方法是移除括号,直接使用if request.user.is_authenticated进行判断,无需调用函数。
本文详解Flask框架中的消息提示与异常处理机制。通过flash和get_flashed_messages实现登录界面的用户反馈,利用errorhandler修饰器自定义404错误页面,并结合abort方法触发指定错误状态,帮助开发者完善Web应用的交互体验与错误处理逻辑。
本文详解如何使用Python Scrapy框架爬取豆瓣电影Top250数据,并通过自定义Pipeline将结果持久化至MongoDB数据库。内容涵盖items定义、Spider编写、Pipeline配置及Settings设置,提供完整代码示例与测试步骤,帮助开发者掌握Web爬虫与数据库存储的结合应用。
本文深入解析Django中Model的两种核心保存方式:save()与create()。通过对比代码示例,说明save()需先实例化再调用保存,而create()一步完成对象创建与入库。此外,特别指出Auth用户模型应使用create_user以自动处理密码哈希,帮助开发者选择更合适的数据持久化方案。
本文详细解析Python中reload()函数的演变。在Python2中,reload()为内置函数,可直接重新加载模块;而在Python3中,该功能被移至imp及importlib模块。文章通过代码示例对比两者差异,并说明多次import与reload的行为区别,提醒开发者谨慎使用以避免潜在问题。
本文介绍如何利用Django后端与ECharts前端库结合,实现从PLC采集数据的实时动态曲线展示。通过Django定时任务获取数据,前端使用AJAX异步请求获取最新数据,并借助setInterval定时刷新ECharts图表,确保页面不重载即可更新显示内容。