

Python数据分析pandas模块用法实例详解
本文详细解析Python中pandas模块的核心用法,涵盖Series与DataFrame的创建、属性获取及多种索引方式。通过实例演示字典、数组等数据源的转换,深入讲解loc、iloc等高级索引技巧,并指出ix方法的弃用情况,帮助开发者掌握高效的数据处理技能。
2026-10-13
19

本文详细解析Python中pandas模块的核心用法,涵盖Series与DataFrame的创建、属性获取及多种索引方式。通过实例演示字典、数组等数据源的转换,深入讲解loc、iloc等高级索引技巧,并指出ix方法的弃用情况,帮助开发者掌握高效的数据处理技能。
本文详细介绍如何利用Python的SciPy库计算正态分布的置信区间,并通过Matplotlib绘制概率密度曲线。内容涵盖使用stats.norm.interval获取指定置信水平的上下界,以及通过norm.pdf生成理论分布图。同时解析了68-95-99.7法则在正态分布中的面积分布规律,帮助开发者快速掌握统计分析与可视化的核心代码实现。
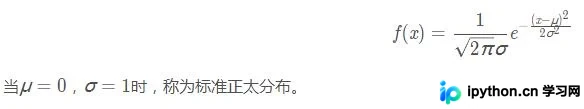
本文详细记录并解决了Flask项目在Windows环境下通过公网IP访问失败的问题。排查过程涵盖阿里云安全组端口放行、Windows Server防火墙配置以及PyCharm运行配置的修正。重点指出在PyCharm中,若直接修改app.run参数无效,需检查Edit-Configuration中的Additional options设置,确保--host和--port参数正确生效,从而实现外网正常访问。
本文介绍Python核心开发者Brett Cannon关于安装第三方库的建议。推荐使用python -m pip确保精确控制安装路径,避免多版本Python冲突。同时强调必须使用虚拟环境隔离依赖,推荐使用python -m venv或容器化方案,并通过pipx独立管理开发工具,以保障系统Python环境的稳定与整洁。
本文详细介绍如何在Django项目中集成JWT进行身份认证。涵盖环境要求(Django 2.2, Python 3.6等)、项目创建、依赖安装、数据库配置及路由设置。通过具体代码示例展示如何生成Token,并使用Postman进行接口测试,确保用户访问受保护资源时需携带有效Token。
本文详细讲解在Windows 10系统中为Python 3.7环境安装TensorFlow和Keras的步骤。重点强调必须使用64位Python,提供通过官方渠道或非官方预编译包(如UCI LFD)安装的方法,并包含使用cmd命令行切换目录及更新pip的操作指引,帮助开发者顺利完成深度学习环境搭建。
本文深入解析Python中常用的魔法函数,包括用于对象字符串表示的__repr__与__str__的区别,以及实现序列行为的__getitem__、__len__、__setitem__和__delitem__。通过具体代码示例,展示如何自定义类的行为以支持索引访问、长度查询和属性赋值,帮助开发者更好地理解Python的面向对象特性。
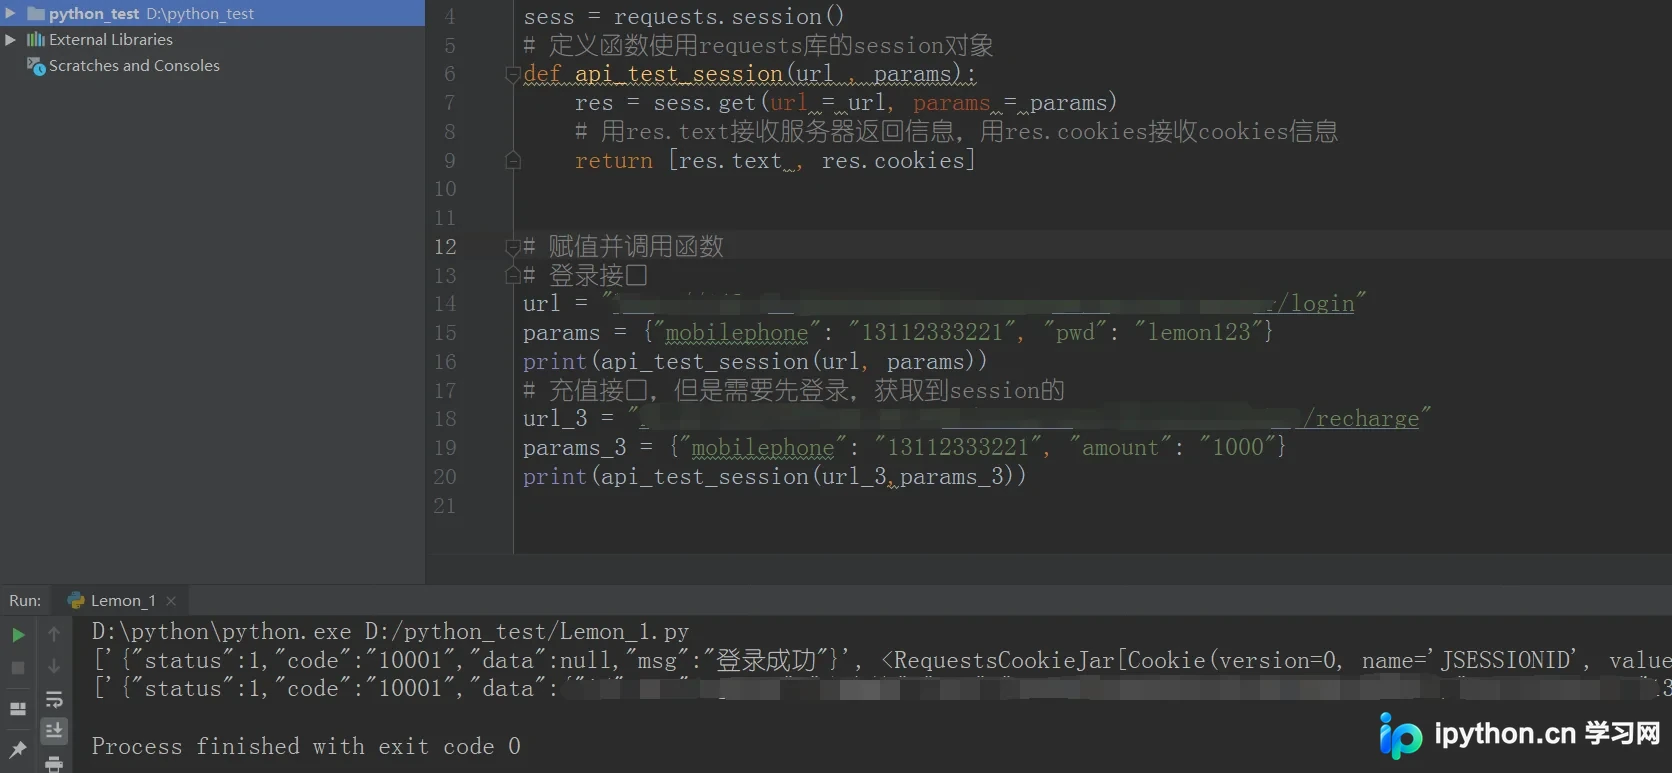
本文详解Python中requests库的session机制。针对HTTP无状态特性,通过对比普通请求与session对象,说明如何利用requests.session保持登录状态、保存Cookie及会话信息,适用于接口与UI自动化测试中的登录场景。
本文介绍如何在Python交互控制台中启用Tab键自动补全功能,并通过配置环境变量PYTHONSTARTUP实现自定义清屏命令。通过创建启动脚本,用户可在进入Python环境时自动加载readline模块及自定义函数,提升开发效率与体验。
本文深入解析Django内置User模型的字段与验证机制,并详细对比四种扩展用户模型的方法:Proxy模型、一对一外键、继承AbstractUser及继承AbstractBaseUser。重点说明各方案的适用场景、代码实现及settings配置,帮助开发者根据需求选择最优的用户管理策略。
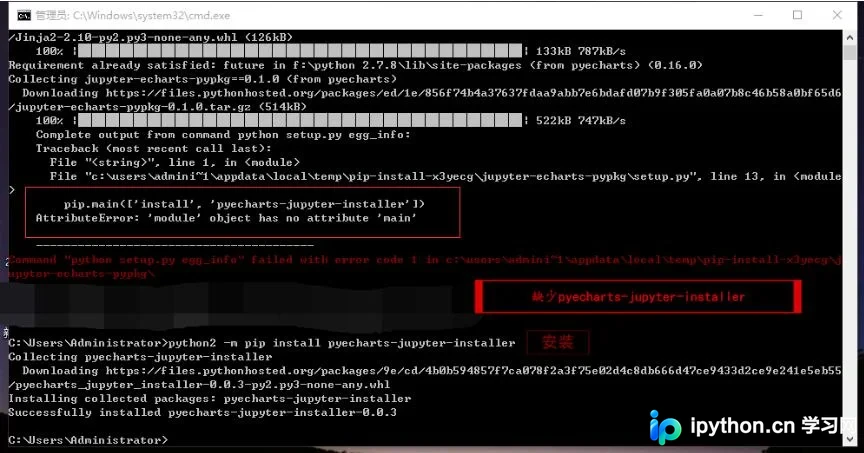
本文记录在Python环境中安装pyecharts时遇到的两个典型问题:一是缺少pyecharts-jupyter-installer依赖,二是安装MarkupSafe时因版本或权限导致的报错。通过单独安装.whl文件等方式解决依赖冲突,并附带Python 2与3共存时的pip命令区分技巧,帮助开发者顺利部署数据可视化组件。
本文详细介绍Django中Session数据的多种存储方式,包括默认数据库存储、内存缓存、文件存储以及缓存加数据库的混合模式。通过修改settings.py中的SESSION_ENGINE参数,开发者可根据性能需求和数据持久性要求灵活选择存储后端,并提供了相关安全与过期策略的配置说明。