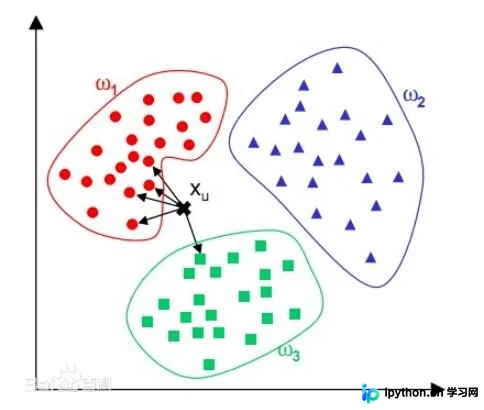
Python实现KNN分类算法:原理、代码与鸢尾花数据集测试
本文详细解析Python中KNN(K-Nearest Neighbor)分类算法的实现原理与代码。通过鸢尾花数据集,演示如何加载数据、计算欧拉与曼哈顿距离,并完成分类预测。文章包含完整Python代码示例及测试集结果分析,探讨算法鲁棒性与计算开销,适合机器学习初学者参考。
2026-10-13
22

本文详细解析Python中KNN(K-Nearest Neighbor)分类算法的实现原理与代码。通过鸢尾花数据集,演示如何加载数据、计算欧拉与曼哈顿距离,并完成分类预测。文章包含完整Python代码示例及测试集结果分析,探讨算法鲁棒性与计算开销,适合机器学习初学者参考。
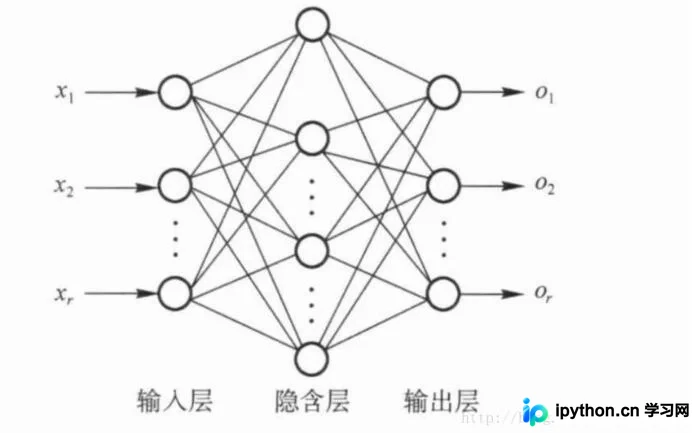
本文深入解析多层感知器如何解决Rosenblatt感知器的非线性分类局限。详细推导Tanh激活函数的可导特性及其在反向传播中的应用,通过局部梯度计算与增量梯度下降法优化权值。结合Python实战代码,展示二维数据训练、可视化分类边界及模型迭代过程,帮助读者掌握神经网络核心算法。
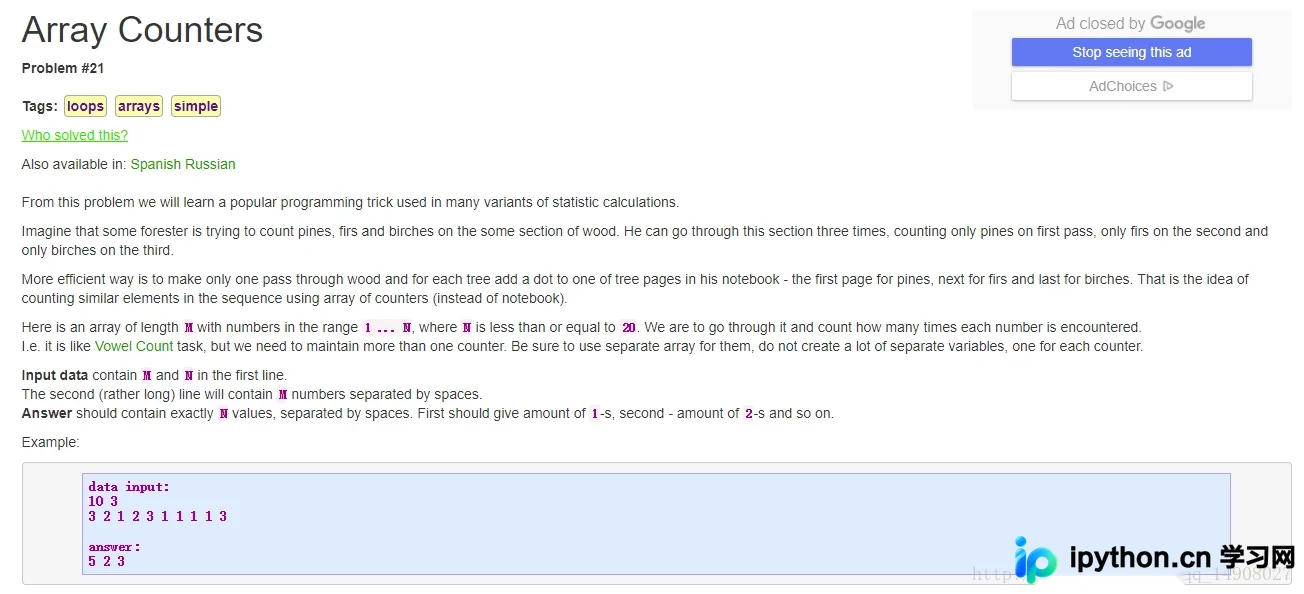
本文介绍在Python中统计数组元素出现次数的两种方法。首先分析基于排序的暴力解法,指出其逻辑复杂且效率较低。随后重点讲解利用“桶”思想的优化方案,通过固定长度数组直接映射元素频次,实现O(N)时间复杂度。最后延伸介绍基于桶统计结果的桶排序实现,展示如何将频次统计与排序结合,适用于元素范围有限的场景。
本文详细介绍Python中字符串拼接的六种方法,包括加号连接、逗号分隔、隐式直接连接、百分号格式化、join函数以及多行字符串自动拼接。通过具体代码示例对比各方法的语法特点与输出结果,帮助开发者根据场景选择最优方案。
本文详细介绍Python中完全树与最小堆的实现方法。通过继承list类构建CompleteTree,重点解析siftdown和siftup两个核心调整函数的逻辑,展示如何维护最小堆性质。文章包含完整的Python代码示例及运行结果,帮助开发者理解堆排序与堆结构的底层原理。
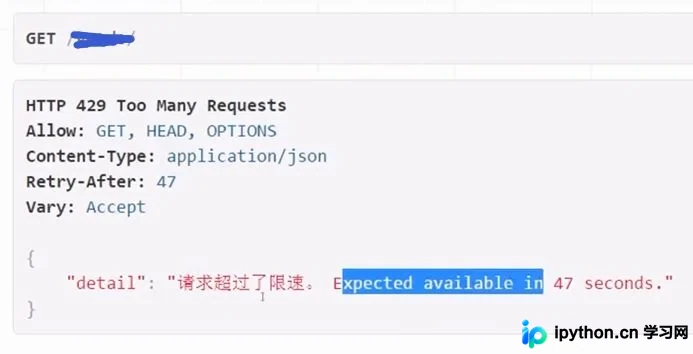
本文深入解析Django REST Framework中的限速机制,涵盖全局settings.py配置方法,详细对比AnonRateThrottle与UserRateThrottle的应用场景及判断依据,并解析DEFAULT_THROTTLE_RATES的时间单位设置。通过具体代码示例,展示如何在视图中应用限速策略,帮助开发者有效保护API接口免受滥用。
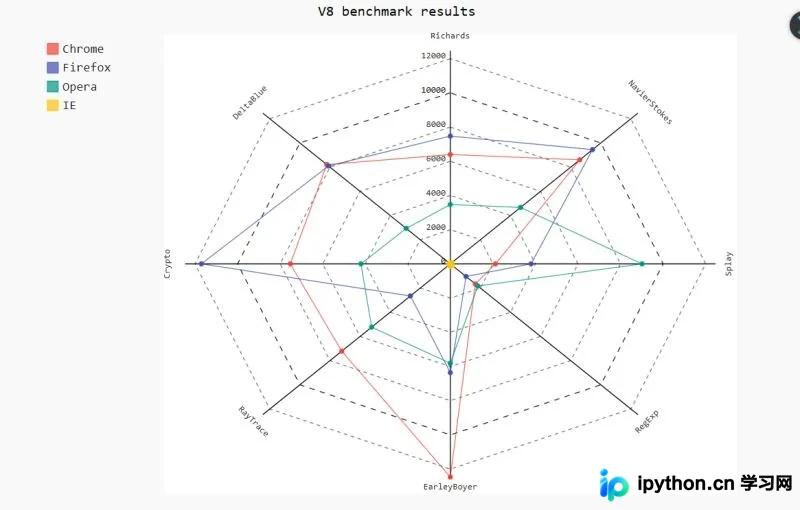
本文介绍如何在Python中利用pygal库绘制雷达图。通过具体代码示例,展示如何配置图表标题、X轴标签及多组数据,并生成SVG文件。文章还提及了SVG文件在浏览器中的直接打开方式及默认保存路径,为数据可视化初学者提供实用参考。
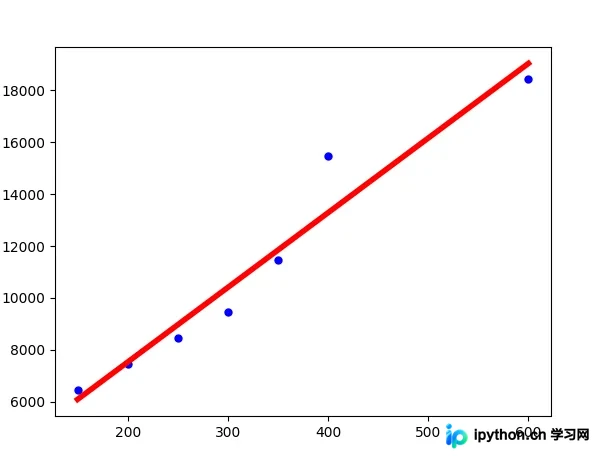
本文通过Python sklearn库演示线性回归的两种典型应用场景。首先利用历史房屋面积与价格数据,建立一维线性模型进行直线拟合与价格预测;其次通过虚拟数据构建三维空间平面模型,展示多变量线性方程的系数求解与预测方法。代码包含数据预处理、模型训练、参数获取及可视化绘图完整流程,适合机器学习初学者参考。
本文详细介绍Python标准库inspect模块的核心功能,包括如何获取函数和类的参数信息、提取源代码及判断对象类型。重点解析getargspec方法处理*args和**kwargs的技巧,以及通过字节码co_flags属性判断特殊参数的实现原理,帮助开发者深入理解Python对象反射机制。
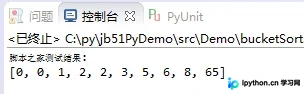
本文详细介绍Python中桶排序(计数排序)的实现方法。通过创建最大数值大小的数组统计元素频次来排序,该方法执行速度极快,但空间消耗巨大且仅适用于非负整数。文章提供了完整代码示例及运行结果,并分析了其适用场景与局限性。
本文详解如何利用Django内置的信号系统监控模型对象特定字段的变化。通过结合post_init与post_save信号,在实例初始化时缓存字段值,保存时进行比对,从而实现对特定字段变更的低耦合监控,无需修改模型本身代码。
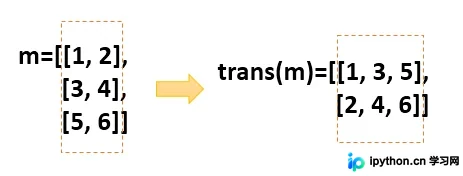
本文深入探讨Python中矩阵转置的多种实现方式。从直观的二重循环方法出发,分析了基于字典转换的潜在缺陷,如键值冲突及非方阵处理问题。最终引出利用zip函数配合解包操作的高效解法,展示了Python处理数据结构转换的简洁与强大,适合希望优化代码简洁性的开发者参考。