

Python高效处理超大二进制浮点数据:从struct解析到split切割
本文详解Python中利用struct包将二进制文件转换为浮点数的方法。针对小文件,演示一次性读取并reshape为矩阵;针对38.1G超大文件,提出结合Linux split命令按大小切割文件,再通过Python循环逐块使用struct.unpack解析并保存为.npy格式的高效处理方案,解决内存溢出问题。
2026-10-13
22

本文详解Python中利用struct包将二进制文件转换为浮点数的方法。针对小文件,演示一次性读取并reshape为矩阵;针对38.1G超大文件,提出结合Linux split命令按大小切割文件,再通过Python循环逐块使用struct.unpack解析并保存为.npy格式的高效处理方案,解决内存溢出问题。
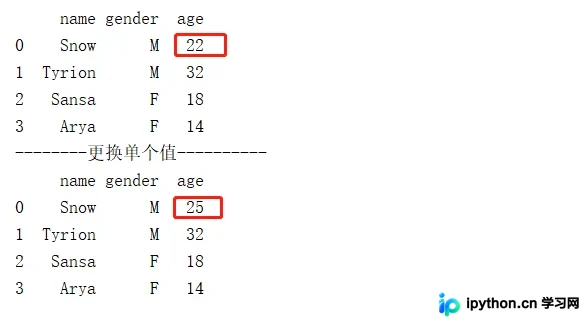
本文介绍如何使用Pandas库修改DataFrame中的特定值,包括使用loc、iloc、at和iat方法。同时详细讲解如何在DataFrame末尾或指定位置新增列,以及如何通过append方法添加新行,提供完整代码示例和注意事项。
本文深入解析Python中动态创建类的两种核心方法。首先介绍基于条件判断的硬编码实现,随后重点阐述利用type元类动态生成类及其子类的完整流程。通过具体代码示例,展示如何为动态类绑定属性与方法,并验证继承关系,帮助开发者掌握Python运行时类构建的高级技巧。
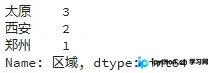
本文详解pandas库中value_counts()函数的使用方法。涵盖Series单个列的频次统计、默认降序与升序排列、normalize参数计算占比,以及DataFrame多列批量统计。重点解析ascending和normalize参数的具体应用及空值处理机制,帮助开发者高效进行数据分布分析。
本文详细介绍 pandas.cut 函数的核心用途与参数配置。通过解析 bins 的三种形式、right 边界控制、labels 标签映射及 retbins 返回值等关键参数,结合年龄分组实战案例,展示如何实现数据离散化、自定义区间分割及结果可视化,帮助开发者高效处理连续数据的分类问题。
本文系统总结了Python中对文件和目录的核心操作方法,涵盖遍历目录(含递归)、删除文件与多级文件夹、文件重命名、创建多级文件夹、移动文件、查找指定扩展名文件以及计算文件夹大小等实用功能。结合网盘服务端开发场景,提供完整代码示例与辅助函数,帮助开发者高效处理文件系统任务。
本文深入对比Python中in、find、index及__contains__四种子串查找方式的性能。测试表明in运算符速度最快,因其直接调用C层函数而避免虚拟机开销;find与index核心逻辑一致,但index在查找失败时抛出异常的机制导致其性能略低。文章从CPython源码层面解析了操作符与属性调用的底层差异,建议在实际开发中优先使用in运算符以获得最佳可读性与执行效率。
本文介绍如何在同一局域网内,利用Python的Socket库实现树莓派与PC之间的即时通讯。通过编写rpi.py服务端脚本和computer.py客户端脚本,双方建立TCP连接后,即可在PC端输入字符并在树莓派终端实时显示,实现简单的双向数据交互。
在PyQt5开发中,若QTimer未产生预期效果,通常是因为定时器对象未正确绑定到事件循环所在的窗口。将QTimer实例化时指定父级QWidget,或将其关联至界面对象,即可使timeout信号正常触发。本文通过代码示例说明这一关键绑定步骤,帮助开发者快速解决定时器无法运行的问题。
本文系统讲解pandas中DataFrame数据选取的三种层次:行列、区域及单元格。详细解析df[]、df.loc[]、df.iloc[]、df.ix[]、df.at[]及df.iat[]的语法特性与适用场景,通过代码示例展示整数切片、标签索引、布尔数组及Callable对象的使用差异,帮助开发者精准掌握数据定位技巧。
本文介绍在Pandas中处理DataFrame数据的四种删除场景:按列名删除、按索引删除行、基于数值条件筛选以及基于字符串内容的过滤。通过模拟股票交易数据,演示drop方法及布尔索引的使用,帮助开发者掌握灵活的数据清洗技巧。
本文介绍在Django框架中如何利用ORM实现批量更新数据。通过MyModel.objects.filter()结合update()方法,可高效处理如类别及子类parentcode同步更新等场景,避免编写原生SQL,保持代码简洁与可维护性。