

Python random模块常用函数详解与代码示例
本文详细解析Python中random模块的核心函数,包括从序列中随机选取元素的choice、指定范围内按步长选取的randrange、生成[0,1)浮点数的random、打乱列表顺序的shuffle以及生成指定范围实数的uniform。通过具体代码实例展示各函数的参数设置与返回值特征,帮助开发者快速掌握Python随机数生成的标准用法。
2026-10-13
22

本文详细解析Python中random模块的核心函数,包括从序列中随机选取元素的choice、指定范围内按步长选取的randrange、生成[0,1)浮点数的random、打乱列表顺序的shuffle以及生成指定范围实数的uniform。通过具体代码实例展示各函数的参数设置与返回值特征,帮助开发者快速掌握Python随机数生成的标准用法。
本文详解Python中访问字符串值的三种核心方法:通过索引下标获取指定字符、利用[start:stop:step]语法进行切片截取,以及使用for循环遍历字符串。内容涵盖索引规则、切片参数含义及负数步长处理,并附带完整代码示例,帮助开发者快速掌握字符串操作技巧。
本文详细介绍如何在 TensorFlow 中自定义神经网络层。通过继承 tf.keras.Layer 类实现 __init__、build 和 call 方法,可灵活创建特定业务逻辑的层。同时,利用 tf.keras.Model 组合现有层构建复杂网络结构,如 ResNet 残差块,帮助开发者掌握模型架构设计的核心技巧。
本文介绍在TensorFlow中如何配置硬件资源。通过设置环境变量CUDA_VISIBLE_DEVICES可指定使用特定编号的GPU;利用tf.device上下文管理器可实现多GPU并行处理;配置/cpu:0则强制使用CPU进行计算。
本文详解Python中通过序列索引进行For循环迭代的方法。重点解析len()获取长度与range()生成索引序列的配合使用,涵盖字符串、列表及元组的遍历示例,并说明集合与字典因无序性不支持索引访问的限制。
本文介绍如何利用Python实现IP地址的包含关系判断。通过自定义函数将不同格式的IP地址(如标准IP、范围IP、CIDR等)统一转换为十进制数值范围,进而通过数值比较判断两个IP地址之间是否存在包含关系,解决了标准库在某些场景下的局限性。
本文详细解析TensorFlow中出现的uninitialized value错误。主要涵盖两个原因:一是误用tf.metrics.mean_squared_error需初始化局部变量,二是节点错误定义在tf.Session内部。提供替换为tf.losses或添加初始化器的具体修复代码,帮助开发者快速定位并解决变量未初始化导致的运行异常。

本文详细介绍在PyCharm中导入现有Python项目并配置Python解释器的具体操作流程。通过File菜单打开项目文件夹,进入Settings配置Project Interpreter,选择本地Python.exe路径或新建环境,即可完成环境搭建,确保项目正常运行。
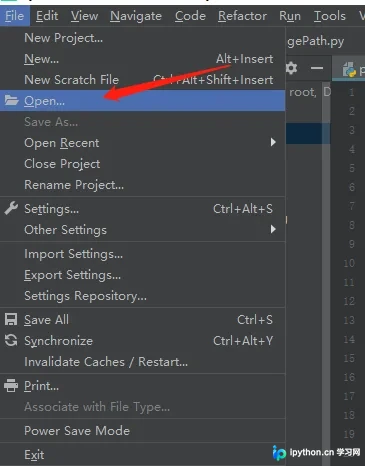
本文介绍如何在运行TensorFlow Python程序时限制对GPU和CPU的占用。通过设置环境变量CUDA_VISIBLE_DEVICES指定可见GPU,或在代码中配置gpu_options.allow_growth实现显存按需分配。同时,提供了限制CPU线程数的方法,帮助优化资源使用,避免霸占所有GPU资源。
本文介绍了在TensorFlow项目中从TXT文件读取数据的两种主流方法:使用numpy的loadtxt函数和pandas的read_csv函数。文章详细展示了两种方法的代码实现,并重点强调了读取后的数据形状必须与模型定义的placeholder保持一致,以确保后续训练流程的顺利进行。
本文详细解析Python中json.dumps与json.loads函数的核心区别。json.dumps用于将Python对象(如字典)序列化为JSON格式的字符串,而json.loads则执行相反操作,将JSON字符串反序列化为Python对象。文章通过具体代码示例展示了中文处理中ensure_ascii参数的作用,帮助开发者准确掌握数据交换格式的处理方法。
本文介绍如何在 TensorFlow 中实现自定义 Layer 并将其整合进多层计算图。通过定义滑动窗口平均操作及后续线性变换与激活函数,展示从占位符定义、卷积层构建到自定义逻辑层添加的完整流程,最终执行计算图获取结果。