Python正则表达式抓取网页图片实战
本文介绍利用Python正则表达式从指定网页提取并保存图片的方法。通过定义匹配规则筛选图片链接,结合urllib库实现批量下载。文中附带Python代码示例及正则表达式在线测试工具链接,帮助开发者快速掌握网页图片抓取技巧。
2026-10-13
23

本文介绍利用Python正则表达式从指定网页提取并保存图片的方法。通过定义匹配规则筛选图片链接,结合urllib库实现批量下载。文中附带Python代码示例及正则表达式在线测试工具链接,帮助开发者快速掌握网页图片抓取技巧。
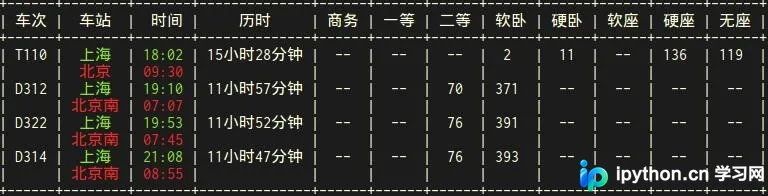
本文介绍如何使用Python编写一个命令行火车票查询器。通过结合docopt解析参数、调用12306接口获取数据,并利用prettytable格式化输出,实现仅输入出发站、到达站及日期即可查询列车信息的功能。
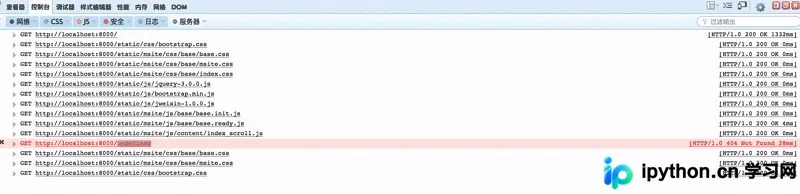
本文记录在Django 1.10.6环境下,因前端图片懒加载插件导致后台日志出现大量无效404错误的排查过程。通过分析浏览器控制台和调用堆栈,发现懒加载脚本在src为undefined时仍发起请求。解决方案是在调用懒加载函数前处理src值,避免无效请求。
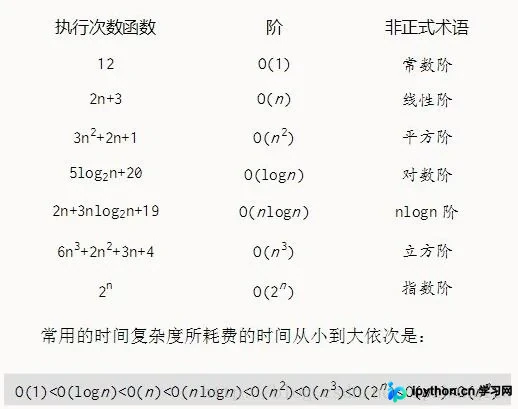
本文系统讲解Python中常见算法的时间复杂度表示法,涵盖常数阶O(1)、对数阶O(logn)、线性阶O(n)至指数阶O(2^n)。通过具体代码示例与推导大O阶的三步法则,帮助开发者理解不同规模下算法执行效率的变化规律,掌握评估程序性能的核心方法。
本文介绍在Python中获取当前运行函数名称及位置信息的方法。通过利用sys模块捕获异常并解析traceback对象,可以获取调用函数的名称、文件名及行号。该方法适用于调试场景,但需注意可能带来的性能损耗。
本文深入解析Python类继承中__init__方法的实际调用行为。重点说明子类未显式声明__init__时如何调用父类初始化,以及显式声明后父类属性缺失的问题。同时探讨多继承场景下的MRO查找机制及super函数的使用特性,通过代码实例展示不同情况下的对象属性状态。
本文深入解析 Python Beautiful Soup 库的搜索功能,涵盖 find() 与 find_all() 的核心用法。详细讲解如何通过标签名、属性、文本及正则表达式精准定位元素,并演示处理自定义属性和 CSS 类属性的技巧。此外,还介绍了利用父级、同级及下级标签进行关联搜索的高级策略,帮助开发者高效提取网页数据。
本文介绍如何在Python中使用列表模拟字典,重点讲解利用拉链法解决Hash冲突的方法。通过在每个哈希桶中嵌套子列表,即使发生碰撞也能存储数据,配合良好的Hash函数和足够大的表长,可实现接近O(1)的查找效率。
本文详解使用Python爬取搜狗图片壁纸的全过程。针对网页动态加载特性,通过F12开发者工具分析Network中的XHR请求,定位获取图片列表的真实API接口。利用requests库发送请求并解析JSON数据,结合urllib实现图片的批量下载,提供完整代码示例与调试技巧。
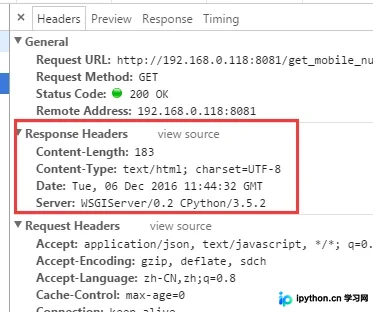
本文针对Python Bottle框架中前端Ajax跨域访问时状态码为200却进入error回调的问题进行解析。指出常见添加Access-Control-Allow-Origin头的方法无效,通过深入Bottle源码发现HTTPResponse类在apply方法中覆盖响应头的机制导致问题。提供修改Bottle源码中HTTPResponse类的具体方案,确保跨域头正确传递,解决Python2与Python3环境下的兼容性问题。
生产环境中Python脚本监控耗时远大于内部统计值,排查发现time.clock()仅统计CPU时间,忽略IO与等待。本文对比datetime.now、time.time与time.clock三种方式,明确程序执行时间应包含CPU、IO及休眠时间,推荐使用前者获取真实耗时。
本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。