Pandas中cum系列与rolling系列函数的使用指南
本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。
2026-10-13
23

本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。
本文详细介绍如何使用Python读取Excel文件(包括xlsx和xls格式)并进行数据分类统计。通过openpyxl和xlrd两个库,分别演示了基础数据提取与复杂通话记录的分类统计方法,涵盖按地点、类型及号码汇总时长的完整代码实现。
本文介绍如何使用Python的PIL库批量修改图片尺寸并保存至指定路径。通过遍历源目录,利用Image.resize方法调整图像分辨率,并将处理后的图片保存到新目录,适用于样本处理等批量图像预处理场景。
本文通过Python代码详解比特币挖矿核心原理,包括哈希碰撞模拟、工作量证明(PoW)实现及区块链节点同步机制。文章从基础哈希计算入手,展示如何调整难度生成区块,并解析最长链共识规则,帮助开发者理解去中心化网络中的算力校验与数据一致性维护过程。
本文介绍了Python中读写INI配置文件的通用方法。虽然Python作为动态语言常将配置直接写入脚本,但在与其他系统结合时,使用独立的INI文件更为常见。文章提供了基于ConfigParser模块的完整代码示例,展示了如何创建、读取、添加节及设置键值对,并附带了配置文件生成的测试代码,供开发者参考使用。
本文详解 Python 中 Lambda 匿名函数的定义与常规 def 函数的区别,通过绝对值排序和闭包两个典型场景展示其应用。同时结合代码示例分析何时使用 Lambda 更简洁,何时应回归常规函数以保证代码可读性,帮助开发者掌握 Pythonic 编码技巧。
本文详细介绍如何在Python Flask框架中实现页面重定向功能。通过Flask内置的redirect和url_for函数,将根路径请求自动跳转至登录页面。文中提供了完整的Flask服务器代码,并使用Perl脚本模拟HTTP请求,验证重定向行为及最终页面内容,帮助开发者理解Flask路由跳转机制。
本文详细介绍在Python中获取列表元素索引的两种主要方式。针对无重复元素,可直接使用index方法;若列表包含重复值,推荐使用enumerate方法遍历以获取所有索引。此外,文章还补充了如何结合max和min函数快速定位列表中最大或最小值的索引位置,帮助开发者更高效地处理列表数据。
本文介绍在Python中如何强制终止当前正在运行的进程。通过导入os和signal模块,利用os.getpid()获取当前进程ID,并结合os.kill()函数发送SIGKILL信号,实现程序的立即退出。该方法常用于调试失败后的重试场景或需要强制中断执行的逻辑中。
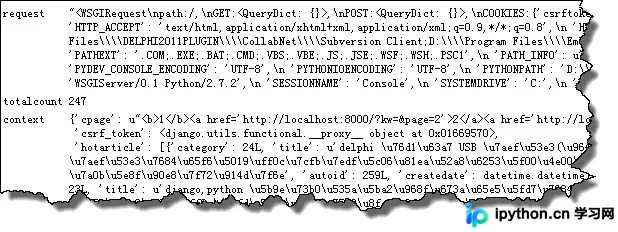
本文介绍如何在Django框架的模板中直接访问Request对象的各种信息。通过配置setting.py中的TEMPLATE_CONTEXT_PROCESSORS,并在视图函数中使用RequestContext渲染模板,可以在HTML模板中直接获取Session、GET参数等数据,无需在视图层额外传递。
本文详细解析Python中获取WebSocket实时数据的四种常见链接方式。通过对比create_connection、ws4py客户端、原生WebSocket模块以及WebSocketApp类,分析各方案在连接稳定性、耗时及代码复杂度上的差异。文章提供了完整的代码示例,帮助开发者根据实际需求选择最合适的实现方案,并指出各方法的潜在优缺点。
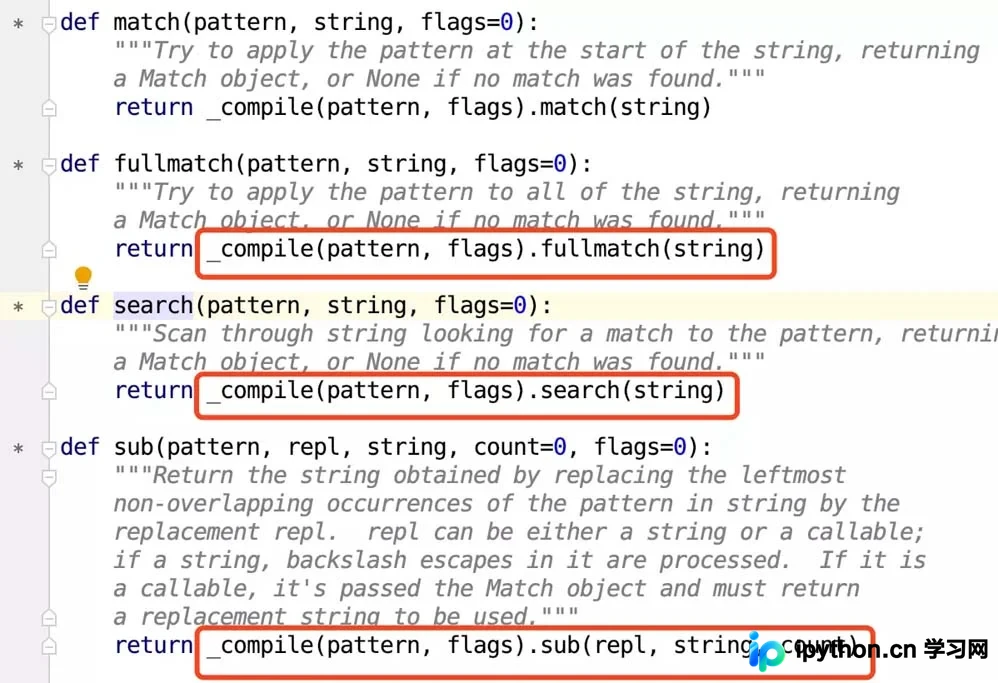
本文通过Python源码深入解析,指出re模块中的search、findall等方法内部已自动调用_compile并具备缓存机制。手动调用re.compile不仅多余,且源自其他语言的不良习惯。文章澄清了关于百万级数据匹配的性能误区,建议开发者直接使用内置方法以获得更简洁高效的代码。