

TensorFlow分布式并行策略详解:数据、模型与流水线并行
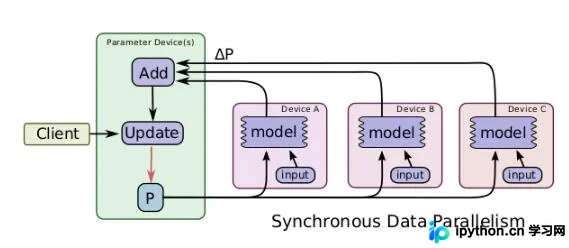
本文深入解析TensorFlow的三种核心分布式并行策略:数据并行、模型并行及模型计算流水线并行。详细对比同步与异步数据并行的机制与适用场景,阐述模型并行在大规模参数处理中的应用,以及流水线并行如何优化单设备资源利用率,帮助开发者根据模型规模与硬件条件选择最优训练方案。
2026-10-12
23

本文深入解析TensorFlow的三种核心分布式并行策略:数据并行、模型并行及模型计算流水线并行。详细对比同步与异步数据并行的机制与适用场景,阐述模型并行在大规模参数处理中的应用,以及流水线并行如何优化单设备资源利用率,帮助开发者根据模型规模与硬件条件选择最优训练方案。
本文深入解析TensorFlow的核心机制,涵盖计算图的构建与执行流程。详细阐述如何通过Context Manager建立Graph,利用Session启动Op并分发至硬件设备。重点讲解Fetches参数在run()中的应用,以及Variable状态管理、初始化方法及与Optimizer的交互,帮助开发者掌握模型训练的基础架构。
本文介绍Python调用外部脚本的三种主要方式:通过import导入模块、使用os.system执行Shell命令,以及官方推荐的subprocess模块。重点解析os.system的局限性及subprocess.Popen的优势,提供具体代码示例与执行结果分析,帮助开发者选择合适方案。
本文提供三个Python爬虫项目实例,分别演示如何抓取内涵段子、智联招聘职位信息及贴吧帖子内容。代码涵盖URL构建、请求头设置、正则解析及文件写入等核心步骤,适合Python初学者参考学习。
在 Python 中使用 OpenCV 进行图像处理时,了解代码的执行效率至关重要。本文介绍如何利用 cv2.getTickCount() 和 cv2.getTickFrequency() 两个函数,精确计算特定代码段的运行时间(秒)。通过记录函数执行前后的时钟数并除以时钟频率,开发者可以方便地评估和优化图像处理算法的性能。
本文介绍如何利用 Python3 的 functools.partial 模块减少可调用对象的参数个数。通过 partial() 函数,可以为一个或多个参数设置固定值,返回一个新的可调用对象。该对象接受未赋值的参数,并将未赋值参数与已赋值参数合并,最终将所有参数传递给原始函数。文章还展示了 partial() 在列表排序中的应用,以及如何用 lambda 表达式实现相同效果。
本文详细介绍使用Python实现12306网站登录并保存Cookie的方法。通过构造特定的请求头、获取设备指纹、处理验证码以及利用Session对象管理Cookie,实现自动登录流程。代码包含完整的请求工具类、会话管理器及URL配置,适用于需要模拟用户登录场景的爬虫开发。
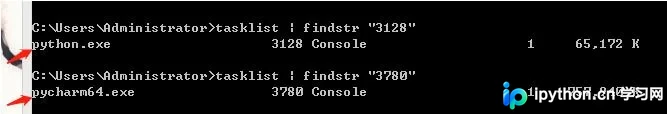
在PyCharm中运行Jupyter Notebook时,若未正常关闭进程,再次启动常会提示端口被占用(默认8888)。本文介绍两种解决方法:通过任务管理器结束进程,或使用命令行工具(netstat、taskkill)精准定位并强制终止占用端口的后台进程,确保开发环境顺利启动。
本文介绍使用Python和OpenCV库实现图片旋转并自动填充新四角背景色的方法。通过计算旋转后的图像尺寸,利用floodFill算法填充四个角落,确保旋转后图像边缘整齐。代码示例展示了如何获取旋转矩阵、计算新尺寸以及自动填充角落颜色,适用于需要保持图像完整性的场景。
本文介绍如何利用Python的Pillow库实现图片的批量合成。通过遍历源图片文件夹,将每张图片缩放至指定尺寸后,随机粘贴到背景图上,并自动保存为新的图像文件。代码包含处理不同宽高比背景图的逻辑,确保粘贴位置不超出边界,适合需要批量生成合成图片的场景。
本文介绍了Python中实现二维列表矩阵转置的四种常用方法。通过示例代码展示了如何交换行列下标,包括初始化零矩阵、动态插入值、列表推导式以及按列提取行元素等技巧,帮助开发者快速掌握二维数组处理技巧。
本文详解 Python pandas 中自定义函数的应用,包括 apply、applymap 及 lambda 表达式。涵盖数据排序、多层索引重构、多表连接(内/外/左右连接)、数据合并及分组聚合(groupby、agg、transform)等核心操作,提供完整代码示例与逻辑解析。