

Python爬虫开发与项目实战:从静态抓取到分布式架构
本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
2026-10-11
23

本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
本文介绍在Python中通过算术运算1-b实现布尔值取反的技巧,并结合Redis队列处理MySQL大批量更新时的重试机制。详细解析了bool类型转换规则及False的判定标准,旨在通过自动化逻辑减少手动操作,提升代码健壮性与执行效率。
本文介绍使用 Selenium 控制浏览器的核心操作,包括自定义窗口尺寸、全屏显示、页面前进与后退以及刷新当前页。通过 Python 代码示例,展示如何调用 set_window_size、maximize_window、back、forward 和 refresh 等方法,帮助开发者实现浏览器自动化控制。
本文介绍如何利用 Python 和 OpenCV 库去除拍照图片中的背景。通过自适应阈值处理、形态学操作生成掩膜,结合位运算还原清晰图像,适用于文档扫描与自动化办公场景。
本文详解Python中eval函数的执行机制,重点解析globals与locals参数对命名空间的影响。通过代码示例展示如何控制变量作用域,并演示通过限制__builtins__来规避安全风险的方法。同时强调eval执行任意代码的潜在危险,建议在生产环境中使用ast.literal_eval进行安全评估。
本文详细介绍如何使用pandas库高效处理CSV文件。涵盖指定编码(如GBK)读取数据、日期字段类型转换、多列字符串拼接、基于符号的数值计算、数据分组聚合以及去重保存等核心操作步骤,帮助开发者快速完成数据清洗任务。
本文介绍如何使用Python将Word文档批量转换为HTML格式。通过安装python-docx和PyDocX库,利用os模块遍历目录,自动处理文件名空格问题,并循环调用转换函数生成对应的HTML文件。转换后的内容可直接存入数据库进行展示,适用于文档批量处理场景。
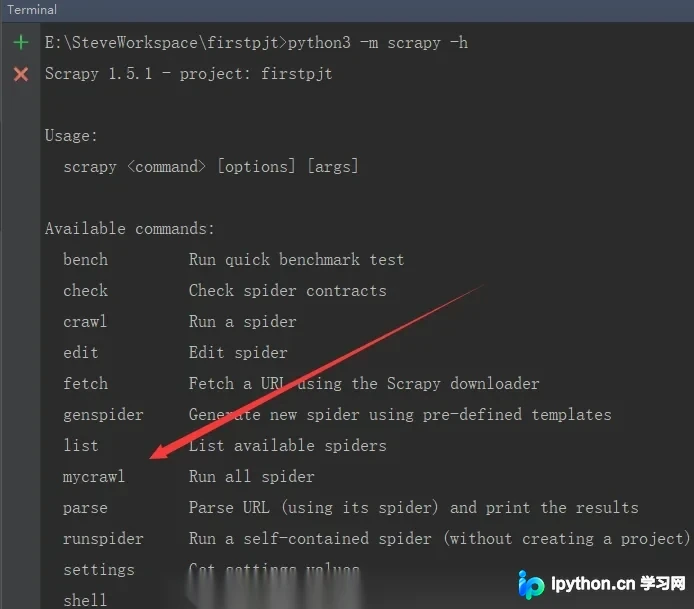
本文介绍Scrapy批量运行爬虫文件的两种实现方式:一是直接修改CrawProcess源码中的run()方法,遍历加载所有爬虫;二是通过创建自定义命令目录(mycmd)并继承修改源码,实现一键启动多个爬虫。详细步骤包括代码修改、目录结构配置及setting.py参数设置,帮助开发者高效管理多个爬虫任务。
本文介绍了在Python中修改文件时间属性的两种方法。第一种利用os模块的utime函数,可修改访问时间和修改时间,但无法修改创建时间。第二种利用win32file模块,可在Windows系统下同时修改文件的创建、修改和访问时间。文章提供了详细的代码示例和操作步骤,帮助开发者实现文件时间的精确控制。
本文介绍如何在Django项目中安全地将App名称及对应的数据库表名从大写改为小写。通过生成批量SQL语句直接修改MySQL表名,并配合修改代码中的模型引用、URL配置及Settings设置,实现无需执行Django migrate命令即可完成名称变更,确保ORM映射正确。
本文介绍如何使用 Python 内置的 wsgiref 模块快速搭建一个简易的 Web 服务器。通过定义符合 WSGI 规范的 application 函数,结合 make_server 创建监听服务,实现简单的 HTTP 请求处理。
本文介绍使用Python结合Selenium和TinyPNG接口实现图片批量无损压缩的方法。通过优化上传时机、采用多线程下载及遍历本地文件夹策略,显著提升处理效率。代码包含基础版与改进版,重点解决网络加载等待与并发下载问题,适用于Android项目等资源文件的自动化压缩场景。