

Python列表元素输出技巧:空格与逗号分隔符处理
本文介绍Python中输出列表元素的多种方法。通过for循环配合end参数可实现空格或逗号分隔,但需注意末尾多余符号。推荐使用join方法结合生成器表达式,可优雅地实现无末尾分隔符的标准输出格式,适用于空格或逗号分隔场景。
2026-10-13
23

本文介绍Python中输出列表元素的多种方法。通过for循环配合end参数可实现空格或逗号分隔,但需注意末尾多余符号。推荐使用join方法结合生成器表达式,可优雅地实现无末尾分隔符的标准输出格式,适用于空格或逗号分隔场景。
本文提供基于Kashgari库的Python代码,用于利用预训练Ner模型对Conll格式数据进行清洗与合并。核心逻辑包括读取原始数据,通过文本长度判断是否分块预测实体,最终将清洗后的文本与标签合并输出至目标文件,适用于需要批量处理序列标注数据的场景。
本文介绍如何在 Python 的 logging 模块中添加自定义 filter 以实现更灵活的日志过滤。通过示例展示了如何基于日志名称进行匹配过滤,以及如何结合 StreamHandler 对不同级别日志应用不同的过滤规则和输出格式,帮助开发者精确控制日志输出内容。
本文介绍如何利用Python内置的dir函数获取类中定义的方法列表。通过示例展示如何结合filter和lambda表达式,筛选出符合特定命名特征的方法,帮助开发者快速定位类接口。
本文详细解析Python中函数名打印与函数执行的区别,阐述return语句如何触发嵌套函数运行及返回值传递。通过多个实例说明当return内容为函数调用、常量或变量时的执行逻辑,并深入讲解高阶函数传参与赋值的执行过程,帮助开发者准确掌握Python函数返回与执行的底层机制。
本文详解Python文件操作核心知识,涵盖ASCII、GBK到UTF-8的字符编码演变及Python2与Python3的差异。深入解析r、w、a及t、b模式的组合用法,介绍with语句的文件上下文管理。重点对比全量加载与逐行处理两种文件修改方式,并系统讲解无参、有参及空函数的定义规范与应用场景。
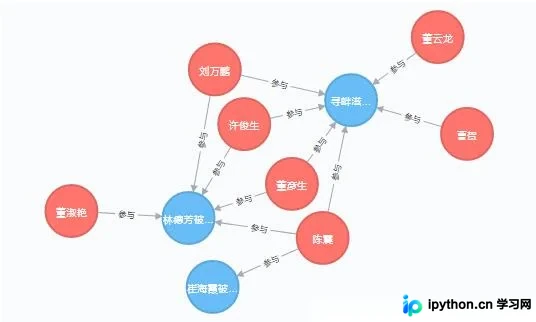
本文介绍如何使用Python连接Neo4j图数据库,通过Cypher语句查询满足特定条件的多人多案关联集合。核心逻辑是找出涉及3人及以上且关联案件数达到3起以上的节点组合,并利用py2neo库执行匹配与数据提取,最终将结果存入PostgreSQL数据库。
本文介绍如何利用Python内置的SimpleHTTPServer模块,在无需额外软件的情况下快速实现不同操作系统间的文件夹共享。通过简单的命令行操作,Linux或Windows主机均可将指定目录发布为Web服务,其他设备只需通过浏览器输入IP和端口即可访问文件,操作简单且无需区分主从角色。
本文详细解析Python中两个常用的分割函数:split()与os.path.split()。split()通过指定分隔符拆分字符串,支持自定义分隔次数及索引选取,能处理空格、换行等默认分隔符;os.path.split()用于分离文件路径与文件名,以最后一个斜杠为界返回元组。文章提供具体语法、参数说明及代码示例,帮助开发者掌握字符串与路径的高效处理方法。
本文详细介绍如何使用 Python 连接并消费 Kafka 数据。内容涵盖 kafka-python 模块安装、压缩依赖处理、生产者发送消息示例,以及基于 KafkaConsumer 的消费者实现。重点讲解如何通过多线程机制并行处理不同分区数据,提升消费效率,并提供完整代码参考与官方文档链接。
本文总结 Python 脚本的三种主要执行方式:交互模式、脚本文件执行以及指定解释器的可执行文件运行。详细讲解了在 Windows 和 Linux 环境下进入交互模式、退出方法及 Hello World 输出示例。对比了交互模式与脚本文件在结果打印和语句保存上的差异,并强调了使用正确文本编辑器避免 UTF-8 BOM 格式错误的重要性。
本文详解如何在Python中使用sys.argv接收命令行参数,并解决PyInstaller打包exe后参数传递失效的问题。重点对比-F与-w模式对标准输出的影响,提供通过os.popen调用exe并获取输出的完整代码示例,确保打包后的程序能正确接收和处理外部传入的参数。