Python 提取 PDF 图片的三种实用方法:fitz、pdf2image 与优化技巧
本文详细介绍使用 Python 从 PDF 文件中提取图片的三种方法。首先讲解基于 fitz 库结合正则表达式匹配图片对象,并通过 pix.size 阈值过滤小色块;其次介绍 pdf2image 库的安装配置及 convert_from_path 与 convert_from_bytes 两种转换方式;最后补充多线程加速技巧,帮助开发者高效、安全地批量处理 PDF 图片资源。
2026-10-14
23

本文详细介绍使用 Python 从 PDF 文件中提取图片的三种方法。首先讲解基于 fitz 库结合正则表达式匹配图片对象,并通过 pix.size 阈值过滤小色块;其次介绍 pdf2image 库的安装配置及 convert_from_path 与 convert_from_bytes 两种转换方式;最后补充多线程加速技巧,帮助开发者高效、安全地批量处理 PDF 图片资源。
本文详细介绍Python中经典排序算法的实现,包括冒泡、选择、插入、希尔、归并、快速、堆、计数、桶及基数排序。每种算法均提供核心代码逻辑与复杂度分析,帮助开发者深入理解算法原理并应用于实际开发场景。
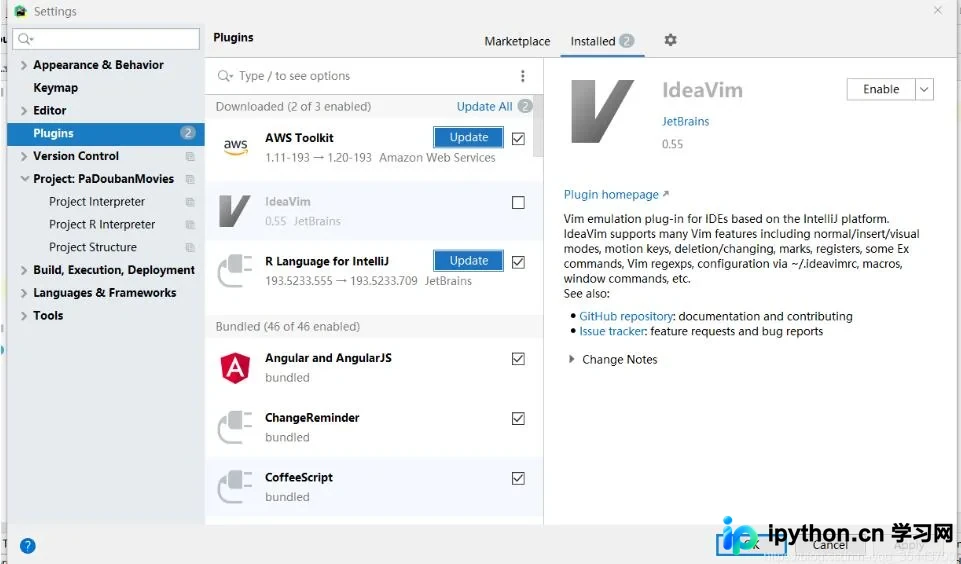
本文介绍PyCharm中光标意外变成黑块无法编辑代码的解决方案。该问题通常由误触Insert键切换至改写模式引起,可通过按Insert键或fn+Enter恢复插入模式。若无效,需检查并禁用ideaVim插件以恢复正常编辑功能。
本文介绍如何使用Python批量提取图片信息并保存。通过PIL库获取图片宽高、大小等信息,利用glob遍历文件夹,结合文件操作模式如“a+”追加写入,实现高效批量处理。
本文详细介绍5种基于Python生成个性化语音的方法,包括gtts、baidu-aip、pyttsx3、pywin32及speech模块。涵盖安装配置、代码示例及参数调整技巧,帮助开发者快速实现文字转音频功能,满足不同场景下的语音合成需求。
本文介绍在Django框架中利用xlwt库生成Excel文件的方法。通过统一维护字体、对齐及边框等样式,提升导出数据的美观度。文章提供了从创建Workbook到处理IO流返回响应的完整代码示例,适用于需要批量导出结构化数据的场景。
本文详细介绍Django模板引擎中for循环的高级用法,重点解析forloop对象的各个属性,包括forloop.counter、forloop.counter0、forloop.first、forloop.last及forloop.revcounter等。通过具体代码示例,展示如何实现空列表处理、正向/逆向遍历及循环状态判断,帮助开发者更高效地控制模板渲染逻辑。
本文详细介绍 Python 中 os.remove() 方法的语法、参数及返回值。重点解析其仅适用于删除文件、无法处理非空目录的特性,并通过代码实例演示正确用法及常见报错场景,帮助用户掌握文件清理的最佳实践。
本文演示了Python中NumPy数组与List相互转换的具体方法。通过np.array()函数可将List转换为NumPy数组,利用tolist()方法可将NumPy数组转为List。文章提供了代码示例,对比了list()函数构造新列表的区别,帮助开发者掌握基础数据类型转换技巧。
本文深入解析Python数据模型(即对象模型)的核心概念,详细阐述对象的三大要素:身份(identity)、类型(type)和值(value)。文章区分了强类型与动态类型的概念,解释了可变与不可变对象的内存行为,并探讨了Python垃圾回收机制及资源管理最佳实践,帮助开发者深入理解Python对象底层逻辑。
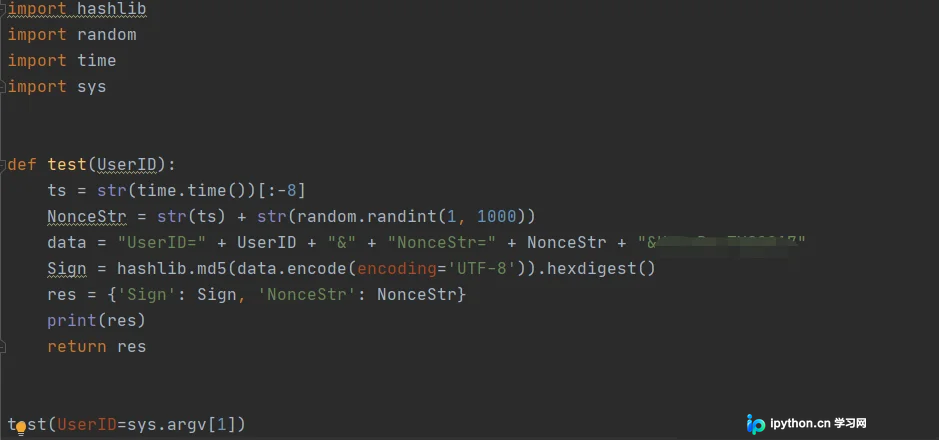
本文介绍在JMeter接口性能测试中,如何通过调用Python脚本自动生成符合特定规则的NonceStr和Sign参数。通过编写批处理文件并利用OS Process Sampler组件执行脚本,结合正则表达式提取结果,实现复杂加密逻辑的自动化处理,有效提升测试效率。
本文深入解析Python中插入排序算法的核心原理,通过将列表划分为有序区与无序区,逐步将元素插入正确位置。文章提供了基础实现代码及扩展实例,详细演示了从单元素有序区开始,逐个处理无序区元素直至排序完成的全过程,帮助开发者理解算法逻辑而非仅调用命令。