Python使用xlrd与xlwt合并Excel多Sheet的实现方法
本文介绍如何利用Python的xlrd和xlwt模块合并多个Excel文件中的多个Sheet。核心思路是将不同文件的相同Sheet内容视为列合并,再将不同Sheet内容视为行合并。通过遍历列表一次性写入数据,避免追加写入限制,最终生成包含所有源文件内容的单一Excel文件。
2026-10-14
23

本文介绍如何利用Python的xlrd和xlwt模块合并多个Excel文件中的多个Sheet。核心思路是将不同文件的相同Sheet内容视为列合并,再将不同Sheet内容视为行合并。通过遍历列表一次性写入数据,避免追加写入限制,最终生成包含所有源文件内容的单一Excel文件。
本文详细解析Python中7种字符串拼接方法,包括直接加号、join、format、百分号、多行括号、Template及F-strings。重点对比各方法在内存分配、执行效率及适用场景上的差异,推荐Python 3.6+使用F-strings以获得最佳性能与代码可读性。
本文详细介绍Python3中整数反转的多种实现方式。涵盖将数字转为字符串翻转、纯数学取余取整、栈模拟及切片操作等方法。重点解析如何处理负号、前导零以及32位有符号整数溢出边界[-2^31, 2^31-1],并提供完整代码示例与测试用例,帮助开发者深入理解算法逻辑与性能差异。
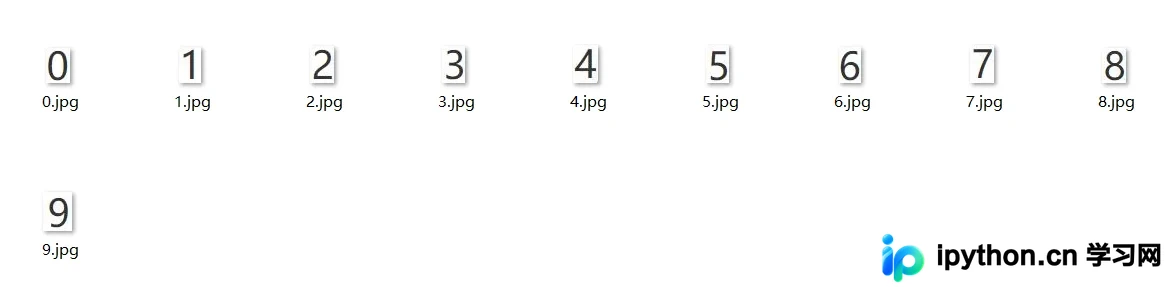
本文详细介绍如何使用Python和OpenCV实现基于模板匹配的图片数字识别。通过灰度化、二值化、形态学操作及轮廓筛选等步骤,精准定位并提取数字区域。文章包含完整的代码解析、环境配置说明及输出示例,帮助开发者掌握图像预处理与模板匹配的核心技术。
本文详解如何在 Flask 应用中通过 threading.local 存储 logid,并利用 logging 模块的 Filter 功能自动将 logid 注入日志输出。方案使用 uuid.uuid1().time 生成趋势递增的唯一标识,无需手动修改每个日志打印点,实现请求上下文的自动关联与问题定位。
本文介绍使用Python的pandas、xlrd和openpyxl库合并Excel文件中指定Sheet的方法。重点解决合并后出现的列顺序错乱及自动生成Unnamed:0列的问题,通过设置header=None、index_col=0和index=False等参数实现数据正确合并与保存。
本文详细介绍 Python Jinja2 模板引擎的核心用法。涵盖控制结构、变量取值与注释语法,解析 for 循环及字典迭代技巧。系统梳理 capitalize、lower 等常用过滤器功能,并深入讲解 PackageLoader 与 FileSystemLoader 两种加载方式及 Environment 类的配置方法,帮助开发者高效实现配置文件动态渲染。
本文详解Python中tempfile模块的安全用法,重点分析mktemp的不安全性及软链接劫持风险。通过对比不安全示例与正确代码,介绍mkstemp、TemporaryFile和NamedTemporaryFile的正确使用场景及清理机制,确保临时文件操作的系统安全。
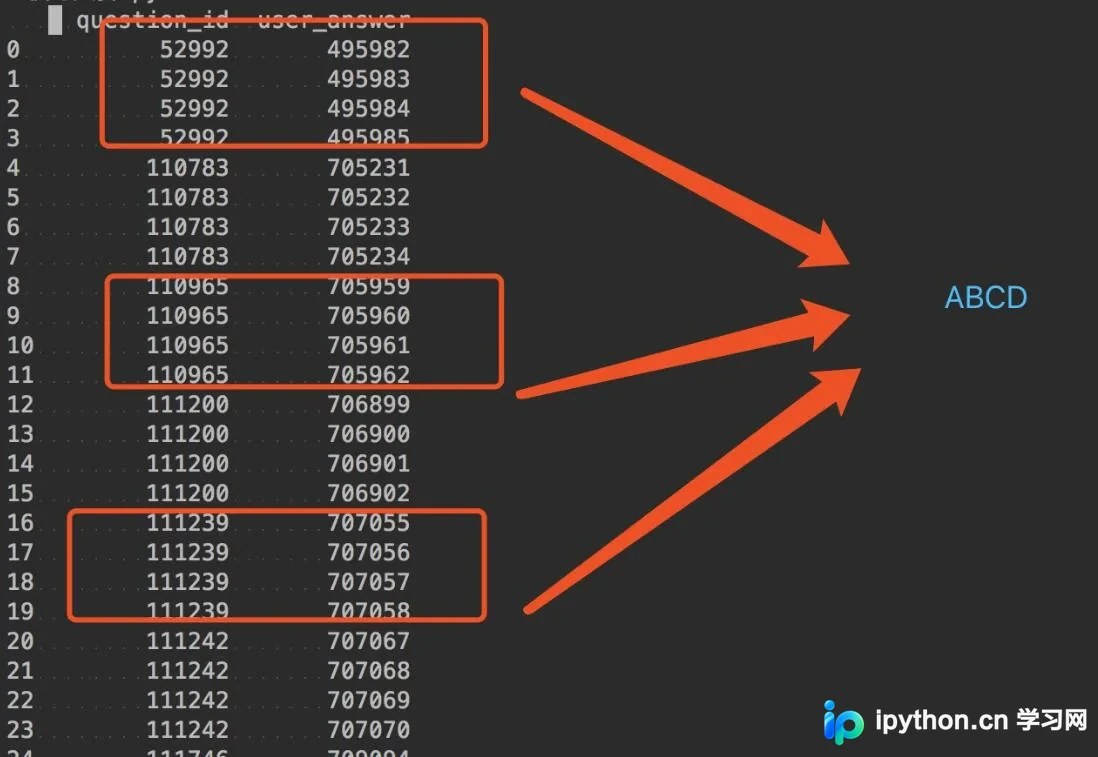
本文介绍如何利用pandas实现分组后提取第N行数据,并通过示例将question_id对应的user_answer转换为ABCD选项。同时详细解析nlargest()函数的用法,包括获取最大前几行、处理重复值及分组求和等场景,帮助读者掌握高效的数据筛选技巧。
本文介绍如何使用Python编写小程序,将学术文献的BibTeX格式自动转换为标准的IEEE引用格式。通过解析百度学术或谷歌学术导出的BibTeX数据,程序可处理会议论文与期刊论文,支持自动提取作者、标题、会议/期刊名、卷期号及页码等信息,并生成符合IEEE规范的引用字符串,有效避免手动排版错误。
本文详解Python OpenCV中高斯金字塔与拉普拉斯金字塔的实现原理。通过cv2.pyrDown和cv2.pyrUp函数演示图像的下采样与上采样过程,分析尺寸需为2的整次幂的限制。重点介绍利用拉普拉斯金字塔进行图像细节还原的方法,解决常规上下采样的有损模糊问题,并附带完整代码示例。
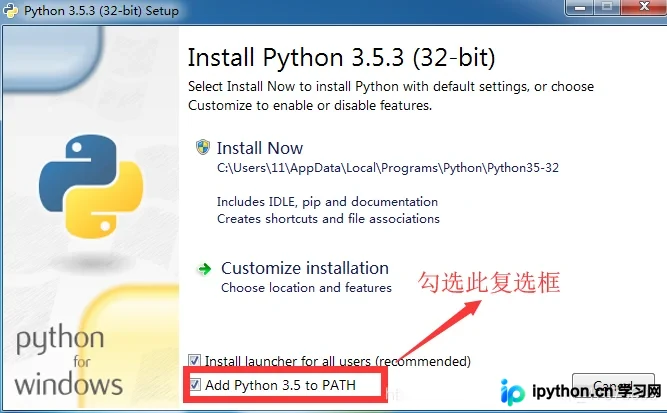
本文详细介绍 Python 3.5.3 的安装步骤,包括环境变量配置与自定义安装选项。同时提供第三方库(如 jieba 和 PyInstaller)的自动化安装脚本使用说明,涵盖在线与离线环境下的依赖处理方案,并给出无法安装时的 Python 3.4.3 备选方案,帮助用户顺利完成开发环境搭建。