

Python实现可选题阶数字华容道游戏(含3/4/5阶)
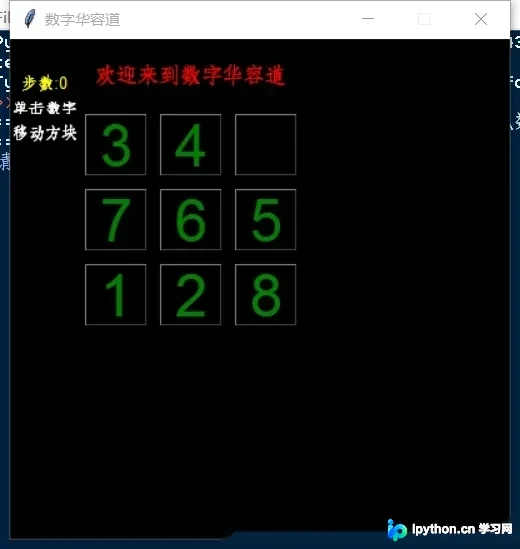
本文介绍如何使用Python的tkinter模块和random模块制作支持3、4、5阶的数字华容道游戏。程序通过命令行选择关卡难度,动态生成按钮网格,实现点击交换与胜利判定逻辑,并实时显示步数。
2026-10-14
23

本文介绍如何使用Python的tkinter模块和random模块制作支持3、4、5阶的数字华容道游戏。程序通过命令行选择关卡难度,动态生成按钮网格,实现点击交换与胜利判定逻辑,并实时显示步数。
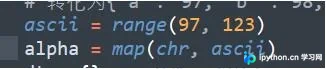
本文介绍如何将Python中形如[{'a': 97}, {'b': 98}]的列表嵌套字典转换为单一字典。通过结合range生成字母序列,利用map函数构建初始列表,再借助字典的items()方法提取键值对,最后通过双重循环遍历合并至新字典,实现数据结构的扁平化处理。
本文详细解析Python3中使用sqlite3进行数据库连接、建表、数据插入及查询的完整流程。重点讲解如何正确使用参数化查询防止SQL注入,并针对自增字段起始位置重置提供具体解决方案。文章通过代码示例展示了从基础连接到高级查询的实战技巧,帮助开发者规避常见语法陷阱。
本文深入解析Python解决“小明种苹果”问题的多种实现方式,重点探讨环形数组中连续三棵树掉落情况的统计方法。通过对比索引取余、列表拼接及直接遍历等策略,提供一种从列表尾部开始读取的简洁代码方案,并附带其他常见解法供参考,旨在帮助开发者更高效地处理此类边界条件复杂的算法题。
本文介绍如何使用Python语言结合广度优先搜索(BFS)算法解决经典的八数码(九宫格)难题。通过定义状态类、生成子状态及路径回溯,实现从初始布局到目标布局的最少步数寻优,提供完整的代码逻辑与运行示例。
本文详细介绍Python中Num库对文本文件、CSV格式及二进制文件的读写操作。通过savetxt与loadtxt函数实现TXT/CSV数据的存取,利用save、savez及load函数处理.npy与.npz二进制格式,涵盖参数配置、编码设置及多数组存储等核心功能。
本文通过Python代码实验,探讨共轭梯度法(CG)在求解线性方程组时,迭代次数与矩阵特征值分布的关系。实验对比了特征值完全聚堆、分散及不同精度下的聚堆情况,结果表明:当特征值差异小于迭代精度时,可视为聚堆,迭代次数近似等于独立特征值簇的数量。
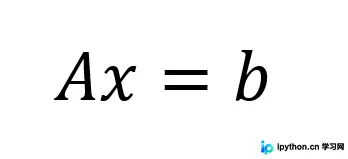
本文针对500万行级别的大规模数据,系统对比了Pandas中iloc、at、apply及Series直接处理的速度差异。实测显示,iloc耗时约5小时,at优化至10分钟,而转为Series处理仅需37秒。此外,文章通过数值实验深入剖析了loc、at、iloc、iat及直接访问values数组在读取与修改场景下的性能表现,指出直接获取二维数组再定位是最高效方案,并提供了相应的代码实现与优化建议。
本文详解Pandas中提取单个单元格值的两种方法。使用iloc返回DataFrame对象,而values属性返回嵌套列表。通过示例展示如何结合索引与values[0][0]获取纯数值,并解决将Series写入Excel时的类型报错问题,提供实用的代码参考。
本文详细介绍在Windows环境下使用Python 3.6.8生成随机数的方法。涵盖随机整数(含偶数选取)、随机浮点数、单个随机字符及指定长度的随机字符串生成。通过random模块的randint、randrange、choice和sample等函数,结合具体代码示例,帮助开发者快速掌握Python随机数据生成技巧。
本文介绍如何利用Python的xlrd和xlwt模块合并多个Excel文件中的多个Sheet。核心思路是将不同文件的相同Sheet内容视为列合并,再将不同Sheet内容视为行合并。通过遍历列表一次性写入数据,避免追加写入限制,最终生成包含所有源文件内容的单一Excel文件。
本文详细解析Python中7种字符串拼接方法,包括直接加号、join、format、百分号、多行括号、Template及F-strings。重点对比各方法在内存分配、执行效率及适用场景上的差异,推荐Python 3.6+使用F-strings以获得最佳性能与代码可读性。